[Python] ML-QDA
1. 왜 등장했는가
LDA는 “모든 클래스의 데이터가 같은 모양(공분산) 으로 퍼져 있다”고 가정하기 때문에 결정 경계가 항상 직선(초평면) 입니다.
하지만 실제로는 한 클래스는 넓게 퍼져 있고 다른 클래스는 좁게 모여 있는 경우가 흔합니다.
QDA(Quadratic Discriminant Analysis)는 클래스마다 공분산을 따로 추정해, 곡선(2차) 결정 경계를 만드는 확률적 분류기입니다.
LDA가 “모든 반에 같은 크기의 교복을 입히는” 모델이라면,
QDA는 “반마다 체형에 맞춰 교복을 따로 맞추는” 모델에 가깝습니다.
2. 핵심 아이디어 — “클래스마다 퍼진 모양이 다르다”
QDA는 본질적으로 각 클래스를 서로 다른 모양의 정규분포(타원)로 모델링한 뒤, 새 데이터가 어느 타원에 더 잘 맞는지 비교합니다.
1
2
3
4
5
6
7
정상 거래 vs 사기 거래 (특성: 거래 금액, 거래 시각)

정상 거래:  금액은 1~10만 원 사이에 좁게, 시각은 낮 시간대에 넓게 분포
사기 거래:  금액이 수십만 원까지 넓게, 시각은 새벽에 몰려 있음

LDA:  두 클래스가 같은 모양이라고 가정 → 직선 경계 → 새벽 소액 거래를 잘못 분류
QDA:  클래스마다 타원 모양을 따로 학습 → 곡선 경계 → 두 분포의 모양 차이까지 반영 ✅
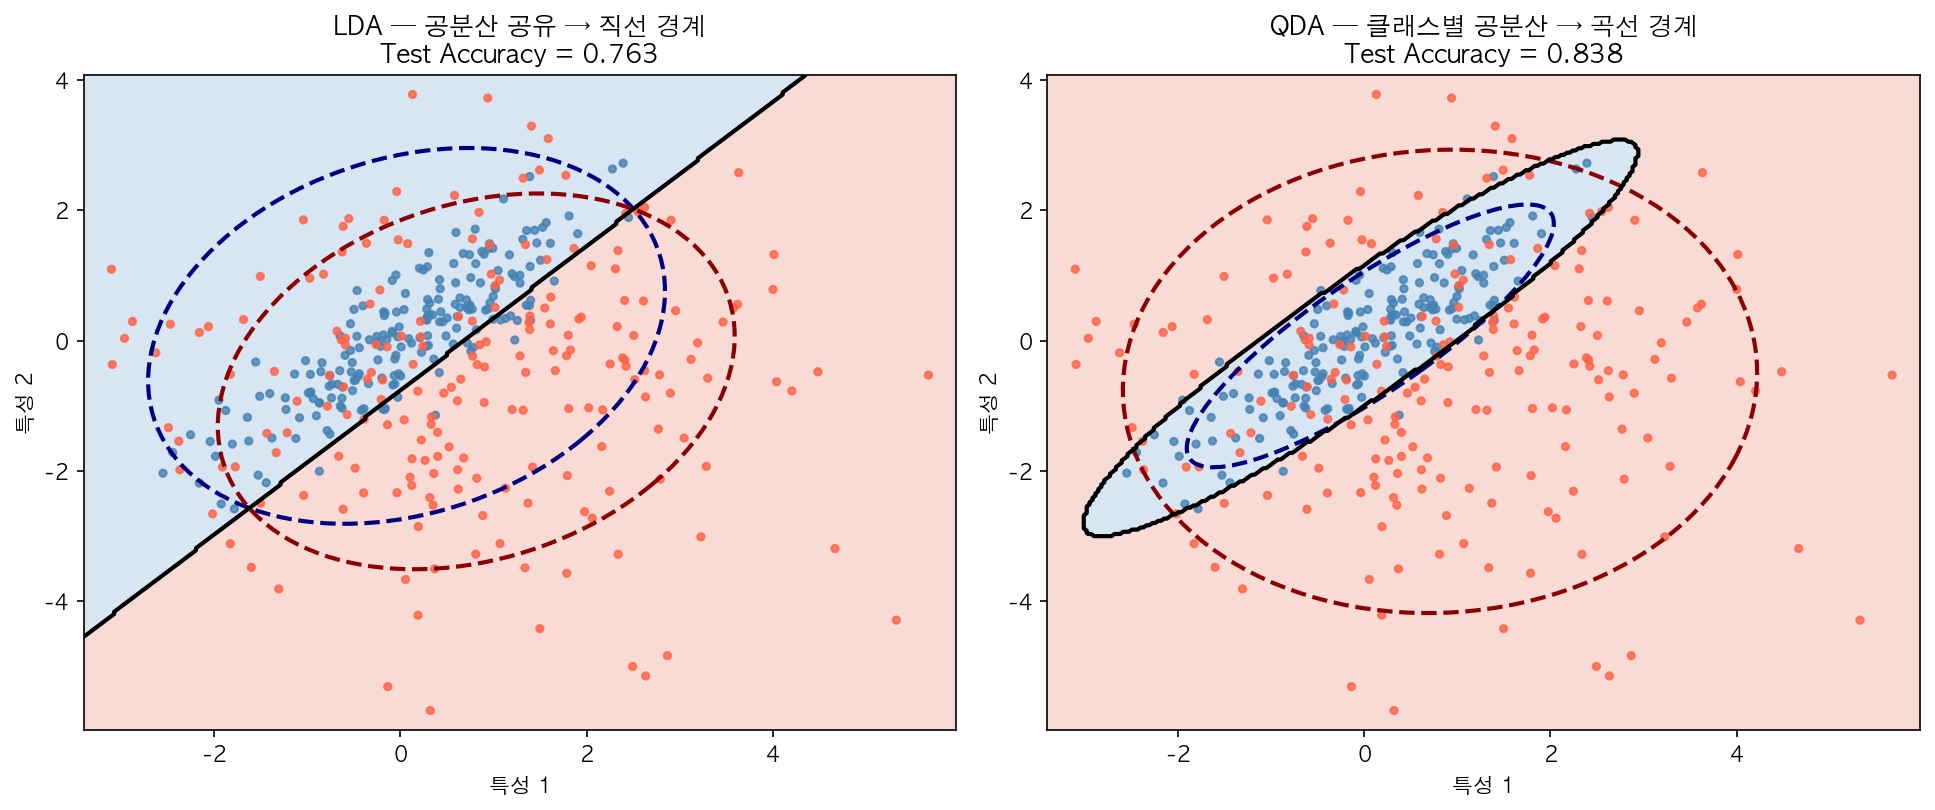
읽는 법:
파란 클래스는 좁고 비스듬한 타원, 빨간 클래스는 넓고 둥근 타원 모양으로 퍼진 데이터입니다. 점선 타원은 각 모델이 추정한 클래스 분포입니다.
왼쪽 (LDA) — 두 클래스의 공분산을 하나로 합쳐 추정하므로 타원 모양이 똑같고, 경계(검은 선)가 직선입니다.
오른쪽 (QDA) — 클래스마다 타원을 따로 추정하므로 파란 클래스를 감싸는 곡선 경계가 만들어지고, 정확도도 더 높습니다.
3. 실제 예시로 보기 (분류)
예시 1 — 타이타닉 생존 예측 (분류)
1
2
3
4
5
사망자 그룹:  요금(Fare)이 낮은 쪽에 좁게 몰려 있음 (대부분 3등석)
생존자 그룹:  요금이 낮은 값부터 500달러까지 넓게 퍼져 있음 (1~3등석 혼재)

→ 두 그룹의 분산이 크게 다름 → LDA 가정 위반
→ QDA는 "생존자는 요금 분산이 크다"는 정보 자체를 분류에 활용
예시 2 — 의료 진단 (분류)
1
2
3
4
5
6
7
8
특성: 혈당, BMI

건강 그룹:  혈당 80~110 사이에 좁게 분포, 혈당과 BMI의 상관 약함
당뇨 그룹:  혈당 120~300까지 넓게 분포, BMI가 높을수록 혈당도 높은 강한 상관

QDA: 클래스별 공분산 행렬에 "분산 크기"와 "특성 간 상관"을 모두 담음
     → 건강 그룹 = 작고 둥근 타원, 당뇨 그룹 = 크고 기울어진 타원
     → 두 타원이 만나는 곡선이 결정 경계
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
     ┌────────────────────────────────────────┐
     │   클래스별 사전 확률 P(y=k) 계산          │  ← 클래스 비율
     └──────────────────┬─────────────────────┘
                        │
                        ▼
     ┌────────────────────────────────────────┐
     │   클래스별 평균 벡터 μₖ 계산               │  ← 타원의 중심
     └──────────────────┬─────────────────────┘
                        │
                        ▼
     ┌────────────────────────────────────────┐
     │   클래스별 공분산 행렬 Σₖ 계산 (따로!)     │  ← 타원의 모양·방향
     │   (LDA는 모든 클래스가 Σ 하나를 공유)      │
     └──────────────────┬─────────────────────┘
                        │
                        ▼
     ┌────────────────────────────────────────┐
     │   판별 함수 δₖ(x) 계산 → 가장 큰 클래스    │  ← x의 2차식 → 곡선 경계
     └────────────────────────────────────────┘
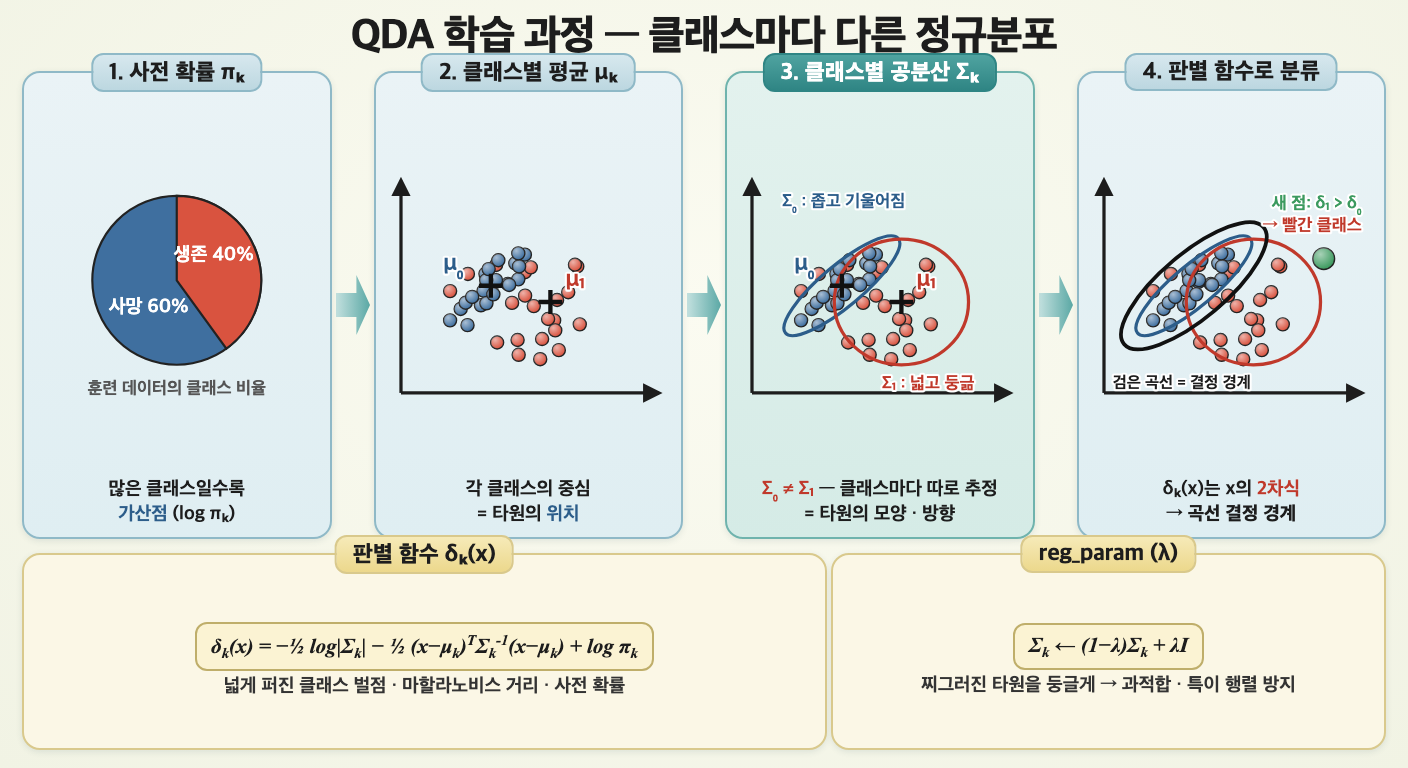
읽는 법:
QDA가 학습하는 세 가지(사전 확률·평균·공분산)와 분류 방식을 왼쪽부터 순서대로 그린 그림입니다.
1 — 훈련 데이터의 클래스 비율(사망 60%, 생존 40%)이 사전 확률 πₖ가 됩니다.
2 — 클래스마다 평균 μₖ(십자 표시)를 구합니다.
3 (핵심) — 클래스마다 공분산 Σₖ를 따로 구합니다. 파란 클래스는 좁고 기울어진 타원, 빨간 클래스는 넓고 둥근 타원입니다. LDA라면 두 타원이 같은 모양이었을 것입니다.
4 — 판별 함수 δₖ(x)가 x의 2차식이라 결정 경계(검은 곡선)가 파란 클래스를 감싸는 곡선이 됩니다. 경계 밖의 새 점(초록)은 빨간 클래스로 분류됩니다.
아래 칸은 판별 함수 수식과, 공분산을 안정화하는 reg_param입니다.
| 구성 요소 | 설명 | 비유 |
|---|---|---|
| 사전 확률 P(y=k) | 클래스별 비율 | 전체 승객 중 생존자 비율 |
| 평균 μₖ | 클래스별 특성 평균 | 생존자의 평균 나이·요금 |
| 공분산 Σₖ | 클래스별 퍼짐 정도·방향 | 생존자 데이터가 퍼진 타원 모양 |
| reg_param | 공분산 정규화 | 너무 찌그러진 타원을 둥글게 보정 |
5. 어떻게 분류하는가
5-1. 판별 함수 (Discriminant Function)
\[\delta_k(x) = -\frac{1}{2}\log|\Sigma_k| - \frac{1}{2}(x - \mu_k)^T \Sigma_k^{-1}(x - \mu_k) + \log P(y=k)\]1
2
3
4
5
6
7
8
9
10
세 항의 의미:
-½ log|Σₖ| : 분포가 넓게 퍼진 클래스에 대한 벌점
(넓게 퍼질수록 한 점에서의 확률 밀도가 낮아짐)
-½ (x-μₖ)ᵀ Σₖ⁻¹ (x-μₖ) : 클래스 중심까지의 마할라노비스 거리
(타원 모양을 고려한 거리)
log P(y=k) : 많은 클래스일수록 가산점
→ δₖ(x)가 가장 큰 클래스로 분류
→ (x-μₖ)ᵀ Σₖ⁻¹ (x-μₖ) 항이 x의 2차식이므로 경계가 곡선 (Quadratic)
5-2. LDA는 QDA의 특수한 경우
1
2
3
4
5
6
QDA: 클래스마다 Σₖ가 다름 → 두 판별 함수를 빼도 x의 2차항이 남음 → 곡선 경계
LDA: 모든 클래스가 Σ 공유  → 빼면 xᵀΣ⁻¹x 항이 상쇄되어 1차항만 남음 → 직선 경계

  δ₁(x) - δ₀(x) = xᵀ(Σ₀⁻¹ - Σ₁⁻¹)x/2 + (1차항) + 상수
                  └──────────────┘
                   LDA에서는 Σ₀ = Σ₁ → 0
5-3. 파라미터 수와 정규화 (reg_param)
\[\hat\Sigma_k^{reg} = (1 - \lambda)\,\hat\Sigma_k + \lambda I\]1
2
3
4
5
6
7
8
9
10
11
12
특성 p개, 클래스 K개일 때 추정해야 할 공분산 파라미터 수:
LDA: p(p+1)/2 (공분산 1개)
QDA: K × p(p+1)/2 (공분산 K개)
p = 10, K = 3 → LDA: 55개 / QDA: 165개
p = 100, K = 3 → LDA: 5,050개 / QDA: 15,150개
→ 클래스별 샘플이 적으면 Σₖ 추정이 불안정 (특히 역행렬)
→ reg_param(λ)으로 공분산을 단위행렬 쪽으로 당겨 안정화
λ = 0 : 순수 QDA
λ = 1 : 공분산 = I (모든 특성 독립·같은 분산 → 거리 기반 분류에 가까워짐)
6. QDA 장・단점
6-1. ✅ QDA 장점
1
2
3
4
5
6
7
8
9
10
11
1. 곡선 결정 경계
   → 클래스마다 분산·상관 구조가 다를 때 LDA보다 정확

2. 학습이 매우 빠름
   → 평균과 공분산만 계산하면 끝 (반복 최적화 없음)

3. 확률 출력
   → 정규분포 기반이라 predict_proba가 자연스럽게 계산됨

4. 하이퍼파라미터가 거의 없음
   → reg_param 하나만 조정
6-2. ❌ QDA가 약한 상황
1
2
3
4
5
6
7
8
9
1. 특성이 많고 샘플이 적을 때
   → 클래스별 공분산 파라미터가 폭증 → 과적합, 공분산 역행렬 불안정

2. 정규분포 가정 위반
   → 이진·범주형 특성(원-핫 인코딩)은 정규분포가 아님
   → 특정 클래스 안에서 값이 상수인 특성이 있으면 공분산이 특이(singular)해짐

3. 클래스 분산이 실제로 비슷할 때
   → 추가 파라미터만 늘어나 LDA보다 오히려 성능 저하
6-2-1. 공분산 행렬이 특이(Singular)해지는 문제
QDA의 가장 큰 약점입니다.
1
2
3
4
5
6
7
타이타닉 예시: Embarked_Q (퀸스타운 승선 여부, 0/1)

생존자 중 Embarked_Q = 1 인 사람이 매우 적음
→ 생존자 클래스 안에서 이 특성의 분산 ≈ 0
→ Σ_생존 의 행렬식 ≈ 0 → 역행렬 계산 불가
→ sklearn 경고: "Variables are collinear"
→ 예측 확률이 0 또는 1로 극단화
해결책 :
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
from sklearn.discriminant_analysis import QuadraticDiscriminantAnalysis
from sklearn.model_selection import GridSearchCV

# 방법 1: reg_param으로 공분산 정규화
qda = QuadraticDiscriminantAnalysis(reg_param=0.1)

# 방법 2: 교차 검증으로 최적 reg_param 탐색
qda_cv = GridSearchCV(
    QuadraticDiscriminantAnalysis(),
    {'reg_param': [0.0, 0.01, 0.05, 0.1, 0.3, 0.5, 0.7, 0.9]},
    cv = 5,
    scoring = 'roc_auc'
)

# 방법 3: 연속형 특성만 사용하거나, PCA로 차원을 줄인 뒤 QDA 적용
7. 한눈에 요약
| 항목 | 내용 |
|---|---|
| 알고리즘 유형 | 지도학습 / 분류 (생성 모델) |
| 핵심 아이디어 | 클래스마다 다른 정규분포(평균·공분산) → 2차 결정 경계 |
| 핵심 가정 | 각 클래스의 특성이 다변량 정규분포를 따름 |
| LDA와 차이 | LDA는 공분산 공유(직선 경계), QDA는 클래스별 공분산(곡선 경계) |
| 스케일링 필요? | ❌ 이론상 불필요 / ✅ reg_param 사용 시 권장 |
| 핵심 파라미터 | reg_param |
| 실전 사용 | 연속형 특성 위주·클래스별 분산이 다른 데이터, 샘플이 충분할 때 |
8. 다른 알고리즘과 무엇이 다른가
LDA vs QDA vs Gaussian Naive Bayes
1
2
3
4
5
6
7
8
세 모델 모두 "클래스별 정규분포"를 가정하는 생성 모델

LDA:          모든 클래스가 공분산 Σ 하나를 공유         → 직선 경계
QDA:          클래스마다 공분산 Σₖ (특성 간 상관 포함)    → 곡선 경계
Gaussian NB:  클래스마다 대각 공분산 (특성 간 상관 = 0)   → 곡선 경계

유연성:  LDA  <  Gaussian NB  ≈  QDA (상관까지 고려하면 QDA가 가장 유연)
파라미터: LDA  <  Gaussian NB  <  QDA
| 항목 | LDA | QDA | Gaussian NB |
|---|---|---|---|
| 공분산 | 공유 (1개) | 클래스별 (K개) | 클래스별 대각 |
| 결정 경계 | 직선 | 곡선 | 곡선 |
| 특성 상관 반영 | ✅ | ✅ | ❌ |
| 필요 샘플 수 | 적음 | 많음 | 적음 |
| 차원 축소 | ✅ 가능 | ❌ | ❌ |
9. 코드로 보기 — 타이타닉 생존 예측
1
2
3
4
5
6
7
from sklearn.discriminant_analysis import QuadraticDiscriminantAnalysis

qda = QuadraticDiscriminantAnalysis(
    reg_param = 0.1,         # 공분산 정규화 강도 (0 ~ 1)
    priors = None,           # 사전 확률 (None이면 훈련 데이터 비율)
    store_covariance = True  # 클래스별 공분산 행렬 저장
)
| Parameter | Default | 역할 | 과적합 방향 |
|---|---|---|---|
reg_param | 0.0 | 클래스별 공분산 정규화 | 작을수록 과적합 ↑ |
priors | None | 클래스 사전 확률 | - |
store_covariance | False | covariance_ 속성 저장 여부 | - |
tol | 1e-4 | 특이값 판정 기준 (rank 경고) | - |
reg_param: 가장 중요한 파라미터- 값 변화별 효과
- 클수록 → 공분산이 단위행렬에 가까워짐 → 단순한 경계, 과적합 ↓
- 작을수록 → 클래스별 공분산을 그대로 사용 → 복잡한 경계, 과적합 ↑
- 원-핫 특성이 있거나 샘플이 적다면 0.01 이상으로 설정 권장
- 단위행렬 쪽으로 당기므로 특성 스케일이 같아야 정규화가 공평하게 적용됨 → 스케일링 권장
- 값 변화별 효과
priors: 클래스 사전 확률- 불균형 데이터에서 소수 클래스의 사전 확률을 높여 재현율(Recall)을 올릴 수 있음
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

titanic = pd.read_csv('./Data/Titanic.csv')
titanic['FamSize'] = titanic['SibSp'] + titanic['Parch']

use_cols = ['Survived', 'Pclass', 'Sex', 'Age', 'FamSize', 'Fare', 'Embarked']
titanic = titanic[use_cols].dropna(subset=['Age'])
titanic['Age'] = titanic['Age'].astype(int)
titanic = pd.get_dummies(titanic, columns=['Pclass', 'Sex', 'Embarked'], drop_first=True)

y = titanic['Survived']
X = titanic.drop('Survived', axis=1)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=0)

# ✅ reg_param이 공분산을 단위행렬 쪽으로 당기므로 스케일을 맞춰 둠
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test  = scaler.transform(X_test)
Note:
reg_param = 0인 순수 QDA는 스케일링에 영향을 받지 않습니다.
하지만reg_param > 0이면 모든 특성의 분산에 같은 값을 섞기 때문에, 스케일이 다르면 특성마다 정규화 효과가 달라집니다.
9-2. 모델 학습
1
2
3
4
qda = QuadraticDiscriminantAnalysis(reg_param=0.1, store_covariance=True)
qda.fit(X_train, y_train)

print(f"클래스 사전 확률 : {qda.priors_.round(3)}")
9-2-1. 교차 검증으로 최적 reg_param 탐색
1
2
3
4
5
6
7
8
9
10
11
from sklearn.model_selection import GridSearchCV

qda_cv = GridSearchCV(
    QuadraticDiscriminantAnalysis(),
    {'reg_param': [0.0, 0.01, 0.05, 0.1, 0.3, 0.5, 0.7, 0.9]},
    cv = 5,
    scoring = 'roc_auc'
)
qda_cv.fit(X_train, y_train)
print(f"Best reg_param : {qda_cv.best_params_['reg_param']}")
print(f"Best AUC       : {qda_cv.best_score_:.4f}")
9-3. 평가
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
from sklearn.metrics import (
    accuracy_score, confusion_matrix,
    classification_report, roc_auc_score
)

pred      = qda.predict(X_test)
pred_prob = qda.predict_proba(X_test)[:, 1]

cfx         = confusion_matrix(y_test, pred)
sensitivity = cfx[1, 1] / (cfx[1, 0] + cfx[1, 1])
specificity = cfx[0, 0] / (cfx[0, 0] + cfx[0, 1])
roc_auc     = roc_auc_score(y_test, pred_prob)

print(f"Accuracy    : {accuracy_score(y_test, pred) * 100:.2f}%")
print(f"Sensitivity : {sensitivity * 100:.2f}%")
print(f"Specificity : {specificity * 100:.2f}%")
print(f"ROC AUC     : {roc_auc:.4f}")
print()
print(classification_report(y_test, pred, target_names=['Died (0)', 'Survived (1)']))
9-4. reg_param에 따른 성능 변화 (LDA와 비교)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import numpy as np
import matplotlib.pyplot as plt
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

reg_params = [0.0, 0.001, 0.01, 0.05, 0.1, 0.2, 0.3, 0.5, 0.7, 0.9, 1.0]
train_auc, test_auc = [], []
for r in reg_params:
    m = QuadraticDiscriminantAnalysis(reg_param=r).fit(X_train, y_train)
    train_auc.append(roc_auc_score(y_train, m.predict_proba(X_train)[:, 1]))
    test_auc.append(roc_auc_score(y_test, m.predict_proba(X_test)[:, 1]))

lda = LinearDiscriminantAnalysis().fit(X_train, y_train)
lda_auc = roc_auc_score(y_test, lda.predict_proba(X_test)[:, 1])

plt.figure(figsize=(8, 4.5))
plt.plot(reg_params, train_auc, 'o-', color='steelblue', lw=2, label='QDA Train AUC')
plt.plot(reg_params, test_auc, 's-', color='tomato', lw=2, label='QDA Test AUC')
plt.axhline(lda_auc, color='gray', ls='--', label=f'LDA Test AUC ({lda_auc:.3f})')
plt.xlabel('reg_param')
plt.ylabel('ROC AUC')
plt.title('QDA — reg_param에 따른 성능 변화')
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
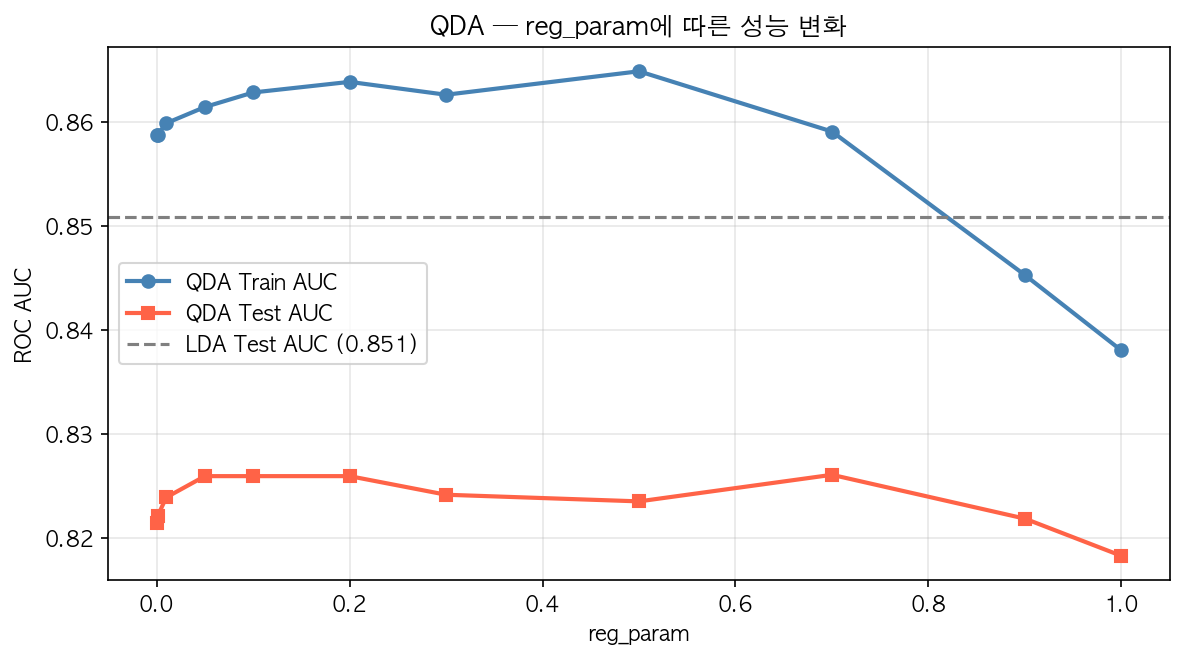
읽는 법:
파란 선은 훈련 AUC, 빨간 선은 테스트 AUC, 회색 점선은 같은 데이터에서의 LDA 테스트 AUC입니다.
훈련 AUC는 0.86 안팎인데 테스트 AUC는 0.82대에 머물러, LDA(0.851)보다 낮습니다.
reg_param을 0 → 0.05로 올리면 테스트 AUC가 0.822 → 0.826으로 소폭 개선되고, 1.0까지 키우면 클래스별 공분산 정보가 사라져 다시 떨어집니다.
타이타닉은 8개 특성 중 6개가 0/1 이진 특성이라 QDA의 정규분포 가정과 잘 맞지 않고, 늘어난 공분산 파라미터가 과적합만 키웁니다. 6-2에서 설명한 약점이 그대로 드러난 결과로, 이런 데이터에서는 LDA나 Logistic Regression이 더 적합합니다.
9-5. 연속형 특성으로 결정 경계 시각화
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
from matplotlib.colors import ListedColormap

# 연속형 특성 2개(Age, Fare)만 사용해 경계 모양 비교
cols = ['Age', 'Fare']
X2 = titanic[cols].copy()
X2['Fare'] = np.log1p(X2['Fare'])    # 치우친 요금 분포를 로그 변환
X2_train, X2_test, y2_train, y2_test = train_test_split(X2, y, test_size=0.25, random_state=0)

xx, yy = np.meshgrid(np.linspace(X2['Age'].min() - 2, X2['Age'].max() + 2, 300),
                     np.linspace(X2['Fare'].min() - 0.3, X2['Fare'].max() + 0.3, 300))
grid = np.c_[xx.ravel(), yy.ravel()]

fig, axes = plt.subplots(1, 2, figsize=(13, 5))
for ax, model, name in [(axes[0], LinearDiscriminantAnalysis(), 'LDA'),
                        (axes[1], QuadraticDiscriminantAnalysis(), 'QDA')]:
    model.fit(X2_train, y2_train)
    Z = model.predict_proba(pd.DataFrame(grid, columns=cols))[:, 1].reshape(xx.shape)
    ax.contourf(xx, yy, Z, levels=np.linspace(0, 1, 11), cmap='RdBu_r', alpha=0.4)
    ax.contour(xx, yy, Z, levels=[0.5], colors='black', linewidths=1.5)
    ax.scatter(X2_train['Age'], X2_train['Fare'], c=y2_train,
               cmap=ListedColormap(['steelblue', 'tomato']), s=12, alpha=0.7)
    auc = roc_auc_score(y2_test, model.predict_proba(X2_test)[:, 1])
    ax.set_title(f'{name} 결정 경계 (Test AUC = {auc:.3f})')
    ax.set_xlabel('Age'); ax.set_ylabel('log(1 + Fare)')
plt.tight_layout()
plt.show()
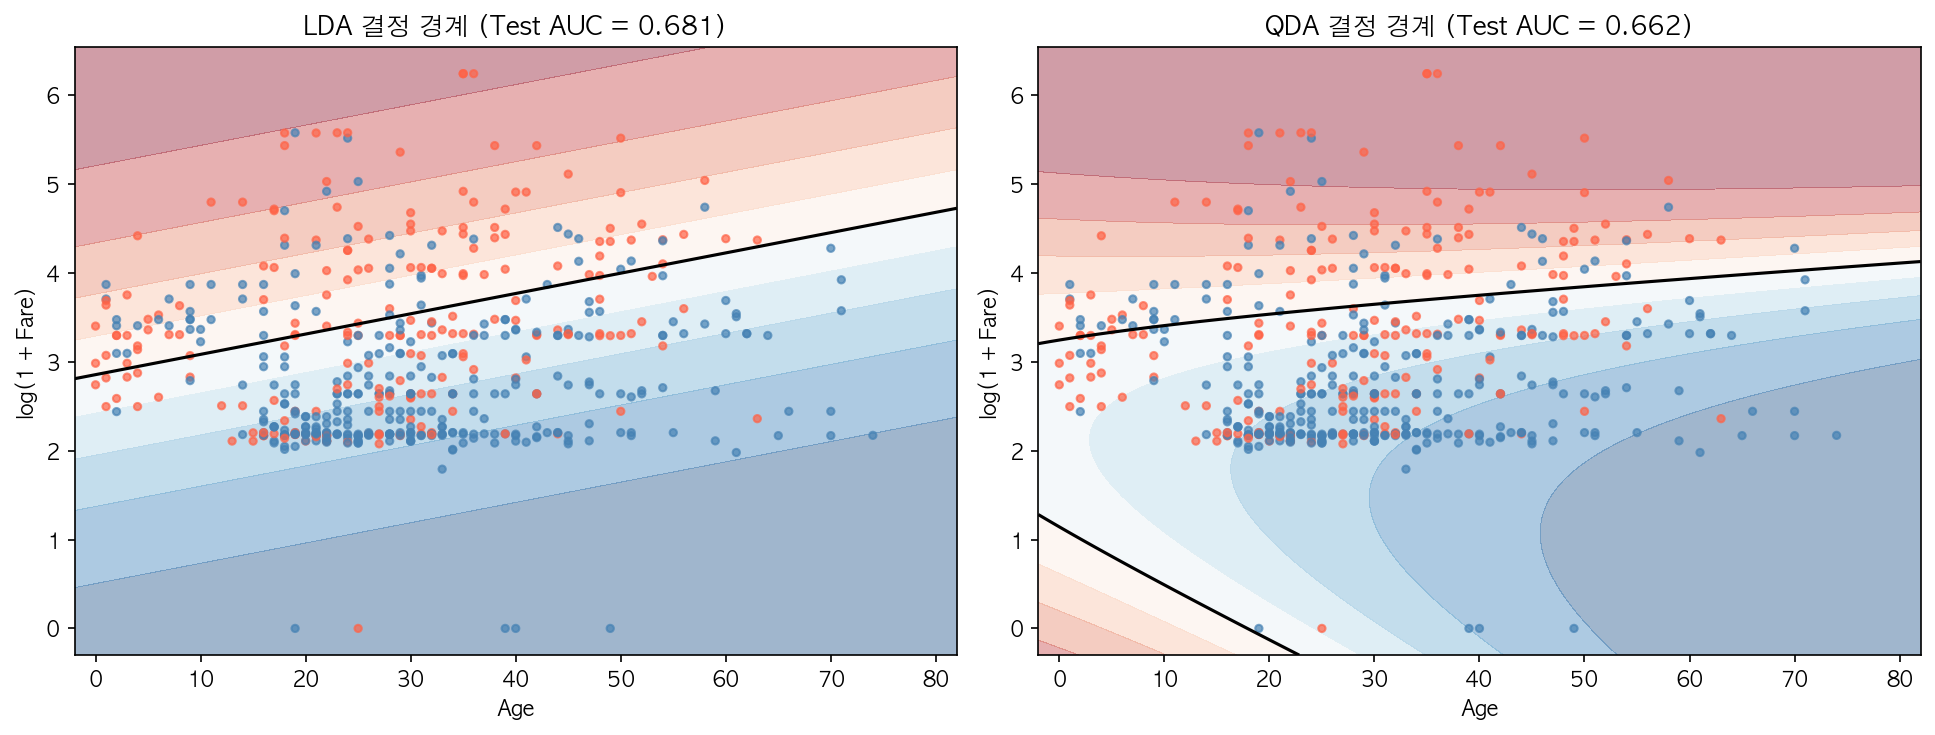
읽는 법:
파란 점은 사망자, 빨간 점은 생존자이며 검은 선이 생존 확률 50% 경계입니다.
LDA(왼쪽)는 직선 하나로 나누지만, QDA(오른쪽)는 두 클래스의 퍼진 모양 차이를 반영한 곡선 경계를 만듭니다.
QDA 그림 왼쪽 아래의 두 번째 경계선은, 생존자 분포가 더 넓게 추정된 탓에 데이터가 거의 없는 영역(요금 0 근처)까지 “생존”으로 예측하는 부분입니다. 데이터가 없는 곳에도 정규분포 모양을 그대로 확장하는 QDA의 특성입니다.
테스트 AUC는 LDA 0.681, QDA 0.662로 오히려 LDA가 높습니다. 곡선 경계가 항상 나은 것은 아니며, 두 클래스의 공분산이 실제로 크게 다르고 샘플이 충분할 때 QDA가 이득을 봅니다.