1. 왜 등장했는가
K-Means는 K를 미리 정해야 하고, 결과는 “K개의 군집” 한 가지뿐입니다.
하지만 생물 분류(종 → 속 → 과 → 목)나 조직도처럼 군집 안에 더 작은 군집이 들어 있는 계층 구조를 알고 싶을 때가 많습니다.
계층적 군집(Hierarchical Clustering)은 데이터를 가까운 것부터 차례로 합쳐 나무 구조(덴드로그램) 를 만들고, 원하는 높이에서 잘라 군집을 얻는 방법입니다.
K-Means가 “처음부터 K개 반으로 나누는” 방식이라면,
계층적 군집은 “가장 친한 둘씩 짝을 짓고, 그 짝끼리 또 짝을 지어 족보를 만드는” 방식입니다.
2. 핵심 아이디어 — “가장 가까운 두 군집을 하나씩 합친다”
병합형(Agglomerative) 계층적 군집은 본질적으로 모든 점을 각자 하나의 군집으로 시작해, 가장 가까운 두 군집을 합치는 일을 하나가 남을 때까지 반복합니다.
1
2
3
4
5
6
7
8
9
10
| 과일 5개: 사과, 배, 귤, 오렌지, 수박
시작: {사과} {배} {귤} {오렌지} {수박} ← 군집 5개
1단계: 귤과 오렌지가 가장 비슷 → {귤, 오렌지} ← 군집 4개
2단계: 사과와 배가 가장 비슷 → {사과, 배} ← 군집 3개
3단계: 두 과일 그룹이 합쳐짐 → {사과, 배, 귤, 오렌지} ← 군집 2개
4단계: 수박까지 합쳐짐 → {전체} ← 군집 1개
→ 합쳐진 순서와 거리를 나무 모양으로 기록 = 덴드로그램
→ 덴드로그램을 원하는 높이에서 자르면 원하는 개수의 군집
|
읽는 법:
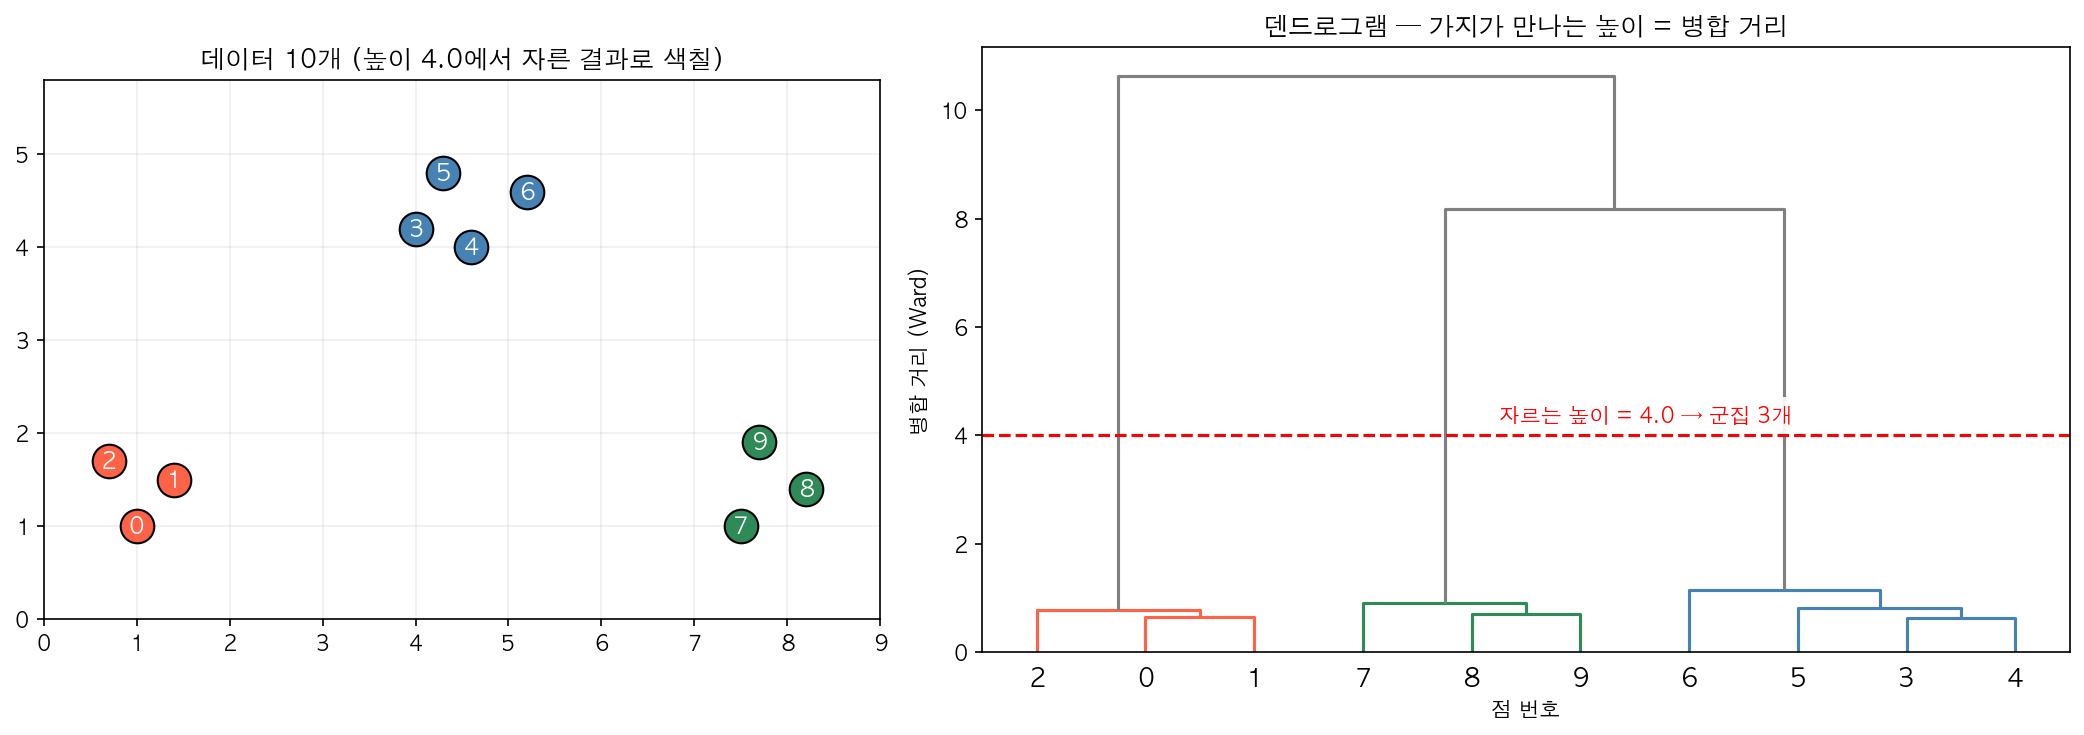
왼쪽은 2차원 점 10개, 오른쪽은 이 점들로 만든 덴드로그램입니다. 점 번호와 덴드로그램 아래쪽 번호가 대응합니다.
덴드로그램에서 두 가지가 만나는 높이 = 두 군집이 합쳐질 때의 거리입니다. 아래에서 일찍 합쳐질수록 가까운 점들입니다.
빨간 점선 높이에서 수평으로 자르면 세로선 3개와 만나므로 군집 3개가 되고, 왼쪽 그림의 색이 그 결과입니다. 자르는 높이를 바꾸는 것만으로 군집 수를 바꿀 수 있습니다.
3. 실제 예시로 보기 (군집)
예시 1 — 유전자 발현 데이터 (군집)
1
2
3
4
5
6
7
8
| 행: 유전자 수천 개 / 열: 환자 샘플
계층적 군집 + 히트맵 (Clustermap):
→ 비슷하게 발현되는 유전자끼리 묶임 (기능이 비슷한 유전자 그룹)
→ 비슷한 환자끼리 묶임 (질병 하위 유형 발견)
→ 덴드로그램 자체가 "유전자 족보" 역할
생물정보학에서 가장 많이 쓰이는 시각화 중 하나
|
예시 2 — 상품 카테고리 체계 만들기 (군집)
1
2
3
4
5
6
7
| 쇼핑몰 상품 2,000개를 "함께 구매되는 패턴"으로 계층 군집
높은 곳에서 자르면 (군집 3개): 식품 / 생활용품 / 전자기기
중간에서 자르면 (군집 10개): 식품 → 신선식품, 가공식품, 음료 ...
낮은 곳에서 자르면 (군집 40개): 음료 → 커피, 탄산, 생수 ...
→ 한 번 학습으로 대·중·소분류를 모두 얻음 (K-Means는 K마다 다시 학습)
|
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| ┌────────────────────────────────────────┐
│ 모든 점 = 각자 하나의 군집 (n개) │
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 모든 군집 쌍의 거리 계산 │ ← Linkage 방식이 결정
│ (single / complete / average / ward) │
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 가장 가까운 두 군집 병합 → 기록 │ ← 병합 거리 = 덴드로그램 높이
└──────────────────┬─────────────────────┘
│
군집이 1개 남았나? ── No ──→ 거리 계산 단계로
│ Yes
▼
┌────────────────────────────────────────┐
│ 덴드로그램 완성 → 원하는 높이에서 자르기 │
└────────────────────────────────────────┘
|
읽는 법:
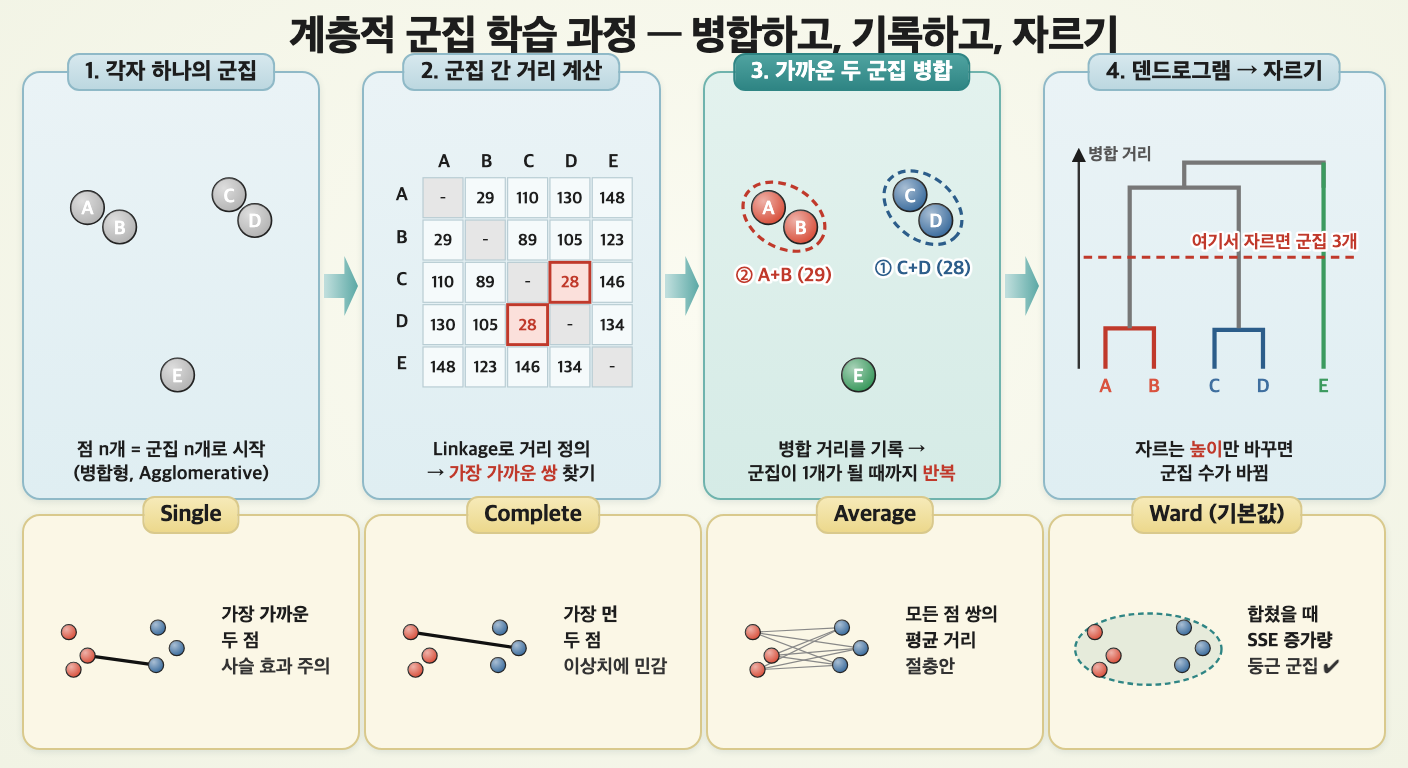
위쪽 네 칸은 점 5개(A~E)가 덴드로그램이 되는 과정입니다.
1 — 모든 점이 각자 하나의 군집으로 시작합니다.
2 — 군집 사이 거리를 모두 계산하고, 가장 가까운 쌍(C–D, 28)을 찾습니다.
3 — 가장 가까운 두 군집을 합치고 병합 거리를 기록합니다. C+D(28) 다음에는 A+B(29)가 합쳐지며, 군집이 하나 남을 때까지 반복합니다.
4 — 기록된 병합 거리를 높이로 그린 것이 덴드로그램입니다. 빨간 점선 높이에서 자르면 {A, B}, {C, D}, {E} 세 군집이 됩니다.
아래 네 칸은 ‘두 군집 사이 거리’를 정하는 Linkage 4가지입니다. 같은 데이터라도 무엇을 쓰느냐에 따라 결과가 크게 달라집니다.
| 구성 요소 | 설명 | 비유 |
|---|
| 거리 (Metric) | 두 점 사이 거리 (유클리드 등) | 두 사람 사이의 친밀도 |
| Linkage | 두 군집 사이 거리를 정의하는 방법 | 두 모임이 얼마나 가까운지 판단하는 기준 |
| 덴드로그램 | 병합 순서와 거리를 그린 나무 | 가계도 (족보) |
| 자르는 높이 | 군집을 나눌 거리 기준 | 몇 촌까지를 한 집안으로 볼지 |
5. 어떻게 군집 사이 거리를 정하는가
5-1. Linkage 방식 4가지
\[\text{Single}: \; d(A, B) = \min_{a \in A,\, b \in B} d(a, b) \qquad \text{Complete}: \; d(A, B) = \max_{a \in A,\, b \in B} d(a, b)\] \[\text{Average}: \; d(A, B) = \frac{1}{|A||B|}\sum_{a \in A}\sum_{b \in B} d(a, b)\] \[\text{Ward}: \; d(A, B) = \text{합친 후 SSE} - (\text{A의 SSE} + \text{B의 SSE})\]
| Linkage | 두 군집 사이 거리 | 특징 |
|---|
| Single | 가장 가까운 두 점의 거리 | 길쭉한 사슬 모양 군집도 찾음 / 사슬 효과(Chaining)로 한 군집이 계속 커지기 쉬움 |
| Complete | 가장 먼 두 점의 거리 | 지름이 작은 촘촘한 군집 / 이상치에 민감 |
| Average | 모든 점 쌍 거리의 평균 | Single과 Complete의 절충 |
| Ward | 합쳤을 때 SSE 증가량 | 크기가 비슷한 둥근 군집 (K-Means와 비슷) / sklearn 기본값 |
5-2. Ward Linkage와 K-Means
1
2
3
4
5
6
| Ward: "합쳤을 때 군집 내 분산(SSE)이 가장 적게 늘어나는 두 군집"을 합침
K-Means: "군집 내 SSE가 최소"가 되도록 중심을 찾음
→ 둘 다 SSE를 기준으로 하므로 결과가 비슷한 경우가 많음
→ Ward는 유클리드 거리에서만 사용 가능
→ 실무에서 가장 무난한 기본값
|
5-3. 계산 복잡도
1
2
3
4
5
6
7
8
| 모든 점 쌍의 거리 행렬 필요 → 메모리 O(n²)
병합을 n-1번 반복 → 시간 O(n²) ~ O(n³)
n = 1,000 → 거리 행렬 약 100만 개 ✅ 문제없음
n = 100,000 → 거리 행렬 약 100억 개 ❌ 메모리 부족 (약 40GB)
→ 수천 ~ 수만 건까지만 현실적
→ 대용량은 K-Means로 먼저 수백 개 군집으로 요약한 뒤, 그 중심들로 계층 군집
|
6. 계층적 군집 장・단점
6-1. ✅ 계층적 군집 장점
1
2
3
4
5
6
7
8
9
10
11
| 1. K를 미리 정할 필요 없음
→ 덴드로그램을 보고 나서 자르는 높이(군집 수) 결정
2. 계층 구조 파악
→ 대분류·중분류·소분류를 한 번에 얻음
3. 시각적 해석이 쉬움
→ 덴드로그램 하나로 데이터의 구조를 한눈에
4. 결정적 (Deterministic)
→ 초기값에 따른 무작위성이 없음 → 항상 같은 결과
|
6-2. ❌ 계층적 군집이 약한 상황
1
2
3
4
5
6
7
8
9
10
11
| 1. 대용량 데이터
→ O(n²) 메모리 → 수만 건 이상은 사실상 불가능
2. 한 번 합치면 되돌릴 수 없음 (Greedy)
→ 초반에 잘못 합쳐진 군집은 끝까지 수정되지 않음
3. Linkage 선택에 따라 결과가 크게 달라짐
→ 같은 데이터에서도 Single과 Ward의 결과가 완전히 다를 수 있음
4. 이상치·노이즈에 민감
→ Single은 노이즈가 다리 역할을 해 군집을 이어버림, Complete는 이상치 하나에 거리가 커짐
|
6-2-1. Linkage 선택 문제
계층적 군집에서 가장 신경 써야 할 부분입니다.
1
2
3
4
5
6
7
8
| 같은 데이터 (둥근 군집 3개 + 그 사이를 잇는 노이즈 몇 개)
Single : 노이즈를 징검다리 삼아 군집이 사슬처럼 이어짐 → 거대 군집 1개 + 외톨이 점들
Complete : 비교적 균형 잡힌 3개
Ward : 크기가 비슷한 둥근 3개 ✅
반대로 초승달 같은 휘어진 군집이라면 Single이 가장 잘 찾음
→ 데이터 모양에 따라 Linkage를 골라야 함
|
해결책 :
1
2
3
4
5
6
7
8
9
10
11
| from scipy.cluster.hierarchy import linkage, cophenet
from scipy.spatial.distance import pdist
# 방법 1: Cophenetic 상관계수로 Linkage 비교
# → 덴드로그램이 원래 거리 구조를 얼마나 잘 보존하는지 (1에 가까울수록 좋음)
# for method in ['single', 'complete', 'average', 'ward']:
# Z = linkage(X_scaled, method=method)
# c, _ = cophenet(Z, pdist(X_scaled))
# print(method, round(c, 3))
# 방법 2: 군집 수를 정한 뒤 Linkage별 Silhouette Score 비교
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 비지도학습 / 군집 (계층 기반) |
| 핵심 아이디어 | 가장 가까운 두 군집을 반복 병합 → 덴드로그램 → 원하는 높이에서 자르기 |
| 군집 수 | 덴드로그램을 보고 사후 결정 |
| 스케일링 필요? | ✅ 필수 (거리 기반) |
| 핵심 파라미터 | n_clusters 또는 distance_threshold, linkage, metric |
| 실전 사용 | 계층 구조 탐색, 유전자 데이터, 소규모 데이터 군집, 군집 수 탐색 |
8. 다른 알고리즘과 무엇이 다른가
K-Means vs 계층적 군집 vs DBSCAN
1
2
3
| K-Means : K개 중심을 반복 이동 → 평평한(flat) 군집 K개
계층적 군집 : 가까운 군집을 반복 병합 → 나무 구조, 자르는 높이로 군집 수 결정
DBSCAN : 밀도가 높은 영역을 연결 → 임의 모양 군집 + 노이즈
|
| 항목 | K-Means | 계층적 군집 | DBSCAN |
|---|
| 군집 수 | 사전 지정 | 사후 결정 | 자동 |
| 결과 형태 | 평평한 군집 | 계층 구조 | 평평한 군집 + 노이즈 |
| 군집 모양 | 구형 | Linkage에 따라 다양 | 임의 모양 |
| 대용량 | ✅ 강함 | ❌ 약함 (O(n²)) | ▲ 보통 |
| 무작위성 | 있음 (초기값) | 없음 | 거의 없음 |
| 새 데이터 예측 | ✅ | ❌ | ❌ |
9. 코드로 보기 — 와인 데이터 군집화
1
2
3
4
5
6
7
| from sklearn.cluster import AgglomerativeClustering
hc = AgglomerativeClustering(
n_clusters = 3, # 최종 군집 수 (distance_threshold와 둘 중 하나만)
linkage = 'ward', # 군집 간 거리 정의
metric = 'euclidean' # 점 간 거리 (ward는 euclidean만 가능)
)
|
| Parameter | Default | 역할 | 비고 |
|---|
n_clusters | 2 | 최종 군집 수 | distance_threshold 사용 시 None |
distance_threshold | None | 이 거리 이상이면 병합 중단 | 군집 수를 거리로 결정 |
linkage | 'ward' | 군집 간 거리 방식 | 'single', 'complete', 'average' |
metric | 'euclidean' | 점 간 거리 함수 | 'manhattan', 'cosine' 등 (ward 제외) |
compute_distances | False | 병합 거리 저장 (덴드로그램용) | - |
n_clusters vs distance_thresholdn_clusters=3 : 덴드로그램을 군집이 3개가 되는 높이에서 자름distance_threshold=10 : 높이 10에서 자름 → 군집 수는 결과로 결정
linkage : 군집 간 거리 정의'ward' : 크기가 비슷한 둥근 군집 → 가장 무난한 기본값'average' / 'complete' : 유클리드가 아닌 거리(코사인 등)를 쓸 때'single' : 길쭉하거나 휘어진 군집 (노이즈에 매우 민감)
- 덴드로그램은 sklearn보다
scipy.cluster.hierarchy가 편리 → 아래 코드에서 함께 사용
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
| import numpy as np
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.preprocessing import StandardScaler
wine = load_wine()
X = pd.DataFrame(wine.data, columns=wine.feature_names)
y_true = wine.target # ⚠️ 학습에 사용하지 않음 (평가용)
# ✅ 거리 기반 → 스케일링 필수
X_scaled = StandardScaler().fit_transform(X)
|
Note: 와인 데이터는 proline(평균 약 750)과 hue(평균 약 1)처럼 단위 차이가 매우 큽니다.
스케일링 없이 거리를 계산하면 proline 하나가 덴드로그램 전체를 결정합니다.
9-2. 덴드로그램 그리기
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
| import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import linkage, dendrogram
Z = linkage(X_scaled, method='ward') # (n-1) × 4 병합 기록
plt.figure(figsize=(14, 5))
dendrogram(
Z,
truncate_mode = 'lastp', # 마지막 p번의 병합만 표시
p = 30,
color_threshold = 20, # 이 높이 아래의 가지를 군집별 색으로
leaf_font_size = 9
)
plt.axhline(20, color='red', ls='--', lw=1.5, label='자르는 높이 = 20')
plt.xlabel('샘플 (괄호 안 숫자 = 묶인 샘플 수)')
plt.ylabel('병합 거리 (Ward)')
plt.title('와인 데이터 덴드로그램')
plt.legend()
plt.tight_layout()
plt.show()
|
읽는 법:
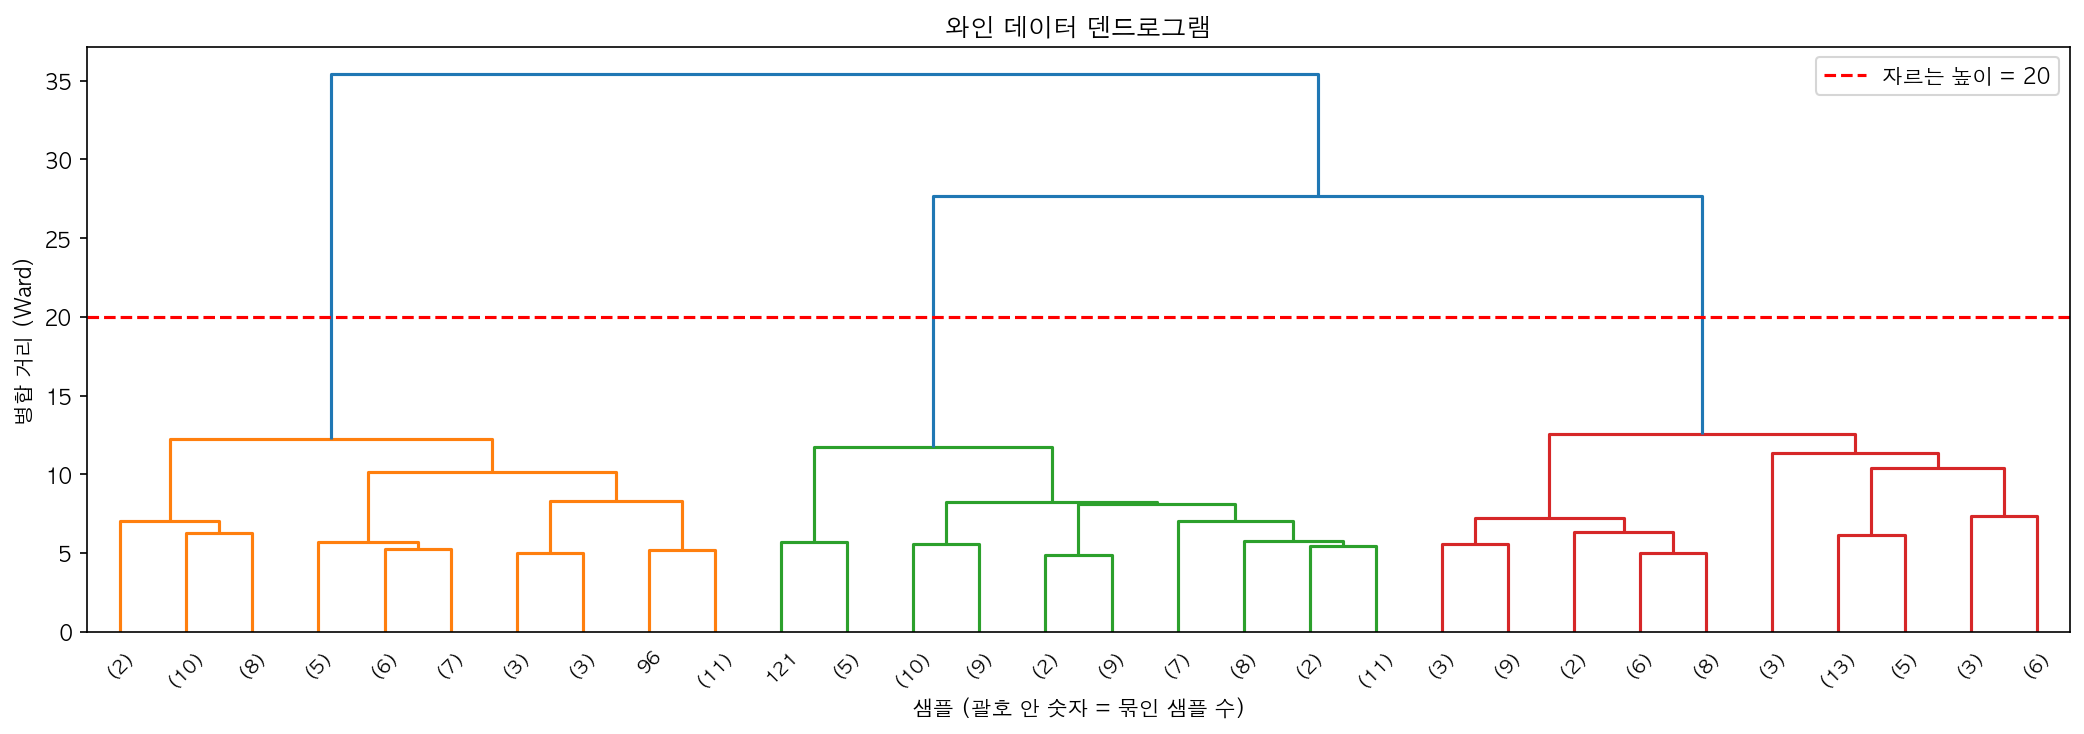
178개 와인이 아래에서부터 차례로 합쳐지는 과정입니다. 샘플이 많아 마지막 30번의 병합만 표시했고, 괄호 안 숫자는 그 가지에 묶인 와인 수입니다.
빨간 점선(높이 20)에서 자르면 세로선 3개와 만나 군집 3개가 되며, 색이 다른 세 가지가 각각의 군집입니다.
높이 13 ~ 27 구간에 세로선이 길게 뻗어 있다는 것은 세 군집이 서로 멀리 떨어져 있어 합쳐지기까지 큰 거리가 필요했다는 뜻입니다. 이렇게 긴 세로선이 시작되는 곳을 자르는 것이 좋은 군집 수 선택 기준입니다.
9-3. 모델 학습
1
2
3
4
| hc = AgglomerativeClustering(n_clusters=3, linkage='ward')
labels = hc.fit_predict(X_scaled)
print(f"군집별 샘플 수 : {np.bincount(labels)}")
|
9-4. 평가
1
2
3
4
5
6
| from sklearn.metrics import silhouette_score, adjusted_rand_score
print(f"Silhouette Score : {silhouette_score(X_scaled, labels):.4f}")
print(f"ARI : {adjusted_rand_score(y_true, labels):.4f}")
print()
print(pd.crosstab(y_true, labels, rownames=['실제 품종'], colnames=['군집']))
|
1
2
3
4
5
6
7
8
| Silhouette Score : 0.2774
ARI : 0.7899
군집 0 1 2
실제 품종
0 0 0 59
1 58 8 5
2 0 48 0
|
결과 해석:
품종 0과 2는 각각 한 군집으로 완벽히 묶였고, 품종 1의 71개 중 13개가 다른 군집으로 갔습니다(ARI 0.79).
같은 데이터에서 K-Means(ARI 0.90)보다 약간 낮은데, 계층적 군집은 한 번 합친 결과를 되돌리지 못하기 때문에 초반의 잘못된 병합이 끝까지 남습니다.
대신 덴드로그램이라는 계층 정보를 덤으로 얻고, 실행할 때마다 결과가 같다는 장점이 있습니다.
9-5. Linkage 방식 비교
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| from scipy.cluster.hierarchy import cophenet
from scipy.spatial.distance import pdist
from sklearn.decomposition import PCA
X_2d = PCA(n_components=2).fit_transform(X_scaled) # 시각화용 2차원
fig, axes = plt.subplots(1, 4, figsize=(18, 4.3))
for ax, method in zip(axes, ['single', 'complete', 'average', 'ward']):
lab = AgglomerativeClustering(n_clusters=3, linkage=method).fit_predict(X_scaled)
coph, _ = cophenet(linkage(X_scaled, method=method), pdist(X_scaled))
ax.scatter(X_2d[:, 0], X_2d[:, 1], c=lab, cmap='viridis', s=18)
ax.set_title(f'{method}\n군집 크기 {sorted(np.bincount(lab), reverse=True)}\n'
f'ARI = {adjusted_rand_score(y_true, lab):.3f} / Cophenetic = {coph:.3f}', fontsize=10)
ax.set_xticks([]); ax.set_yticks([])
plt.tight_layout()
plt.show()
|
읽는 법:
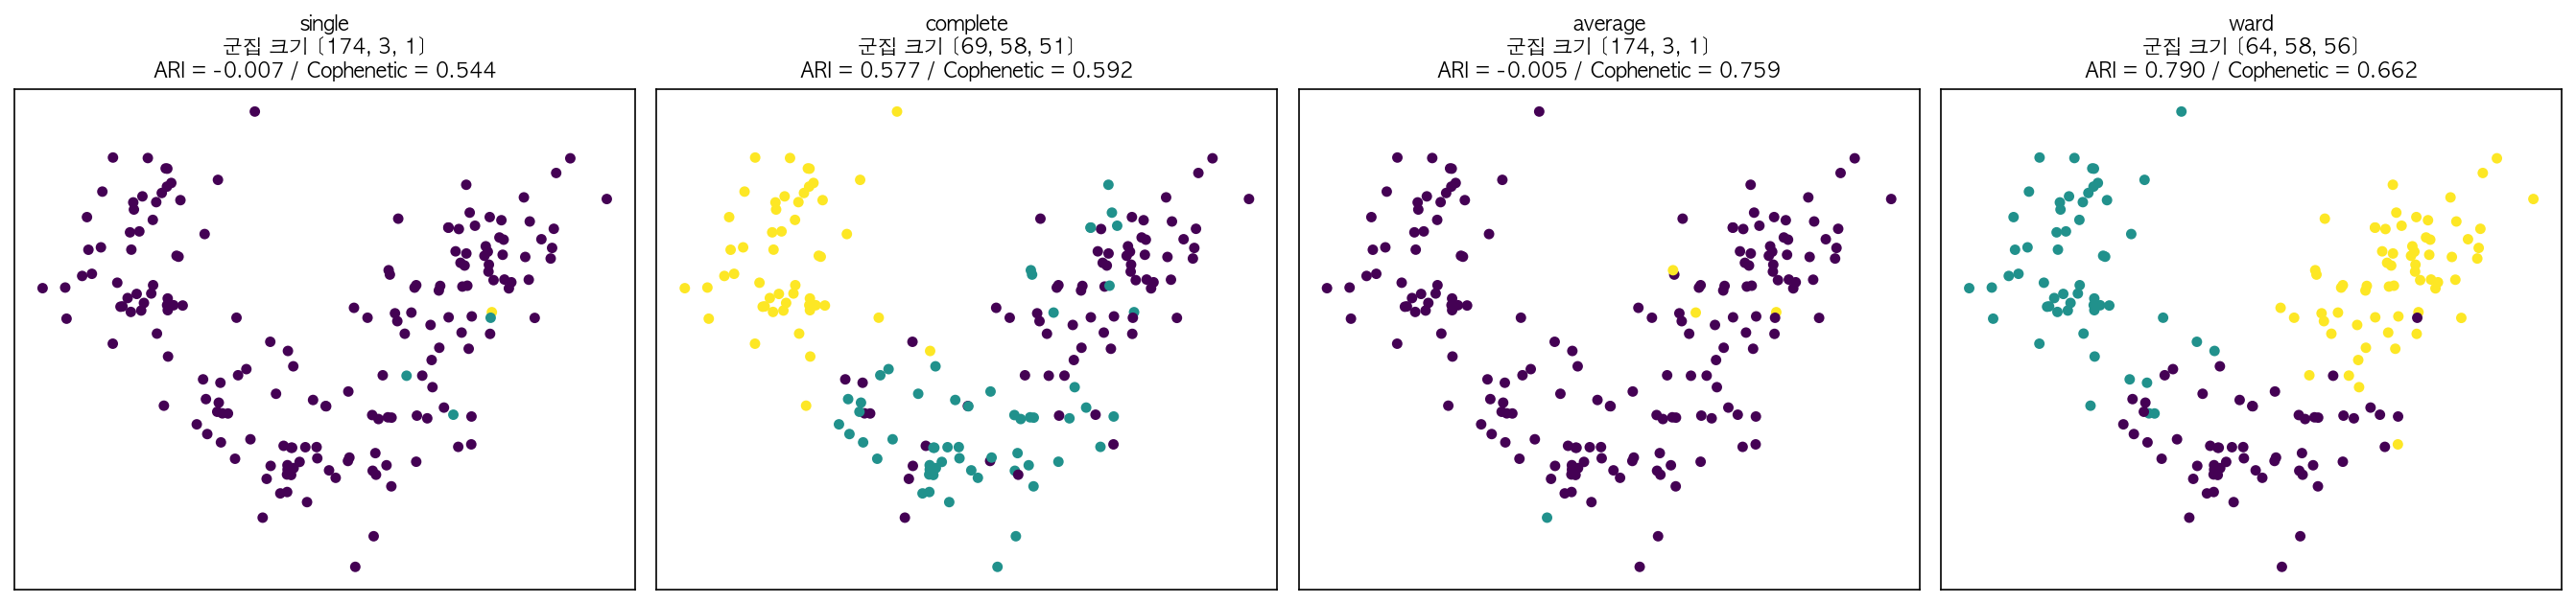
같은 와인 데이터를 Linkage만 바꿔 군집 3개로 나눈 결과입니다(PCA 2차원 투영).
Single·Average — 사슬 효과로 178개 중 174개가 한 군집에 묶이고, 외딴 점 몇 개가 각자 군집이 됩니다(크기 174 : 3 : 1). 의미 있는 군집이 아닙니다.
Complete — 균형 잡힌 세 군집을 만들지만 실제 품종과의 일치도는 보통입니다(ARI 0.58).
Ward — 크기가 비슷한 세 군집을 만들고 실제 품종과의 일치도(ARI 0.79)도 가장 높습니다.
Cophenetic 상관계수는 덴드로그램이 원래 거리를 얼마나 잘 보존하는지 보는 지표인데, Average가 0.759로 가장 높지만 군집 결과는 가장 쓸모없습니다. 이 값이 높다고 군집이 좋은 것은 아니므로 결과의 크기 분포와 해석 가능성까지 함께 봐야 합니다.