1. 왜 등장했는가
K-Means는 군집 수 K를 미리 정해야 하고, 군집이 둥근 덩어리라고 가정하기 때문에 초승달·고리처럼 휘어진 군집을 찾지 못합니다.
또 모든 점을 반드시 어느 군집에 넣기 때문에 이상치도 억지로 군집에 포함시킵니다.
DBSCAN(Density-Based Spatial Clustering of Applications with Noise)은 “점이 빽빽하게 모인 곳”을 군집으로 보고, 밀도가 낮은 곳의 점은 노이즈로 분리하는 밀도 기반 군집 알고리즘입니다. (Ester et al., 1996)
K-Means가 “주민센터(중심)를 K개 세우고 가까운 곳에 등록시키는” 방식이라면,
DBSCAN은 “사람이 붐비는 곳을 따라 번화가를 이어 그리는” 방식에 가깝습니다.
2. 핵심 아이디어 — “가까운 이웃이 충분히 많으면 같은 군집”
DBSCAN은 본질적으로 반경 eps 안에 이웃이 min_samples개 이상인 점(핵심점)들을 이어 붙여 군집을 만드는 알고리즘입니다.
1
2
3
4
5
6
7
8
9
10
11
| eps = 반경, min_samples = 5
점 A: 반경 eps 안에 이웃 7개 → 핵심점 (Core) → 군집의 "뼈대"
점 B: 반경 eps 안에 이웃 2개, 하지만 핵심점 A의 반경 안에 있음
→ 경계점 (Border) → 군집에 포함, 확장은 못 함
점 C: 반경 eps 안에 이웃 1개, 어떤 핵심점의 반경에도 없음
→ 노이즈 (Noise) → 군집 번호 -1
핵심점끼리 서로의 반경 안에 있으면 → 사슬처럼 이어져 하나의 군집
→ 군집 모양에 제한이 없음 (휘어진 모양, 길쭉한 모양 모두 가능)
→ 군집 수는 자동으로 결정됨
|
읽는 법:
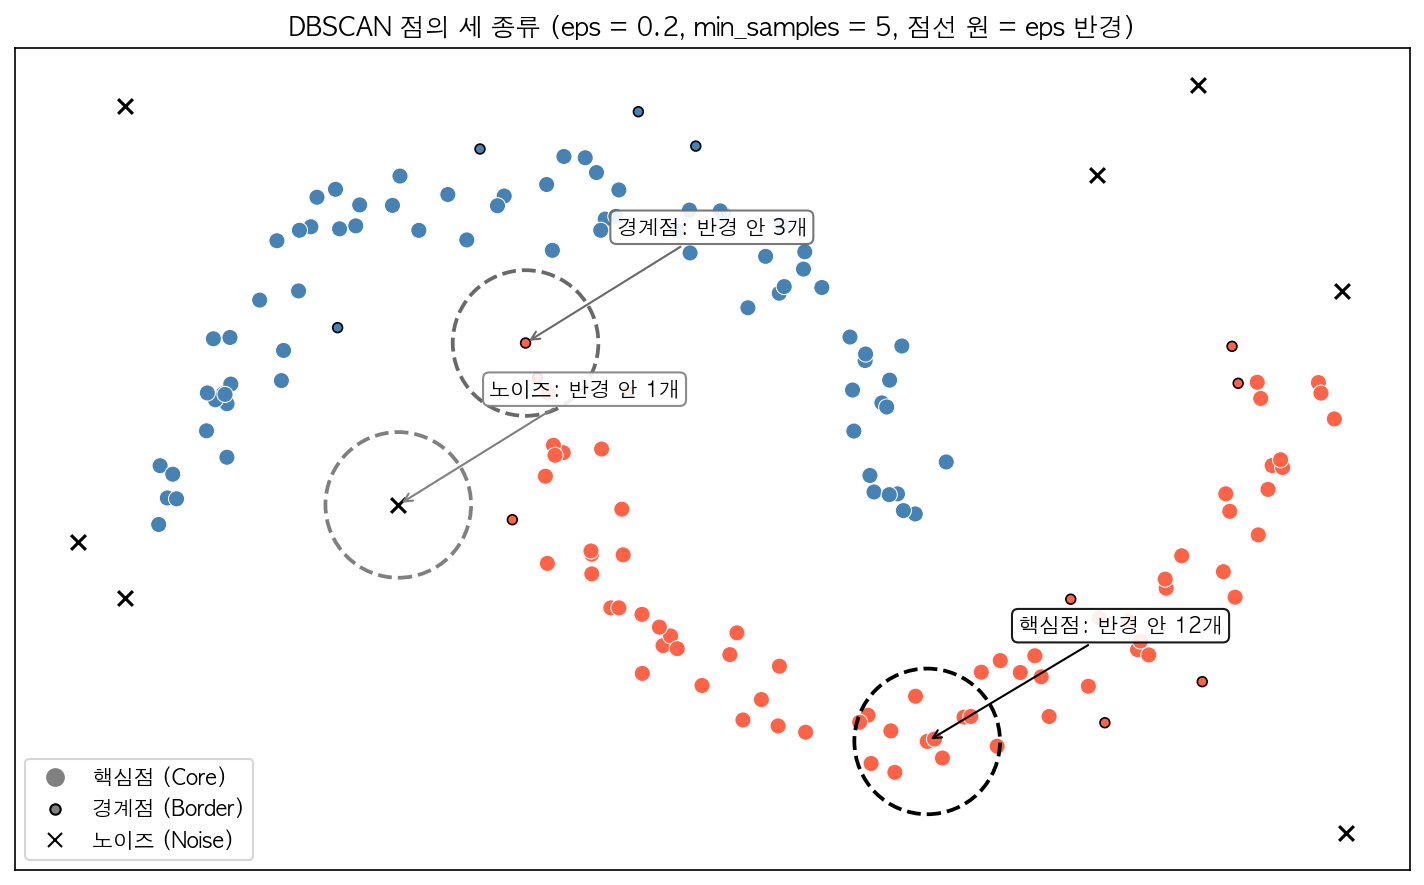
큰 점은 핵심점(Core), 테두리가 있는 작은 점은 경계점(Border), 검은 X는 노이즈(Noise)입니다. 색은 소속 군집입니다.
점선 원은 세 종류의 점 하나씩에 그린 eps 반경입니다. (개수는 자기 자신 포함)
오른쪽 아래 핵심점은 반경 안에 12개로 min_samples(5) 이상이고, 가운데 위 경계점은 3개뿐이지만 핵심점의 반경 안에 있어 군집에 포함됩니다. 가운데 왼쪽의 노이즈는 반경 안에 자기 자신뿐입니다.
핵심점들이 서로의 반경 안에 연결되면서 초승달 모양 그대로 군집이 이어지고, 어느 핵심점과도 연결되지 않는 외딴 점들은 노이즈로 남습니다.
3. 실제 예시로 보기 (군집)
예시 1 — 위치 데이터로 핫플레이스 찾기 (군집)
1
2
3
4
5
6
7
8
9
10
11
12
| 데이터: 사용자들의 체크인 위치 (위도, 경도) 10만 건
K-Means (K=10):
→ 핫플레이스가 몇 개인지 모르는데 K를 정해야 함
→ 한강공원처럼 길쭉한 핫플레이스를 여러 조각으로 쪼갬
→ 외딴 곳의 체크인 1건도 가장 가까운 군집에 억지로 포함
DBSCAN (eps=200m, min_samples=50):
→ 반경 200m 안에 체크인이 50건 이상 몰린 곳만 핫플레이스로
→ 한강공원은 강을 따라 길쭉한 군집 하나로
→ 외딴 체크인은 노이즈(-1)로 분리
→ 핫플레이스 수는 데이터가 결정
|
위치 데이터에서는 거리 계산에 metric='haversine'(위도·경도를 라디안으로 변환)을 사용합니다.
예시 2 — 신용카드 이상 거래 탐지 (이상치 탐지)
1
2
3
4
5
6
7
| 특성: 거래 금액, 거래 시각, 가맹점 업종, 이전 거래와의 거리 ...
정상 거래: 비슷한 패턴이 반복 → 빽빽한 군집 형성
이상 거래: 평소 패턴과 동떨어짐 → 주변에 이웃이 거의 없음
DBSCAN 결과: 노이즈(-1)로 분류된 거래 = 이상 거래 후보
→ 레이블 없이도 이상치 탐지 가능
|
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| ┌────────────────────────────────────────┐
│ eps, min_samples 설정 │ ← k-distance 그래프로 eps 탐색
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 모든 점의 eps 반경 이웃 수 계산 │
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 이웃 수 ≥ min_samples → 핵심점(Core) │
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 핵심점에서 시작해 반경 안의 핵심점을 │
│ 계속 이어 붙임 (군집 확장) │
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 핵심점 반경 안의 비핵심점 → 경계점 │
│ 어디에도 속하지 않는 점 → 노이즈 (-1) │
└────────────────────────────────────────┘
|
읽는 법:
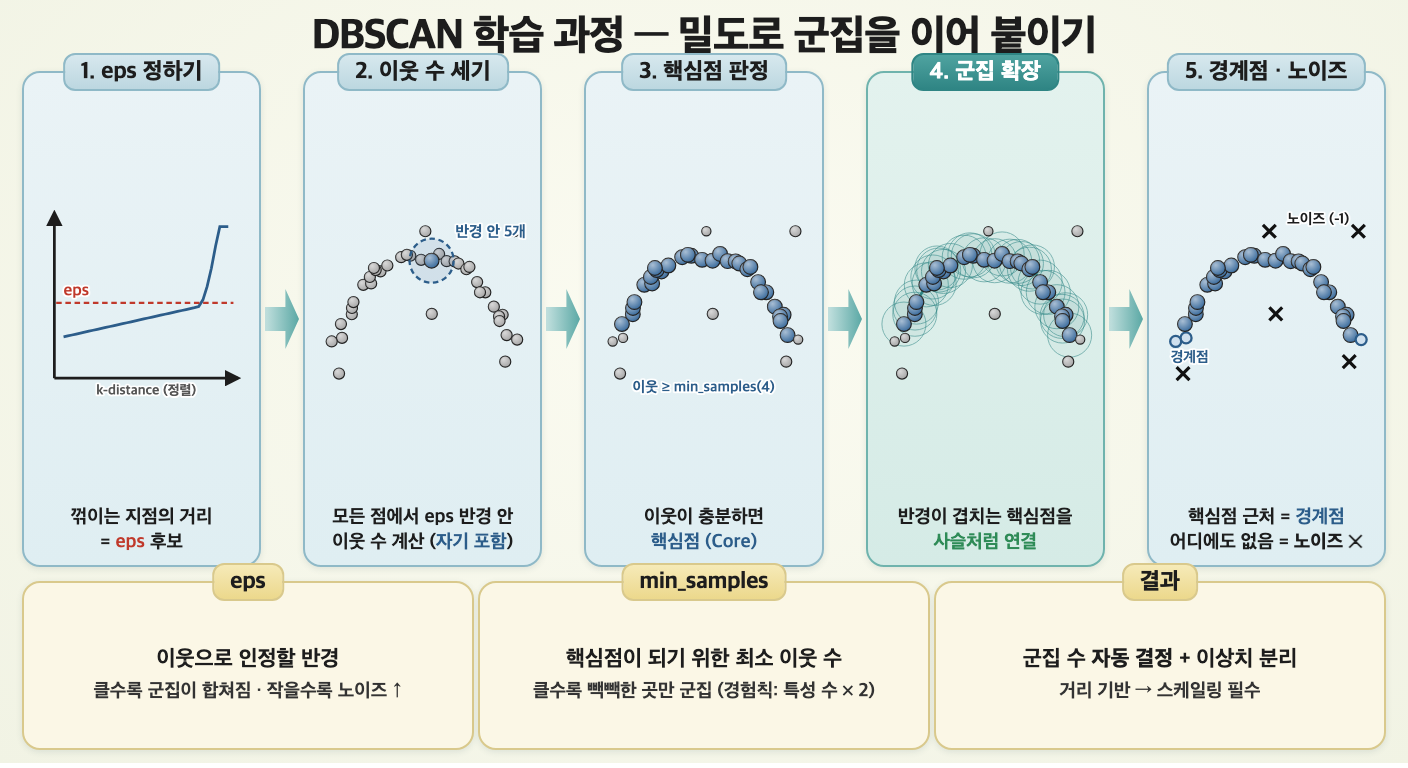
DBSCAN이 점을 핵심점·경계점·노이즈로 나누고 군집을 이어 붙이는 과정을 왼쪽부터 순서대로 그린 그림입니다.
1 — k-distance 그래프가 급격히 꺾이는 높이를 eps로 정합니다.
2 — 모든 점에서 반경 eps 안의 이웃 수를 셉니다(자기 자신 포함).
3 — 이웃이 min_samples개 이상인 점이 핵심점(큰 파란 점)입니다.
4 — 반경이 겹치는 핵심점끼리 사슬처럼 이어 하나의 군집을 만듭니다. 그래서 휘어진 모양도 그대로 따라갑니다.
5 — 핵심점의 반경 안에 있지만 이웃이 부족한 점은 경계점(테두리만 있는 점)으로 군집에 포함되고, 어디에도 속하지 않는 점은 노이즈(✕, 레이블 -1)가 됩니다.
아래 칸은 두 파라미터 eps와 min_samples의 역할입니다.
| 구성 요소 | 설명 | 비유 |
|---|
| eps (ε) | 이웃으로 인정할 반경 | “내 주변”의 범위 |
| min_samples | 핵심점이 되기 위한 최소 이웃 수 (자기 자신 포함) | 번화가로 인정할 최소 인원 |
| 핵심점 (Core) | 반경 안 이웃이 충분한 점 | 번화가 한복판 |
| 경계점 (Border) | 핵심점 근처지만 자신은 이웃이 부족한 점 | 번화가 가장자리 |
| 노이즈 (Noise) | 어느 군집에도 속하지 않는 점 | 외딴 시골집 |
5. 어떻게 군집을 찾는가
5-1. 밀도 연결 (Density Reachability)
\[N_\varepsilon(p) = \{\, q \in D \mid \text{dist}(p, q) \le \varepsilon \,\}\] \[p \text{는 핵심점} \iff |N_\varepsilon(p)| \ge \text{min\_samples}\]
1
2
3
4
5
6
7
8
9
10
11
| 직접 밀도 도달 (Directly Density-Reachable):
q가 핵심점 p의 eps 반경 안에 있으면 → p에서 q로 직접 도달 가능
밀도 도달 (Density-Reachable):
p → p₁ → p₂ → ... → q 처럼 핵심점들의 사슬로 이어지면 도달 가능
밀도 연결 (Density-Connected):
어떤 핵심점 o에서 p와 q 모두 도달 가능하면 → p와 q는 같은 군집
→ 군집 = 밀도 연결된 점들의 최대 집합
→ "사슬"로 이어지기 때문에 군집이 어떤 모양이든 따라갈 수 있음
|
5-2. eps 정하기 — k-distance 그래프
1
2
3
4
5
6
7
8
9
| 1. min_samples = k 로 정함 (경험칙: 특성 수 × 2, 최소 3 이상)
2. 각 점에서 k번째로 가까운 이웃까지의 거리 계산
3. 이 거리를 오름차순 정렬해 그래프로 그림
4. 그래프가 급격히 꺾이며 올라가는 지점(무릎, Knee)의 y값 = eps
이유:
군집 안의 점 → k번째 이웃까지 거리가 짧음 (그래프의 완만한 구간)
노이즈 점 → k번째 이웃까지 거리가 김 (그래프의 급상승 구간)
→ 꺾이는 지점이 "군집 안"과 "노이즈"를 가르는 경계 거리
|
5-3. 계산 복잡도
1
2
3
4
5
6
7
| 모든 점마다 eps 반경 이웃을 찾아야 함
단순 계산 : O(n²) → 10만 건이면 100억 번 거리 계산
KD-Tree/Ball-Tree: 평균 O(n log n) → sklearn이 자동 사용 (algorithm='auto')
⚠️ eps가 너무 크면 이웃 수가 폭증 → 메모리 부족 발생 가능
→ 대용량 데이터는 HDBSCAN 또는 OPTICS 고려
|
6. DBSCAN 장・단점
6-1. ✅ DBSCAN 장점
1
2
3
4
5
6
7
8
9
10
11
| 1. 군집 수를 정할 필요 없음
→ 데이터의 밀도 구조가 군집 수를 결정
2. 임의 모양의 군집 탐지
→ 초승달, 고리, 길쭉한 모양 모두 가능
3. 이상치를 자동으로 분리
→ 노이즈(-1) 레이블 → 이상치 탐지에 바로 활용
4. 결과가 결정적 (Deterministic)
→ 핵심점·노이즈 판정은 항상 같음 (경계점의 소속만 처리 순서에 따라 달라질 수 있음)
|
6-2. ❌ DBSCAN이 약한 상황
1
2
3
4
5
6
7
8
9
10
11
12
13
| 1. 군집마다 밀도가 다를 때
→ eps 하나로 모든 군집을 처리 → 빽빽한 군집에 맞추면 성긴 군집이 노이즈로,
성긴 군집에 맞추면 빽빽한 군집끼리 합쳐짐
2. 고차원 데이터
→ 차원의 저주로 모든 점 사이 거리가 비슷해짐 → eps 설정이 무의미해짐
→ PCA로 차원 축소 후 적용
3. 파라미터에 민감
→ eps가 조금만 달라져도 군집 수가 크게 바뀜
4. 새 데이터 예측 불가
→ predict() 메서드가 없음 (fit_predict만 가능)
|
6-2-1. 군집별 밀도가 다른 문제
DBSCAN의 가장 큰 약점입니다.
1
2
3
4
5
6
| 도심 상권 (반경 100m에 가게 50개) + 교외 상권 (반경 1km에 가게 50개)
eps = 100m : 도심 상권 ✅ / 교외 상권은 전부 노이즈 ❌
eps = 1km : 교외 상권 ✅ / 도심의 여러 상권이 하나로 합쳐짐 ❌
→ 어떤 eps도 두 상권을 동시에 제대로 잡지 못함
|
해결책 :
1
2
3
4
5
6
7
| from sklearn.cluster import HDBSCAN, OPTICS
# 방법 1: HDBSCAN — eps 없이 여러 밀도 수준을 자동 탐색 (sklearn 1.3+)
hdb = HDBSCAN(min_cluster_size=15)
# 방법 2: OPTICS — 점마다 도달 거리를 계산해 다양한 밀도의 군집 추출
optics = OPTICS(min_samples=10, xi=0.05)
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 비지도학습 / 군집 (밀도 기반) |
| 핵심 아이디어 | 반경 eps 안에 이웃이 min_samples개 이상인 핵심점들을 이어 군집 형성 |
| 군집 수 | 자동 결정 |
| 이상치 처리 | ✅ 노이즈(-1)로 자동 분리 |
| 스케일링 필요? | ✅ 필수 (거리 기반) |
| 핵심 파라미터 | eps, min_samples |
| 실전 사용 | 위치 데이터 군집, 이상치 탐지, 모양이 불규칙한 군집 |
8. 다른 알고리즘과 무엇이 다른가
K-Means vs DBSCAN
1
2
3
4
| K-Means: "중심"으로 군집 정의 → 중심에서 가까운 점들의 둥근 덩어리
K를 미리 지정, 모든 점을 반드시 배정
DBSCAN: "밀도"로 군집 정의 → 빽빽하게 이어진 점들의 연결
군집 수 자동, 밀도가 낮은 점은 노이즈로 제외
|
| 항목 | K-Means | DBSCAN |
|---|
| 군집 정의 | 중심까지 거리 | 밀도 연결 |
| 군집 수 | 사전 지정 (K) | 자동 |
| 군집 모양 | 구형 | 임의 모양 |
| 이상치 | 군집에 강제 포함 | 노이즈로 분리 |
| 밀도 다른 군집 | ⚠️ | ❌ 약함 |
| 새 데이터 예측 | ✅ predict | ❌ |
| 핵심 파라미터 | n_clusters | eps, min_samples |
9. 코드로 보기 — 초승달 데이터 군집화
1
2
3
4
5
6
7
| from sklearn.cluster import DBSCAN
dbscan = DBSCAN(
eps = 0.25, # 이웃으로 인정할 반경
min_samples = 5, # 핵심점이 되기 위한 최소 이웃 수 (자기 자신 포함)
metric = 'euclidean' # 거리 계산 방식
)
|
| Parameter | Default | 역할 | 비고 |
|---|
eps | 0.5 | 이웃 반경 | 가장 중요, 데이터 스케일에 따라 다름 |
min_samples | 5 | 핵심점 최소 이웃 수 | 클수록 노이즈 ↑, 군집 수 ↓ |
metric | 'euclidean' | 거리 함수 | 'haversine', 'cosine' 등 |
algorithm | 'auto' | 이웃 탐색 방법 | 'ball_tree', 'kd_tree', 'brute' |
n_jobs | None | 병렬 처리 | - |
eps : 가장 중요한 파라미터- 값 변화별 효과
- 클수록 → 군집이 합쳐지고 노이즈 ↓ (너무 크면 전체가 군집 1개)
- 작을수록 → 군집이 쪼개지고 노이즈 ↑ (너무 작으면 전부 노이즈)
- k-distance 그래프로 탐색 권장
min_samples : 핵심점 기준- 클수록 → 더 빽빽한 곳만 군집으로 인정 → 노이즈 ↑
- 경험칙: 특성 수 × 2 (2차원이면 4~5), 노이즈가 많은 데이터일수록 크게
metric : 거리 함수'euclidean' : 일반적인 수치 데이터'haversine' : 위도·경도 (라디안 단위 입력)'cosine' : 텍스트 임베딩 등 방향이 중요한 데이터
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| import numpy as np
import pandas as pd
from sklearn.datasets import make_moons
from sklearn.preprocessing import StandardScaler
# 초승달 2개 + 무작위 이상치 20개
X_moons, y_true = make_moons(n_samples=400, noise=0.07, random_state=0)
rng = np.random.RandomState(0)
X_noise = rng.uniform(low=[-1.5, -1.0], high=[2.5, 1.5], size=(20, 2))
X = np.vstack([X_moons, X_noise])
y_true = np.r_[y_true, [-1] * 20] # 이상치의 실제 레이블 = -1 (평가용)
# ✅ DBSCAN은 거리 기반 → 스케일링 필수
X_scaled = StandardScaler().fit_transform(X)
print(X_scaled.shape)
|
Note: eps는 “거리”이므로 특성들의 단위가 같아야 의미가 있습니다.
스케일링 없이 쓰면 단위가 큰 특성 방향으로만 이웃이 정해집니다.
9-2. eps 탐색 — k-distance 그래프
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| import matplotlib.pyplot as plt
from sklearn.neighbors import NearestNeighbors
k = 5 # = min_samples
nn = NearestNeighbors(n_neighbors=k).fit(X_scaled)
distances, _ = nn.kneighbors(X_scaled) # 자기 자신(거리 0)이 첫 번째 이웃으로 포함됨
k_dist = np.sort(distances[:, -1]) # 자신 포함 k번째 이웃까지의 거리 (min_samples 정의와 동일)
plt.figure(figsize=(8, 4.5))
plt.plot(k_dist, color='steelblue', lw=2)
plt.axhline(0.25, color='tomato', ls='--', label='eps = 0.25')
plt.xlabel('점 (k-distance 오름차순 정렬)')
plt.ylabel(f'{k}번째 이웃까지의 거리')
plt.title('k-distance 그래프 — 급격히 꺾이는 지점이 eps 후보')
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
|
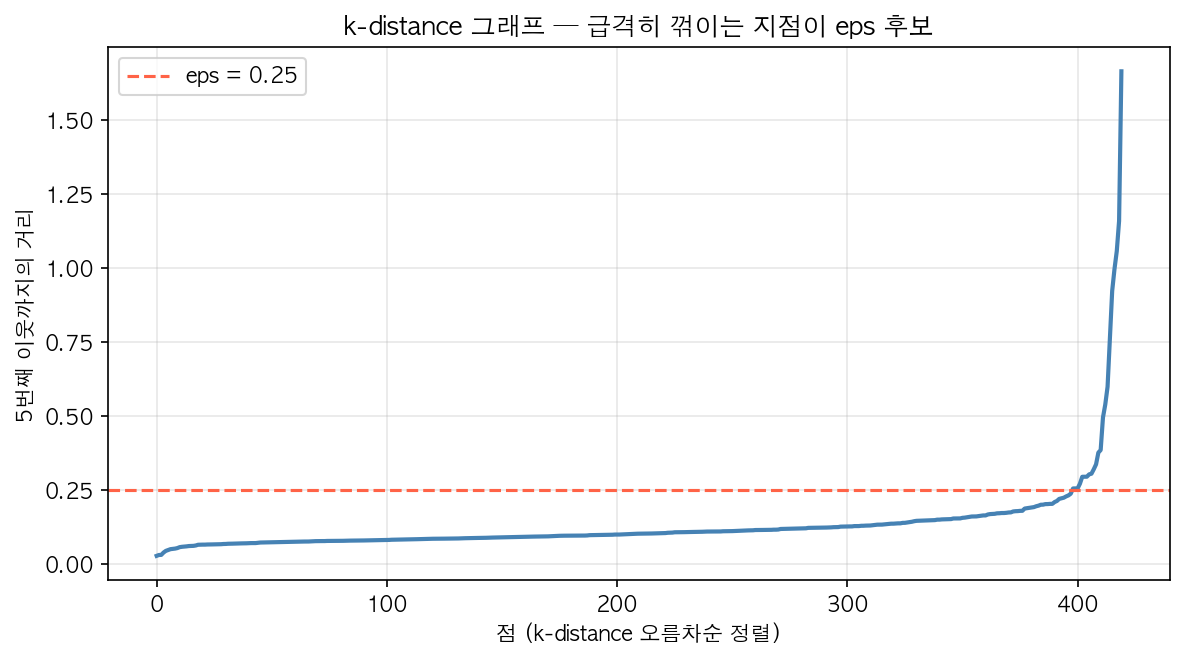
읽는 법:
모든 점의 “5번째 이웃까지의 거리”를 작은 순서로 늘어놓은 그래프입니다.
대부분의 점(군집 안의 점)은 거리가 작고 완만하게 증가하다가, 오른쪽 끝에서 급격히 치솟습니다. 이 급상승 구간의 점들이 이웃이 멀리 있는 노이즈입니다.
꺾이는 지점 근처(빨간 점선, 0.25)를 eps로 정하면 군집 안의 점은 핵심점이 되고 외딴 점은 노이즈로 분리됩니다.
9-3. 모델 학습
1
2
3
4
5
6
7
8
9
10
| dbscan = DBSCAN(eps=0.25, min_samples=5)
labels = dbscan.fit_predict(X_scaled)
n_clusters = len(set(labels)) - (1 if -1 in labels else 0)
n_noise = np.sum(labels == -1)
n_core = len(dbscan.core_sample_indices_)
print(f"군집 수 : {n_clusters}")
print(f"노이즈 수 : {n_noise}")
print(f"핵심점 수 : {n_core}")
|
9-4. 평가
1
2
3
4
5
6
7
8
9
| from sklearn.metrics import adjusted_rand_score, silhouette_score
mask = labels != -1 # 실루엣은 노이즈를 제외하고 계산
print(f"ARI (전체) : {adjusted_rand_score(y_true, labels):.4f}")
print(f"Silhouette (노이즈 제외) : {silhouette_score(X_scaled[mask], labels[mask]):.4f}")
# 실제 이상치 20개 중 몇 개를 노이즈로 잡았는가
is_outlier = y_true == -1
print(f"이상치 탐지 : {np.sum(labels[is_outlier] == -1)} / {is_outlier.sum()}")
|
1
2
3
4
5
6
7
| 군집 수 : 2
노이즈 수 : 13
핵심점 수 : 398
ARI (전체) : 0.9658
Silhouette (노이즈 제외) : 0.3805
이상치 탐지 : 13 / 20
|
결과 해석:
군집 수를 알려주지 않았는데도 초승달 2개를 찾았고, ARI 0.97로 실제 구조와 거의 일치합니다.
넣어둔 이상치 20개 중 13개를 노이즈로 분리했습니다. 나머지 7개는 초승달 바로 옆에 떨어져 주변 밀도가 충분히 높았기 때문에 군집에 포함되었습니다.
Note: 실루엣 점수는 “둥글고 잘 떨어진 군집”일수록 높게 나오므로, 초승달처럼 휘어진 군집에서는 올바르게 군집화해도 점수가 낮게 나올 수 있습니다.
밀도 기반 군집은 실루엣보다 시각화와 도메인 해석으로 검증하는 것이 더 중요합니다.
9-5. K-Means와 비교
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| from sklearn.cluster import KMeans
km_labels = KMeans(n_clusters=2, n_init=10, random_state=0).fit_predict(X_scaled)
fig, axes = plt.subplots(1, 2, figsize=(12, 5))
for ax, lab, title in [(axes[0], km_labels, 'K-Means (K=2)'),
(axes[1], labels, f'DBSCAN (eps=0.25, min_samples=5)')]:
noise = lab == -1
ax.scatter(X_scaled[~noise, 0], X_scaled[~noise, 1], c=lab[~noise], cmap='coolwarm', s=18)
ax.scatter(X_scaled[noise, 0], X_scaled[noise, 1], c='black', marker='x', s=40, label='Noise (-1)')
ax.set_title(f'{title}\nARI = {adjusted_rand_score(y_true, lab):.3f}')
ax.grid(True, alpha=0.2)
axes[1].legend()
plt.tight_layout()
plt.show()
|
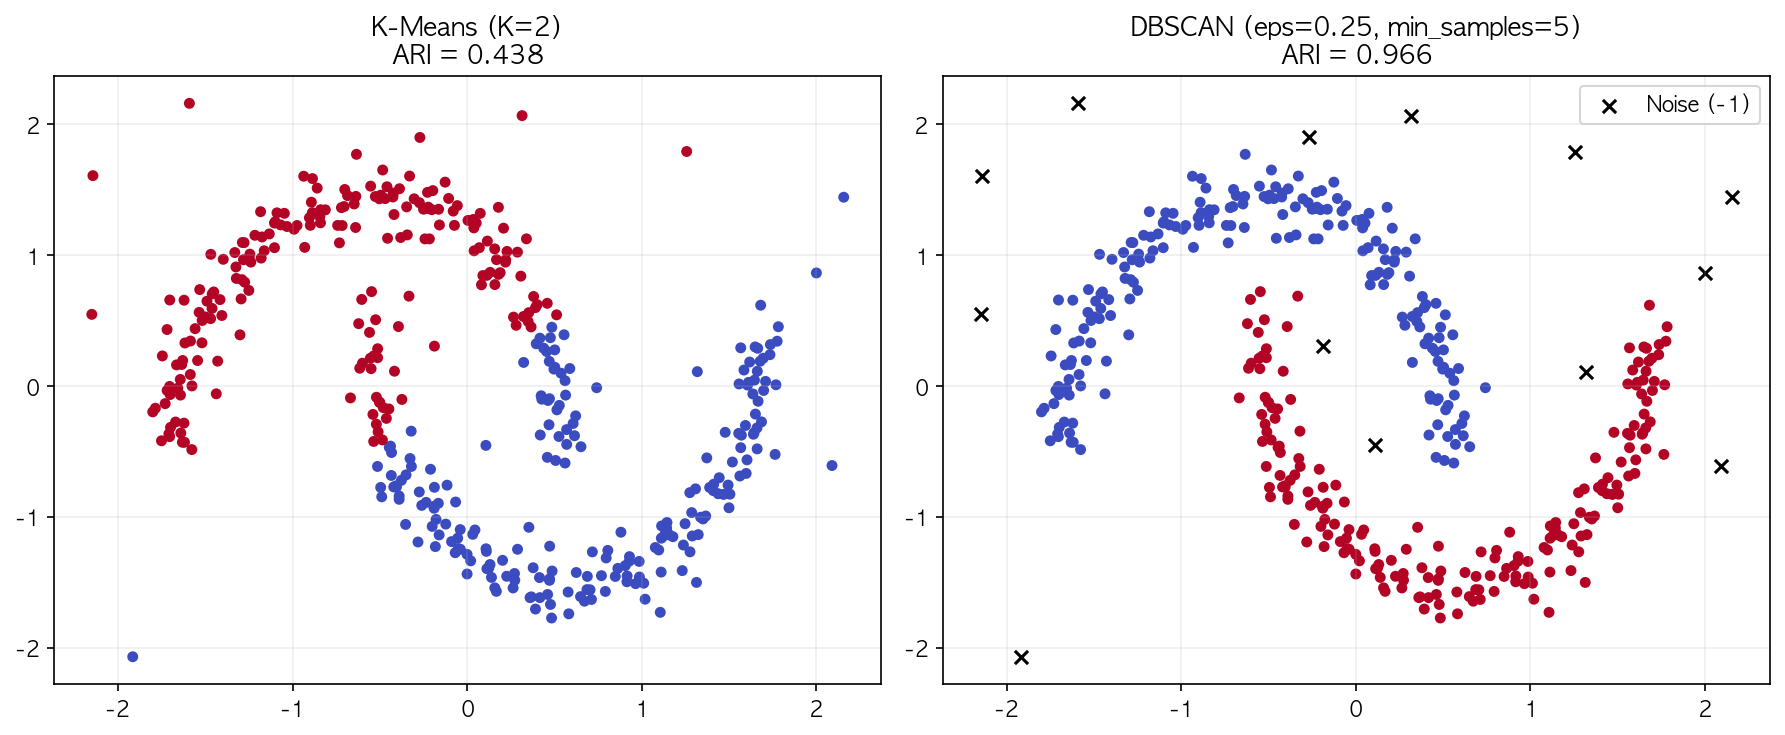
읽는 법:
왼쪽 (K-Means) — 두 중심의 수직이등분선(직선)으로 데이터를 반씩 잘라, 각 초승달의 끝부분이 반대편 군집에 섞입니다. 이상치도 모두 어느 군집에 강제로 포함됩니다.
오른쪽 (DBSCAN) — 초승달 모양을 그대로 따라 두 군집을 찾았고, 외딴 이상치 대부분을 노이즈(검은 X)로 분리했습니다.
초승달 근처에 우연히 떨어진 이상치는 주변 밀도가 높아 군집에 포함될 수 있습니다. 이는 DBSCAN의 한계가 아니라 “주변이 빽빽하면 군집”이라는 정의 그대로의 결과입니다.
9-6. eps에 따른 결과 변화
1
2
3
4
5
6
7
8
9
10
11
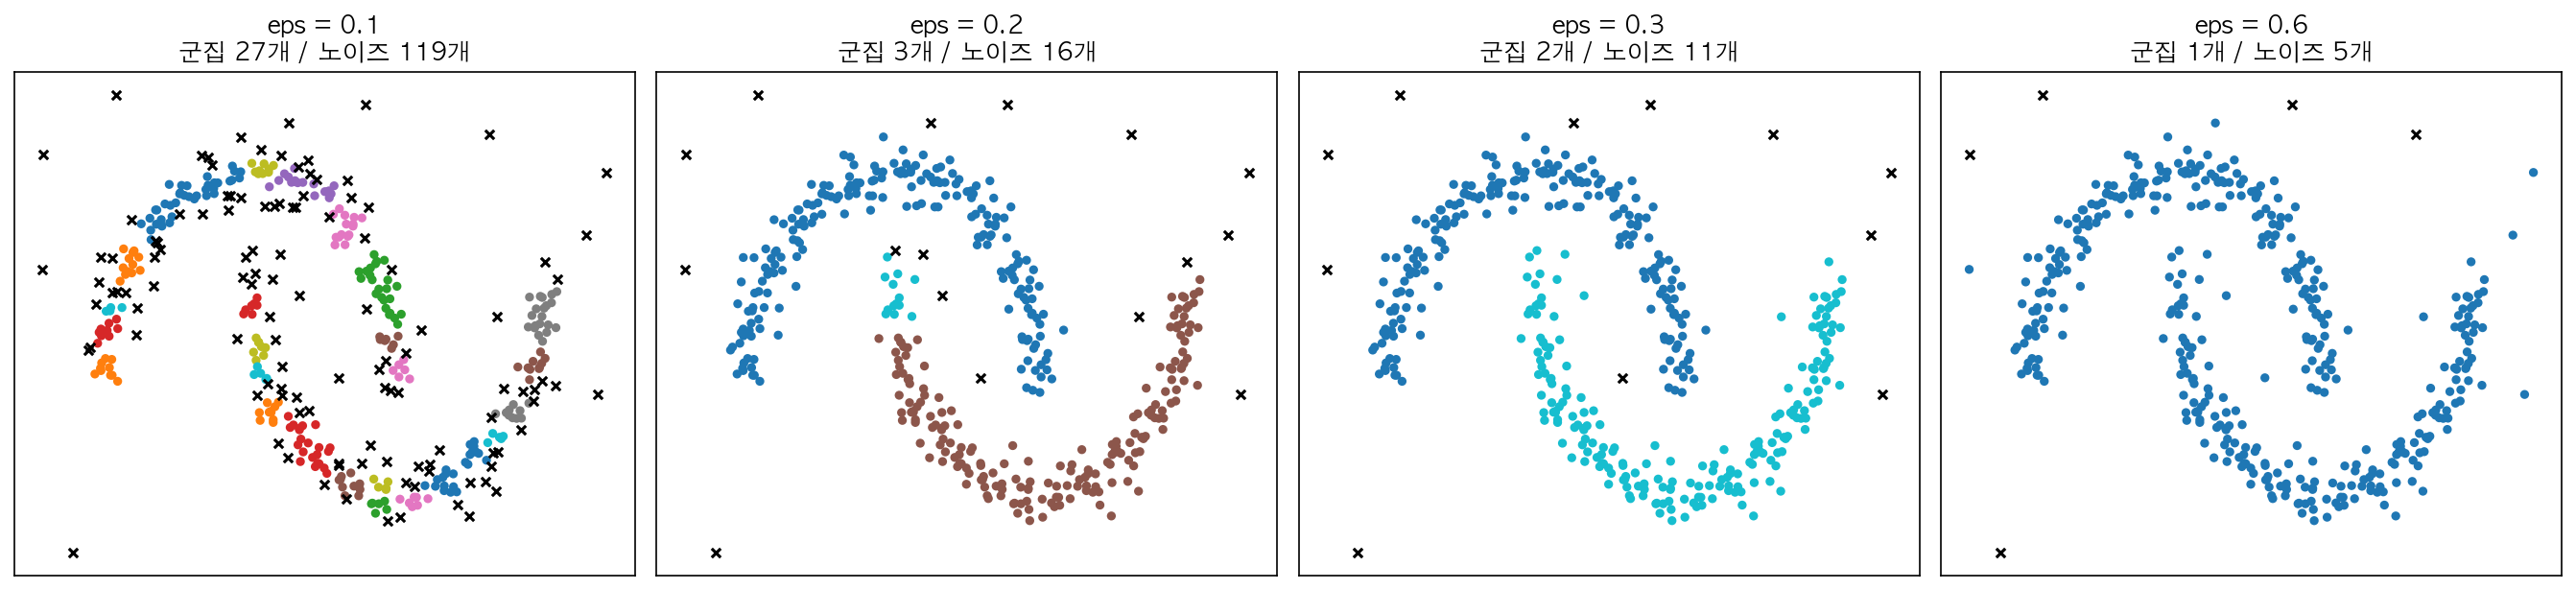
| fig, axes = plt.subplots(1, 4, figsize=(18, 4.2))
for ax, eps in zip(axes, [0.1, 0.2, 0.3, 0.6]):
lab = DBSCAN(eps=eps, min_samples=5).fit_predict(X_scaled)
noise = lab == -1
n_cl = len(set(lab)) - (1 if -1 in lab else 0)
ax.scatter(X_scaled[~noise, 0], X_scaled[~noise, 1], c=lab[~noise], cmap='tab10', s=12)
ax.scatter(X_scaled[noise, 0], X_scaled[noise, 1], c='black', marker='x', s=20)
ax.set_title(f'eps = {eps}\n군집 {n_cl}개 / 노이즈 {noise.sum()}개')
ax.set_xticks([]); ax.set_yticks([])
plt.tight_layout()
plt.show()
|
읽는 법:
eps가 너무 작으면(0.1) 이웃을 거의 찾지 못해 초승달이 여러 조각으로 쪼개지고 노이즈가 폭증합니다.
eps = 0.2에서는 아래 초승달의 끝부분이 끊어져 군집이 3개가 되고, 0.3에서 비로소 초승달 2개를 정확히 찾습니다.
즉, 올바른 결과를 주는 eps의 범위가 생각보다 좁습니다.
eps가 너무 크면(0.6) 두 초승달 사이 간격보다 반경이 커져 하나의 군집으로 합쳐집니다. eps는 군집 수를 좌우하는 가장 민감한 파라미터입니다.