1. 왜 등장했는가
Random Forest는 Bootstrap 샘플링과 특성 무작위 선택으로 트리들을 다양하게 만들어 과적합을 줄였습니다.
하지만 각 노드에서는 여전히 모든 임계값을 하나하나 비교해 최적의 분할점을 찾기 때문에, 트리들이 비슷해지고 학습 시간도 오래 걸립니다.
Extra Trees(Extremely Randomized Trees)는 분할 임계값까지 무작위로 뽑아 무작위성을 한 단계 더 높인 앙상블입니다. (Geurts, Ernst & Wehenkel, 2006)
Random Forest가 “후보 중 최고를 꼼꼼히 고르는 심사위원단”이라면,
Extra Trees는 “후보를 대충 뽑되 사람 수로 밀어붙이는 대규모 투표” 에 가깝습니다.
2. 핵심 아이디어 — “임계값도 무작위로 뽑는다”
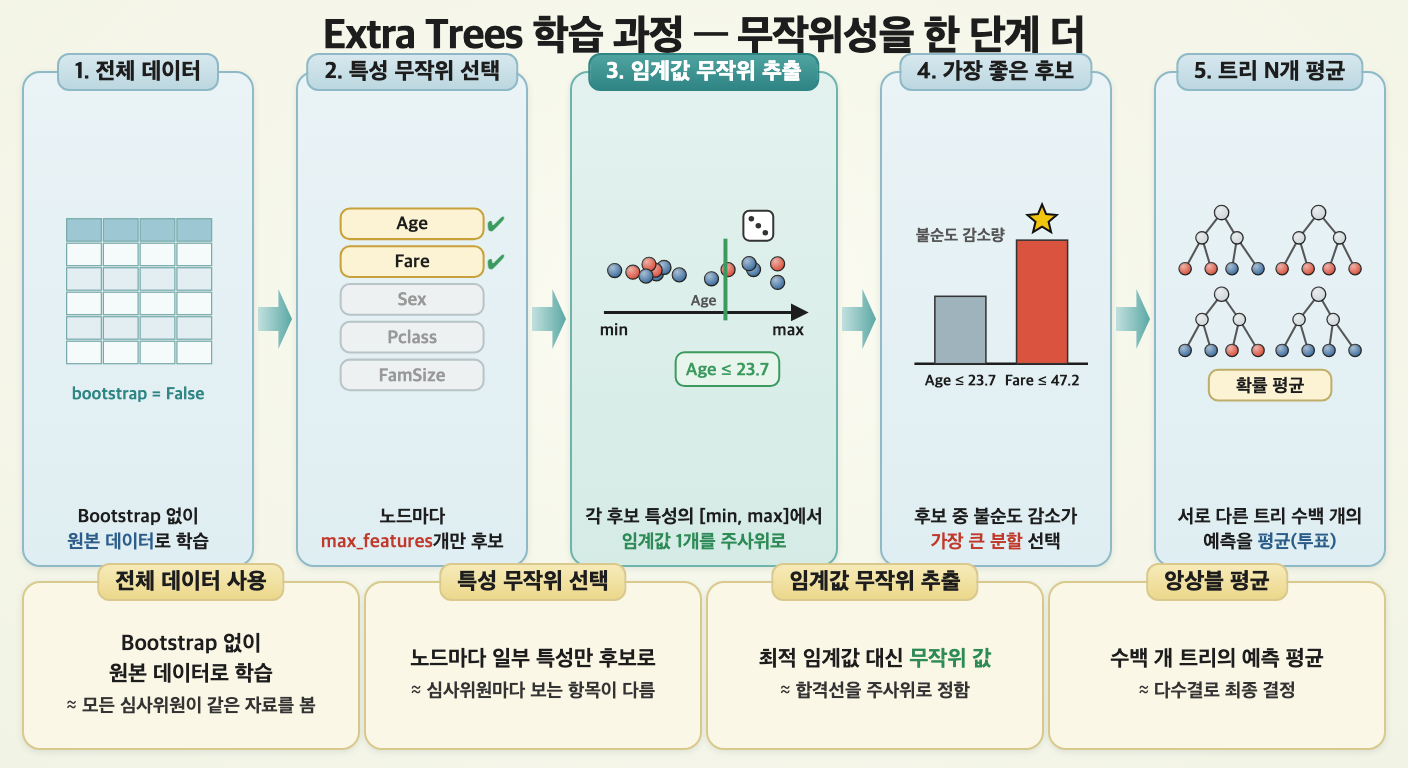
Extra Trees는 본질적으로 분할 기준을 무작위로 몇 개 뽑아서 그중 가장 나은 것만 고르는 트리를 수백 개 모은 모델입니다.
1
2
3
4
5
6
7
8
9
10
| 노드에서 "나이(Age)"로 분할한다고 할 때:
Random Forest:
가능한 모든 임계값 시도 → Age ≤ 5.5, ≤ 6.5, ..., ≤ 79.5
→ 불순도 감소가 가장 큰 Age ≤ 9.5 선택 (정확하지만 느림, 트리끼리 비슷)
Extra Trees:
Age의 [최솟값, 최댓값] 사이에서 임계값을 무작위로 1개만 뽑음 → Age ≤ 23.7
→ 다른 특성(Fare, FamSize ...)도 각각 무작위 임계값 1개씩
→ 이 후보들 중 불순도 감소가 가장 큰 것 선택 (빠르고, 트리끼리 매우 다름)
|
읽는 법:
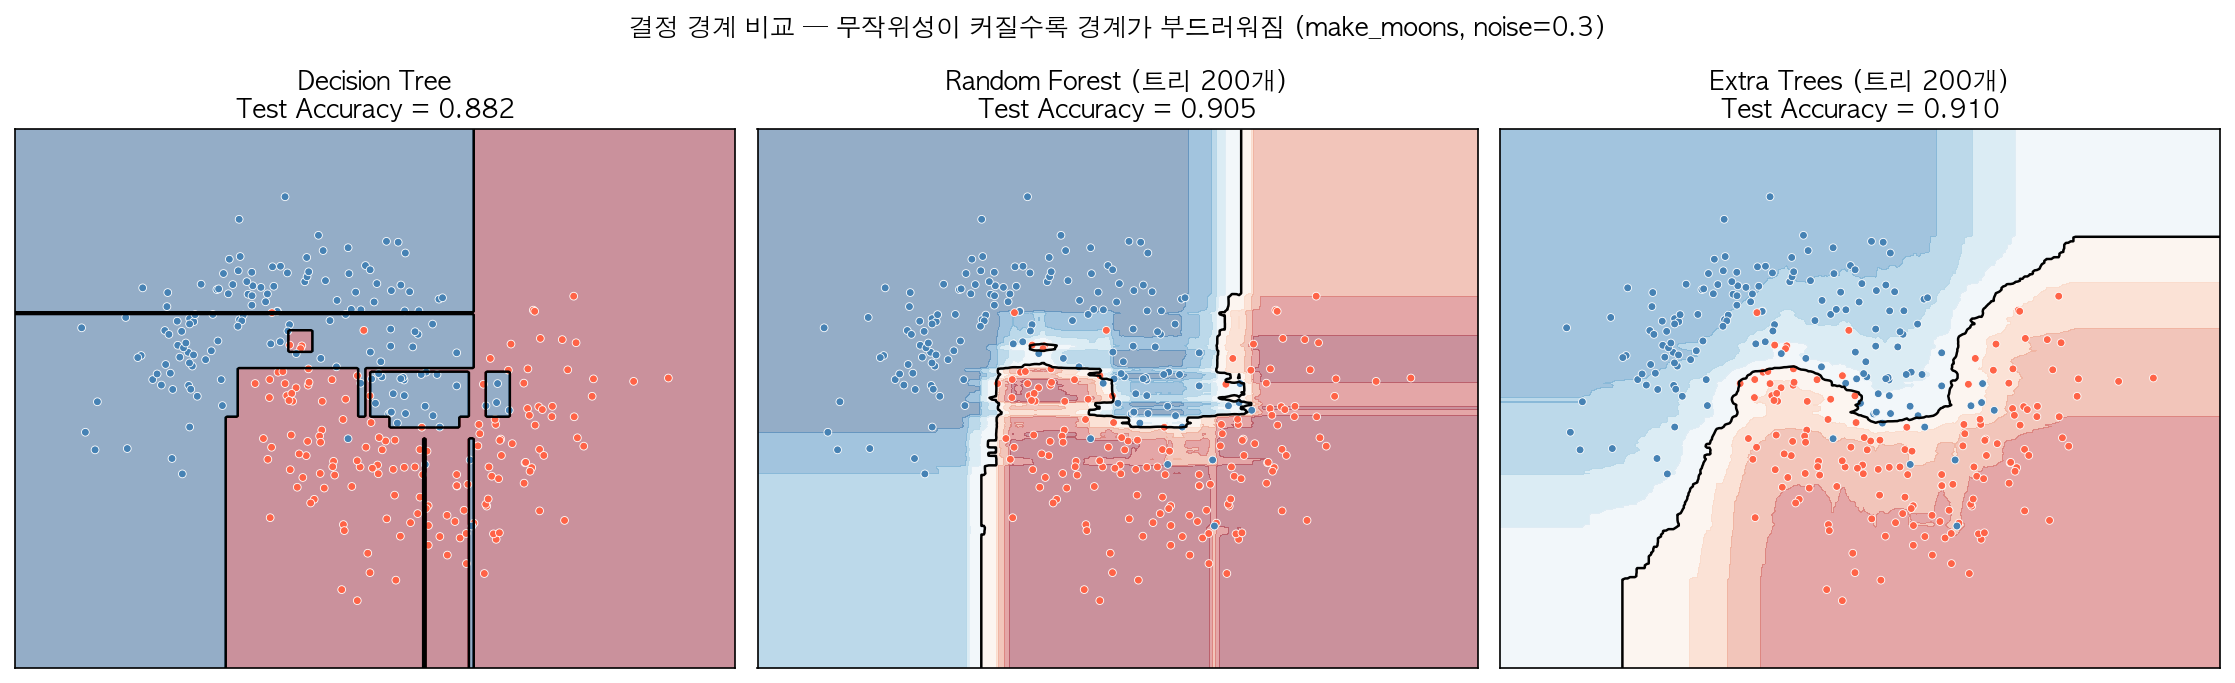
같은 초승달 데이터(make_moons)에 세 모델을 학습시킨 결정 경계입니다. 빨간색·파란색 영역은 각 클래스로 예측되는 구역입니다.
왼쪽 (Decision Tree) — 훈련 데이터의 점 하나하나에 맞추느라 경계가 계단처럼 각지고, 섬처럼 고립된 영역이 생깁니다(과적합).
가운데 (Random Forest) — 트리 200개의 투표로 경계가 훨씬 매끄러워졌지만, 축에 평행한 직선 조각이 그대로 남아 경계가 계단 모양입니다.
오른쪽 (Extra Trees) — 임계값이 무작위라 트리마다 계단의 위치가 제각각이고, 이를 평균 내면 계단이 뭉개져 더 부드러운 경계가 됩니다. 분산(Variance)이 더 줄어든 것입니다.
정확도는 RF와 ET가 비슷합니다. ET의 장점은 “항상 더 정확함”이 아니라 비슷한 성능을 더 빠르고 매끄럽게 얻는다는 데 있습니다.
3. 실제 예시로 보기 (분류 / 회귀)
예시 1 — 타이타닉 생존 예측 (분류)
1
2
3
4
5
6
7
8
9
| 트리 1: Sex ≤ 0.31 (무작위) → Fare ≤ 47.2 (무작위) → ...
트리 2: Age ≤ 61.8 (무작위) → Sex ≤ 0.77 (무작위) → ...
트리 3: Pclass_3 ≤ 0.12 → Age ≤ 8.4 → ...
...
트리 300
새 승객 (여성, 2등석, 29세):
트리 1 → 생존 / 트리 2 → 생존 / 트리 3 → 사망 / ...
생존 확률 = 생존으로 예측한 트리 비율의 평균 = 0.84 → 생존
|
이진 특성(Sex: 0/1)은 임계값을 0~1 사이 어디서 뽑든 결과가 같습니다.
따라서 범주형·이진 특성이 많은 데이터일수록 Extra Trees와 Random Forest의 차이가 작아집니다.
예시 2 — 센서 데이터로 설비 고장 예측 (분류)
1
2
3
4
5
6
7
8
9
| 특성: 온도, 진동, 압력, 전류 ... (센서 50개, 측정값 노이즈 큼)
Random Forest:
노이즈가 낀 값에 맞춘 "최적" 임계값 → 노이즈까지 학습할 위험
Extra Trees:
임계값을 무작위로 뽑으므로 특정 노이즈 값에 맞춰지지 않음
→ 노이즈가 큰 연속형 데이터에서 일반화 성능이 더 좋은 경우가 많음
→ 학습도 RF보다 빠름 (최적 임계값 탐색 생략)
|
4. 알고리즘 구성 요소
5. 왜 무작위인데 성능이 나오는가
5-1. 편향-분산 분해
\[\text{오차} = \text{편향}^2 + \text{분산} + \text{노이즈}\]
1
2
3
4
5
6
7
8
9
10
| 트리 하나만 보면:
무작위 임계값 → 개별 트리는 RF 트리보다 약간 부정확 (편향 ↑)
앙상블로 보면:
트리끼리 상관이 낮을수록 평균의 분산이 크게 감소 (분산 ↓↓)
M개 트리의 평균 분산 ≈ ρσ² + (1-ρ)σ²/M
ρ: 트리 간 상관계수
→ ρ가 작을수록(트리가 서로 다를수록) 분산이 더 많이 줄어듦
→ ET는 ρ를 RF보다 더 낮춤 → 편향 증가보다 분산 감소가 더 큼
|
5-2. 분할 규칙
1
2
3
4
5
6
7
8
9
10
| 노드에 도달한 데이터 S, 특성 후보 K개 (= max_features)
1. 특성 a₁, ..., a_K 를 무작위로 선택
2. 각 aᵢ에 대해:
aᵢ의 S 내 최솟값 min, 최댓값 max 계산
임계값 tᵢ ~ Uniform(min, max) 무작위 추출
3. 분할 후보 (aᵢ ≤ tᵢ) K개 중 불순도(Gini/Entropy) 감소가 가장 큰 것 선택
→ RF는 2번에서 "모든 임계값을 정렬해서 탐색" (정렬 비용 O(n log n))
→ ET는 임계값 1개만 계산 (O(n)) → 그래서 더 빠름
|
5-3. Bootstrap을 쓰지 않는 이유
1
2
3
4
5
6
| RF: 데이터 무작위(Bootstrap) + 특성 무작위
ET: 특성 무작위 + 임계값 무작위 ← 이미 충분히 무작위
Bootstrap까지 더하면 각 트리가 볼 수 있는 데이터가 약 63%로 줄어
편향이 더 커지므로, 원 논문은 전체 데이터 사용을 권장
→ sklearn 기본값 bootstrap=False → OOB Score를 쓰려면 bootstrap=True 필요
|
1
2
3
4
5
6
7
8
9
10
11
| 1. 학습 속도가 빠름
→ 최적 임계값 탐색(정렬)을 생략 → 같은 트리 수에서 RF보다 빠른 경우가 많음
2. 분산이 더 작음
→ 트리 간 상관이 낮아 앙상블 효과 극대화 → 노이즈 많은 데이터에 강함
3. 부드러운 결정 경계
→ 연속형 특성에서 경계가 매끄러워 일반화 성능 ↑
4. 스케일링 불필요, 과적합에 강함
→ 트리 기반의 장점을 그대로 유지
|
1
2
3
4
5
6
7
8
9
| 1. 불필요한 특성(노이즈 특성)이 많을 때
→ 무작위 임계값이 무의미한 특성에서 뽑혀도 분할이 일어남
→ 트리가 깊어지고 성능 하락
2. 이진·범주형 특성 위주 데이터
→ 임계값 무작위의 효과가 거의 없음 → RF와 차이 없음
3. 트리가 더 깊어짐
→ 분할이 덜 정확해 같은 순도에 도달하려면 더 많이 분할 → 메모리 사용량 ↑
|
6-2-1. 노이즈 특성 문제
Extra Trees의 가장 큰 약점입니다.
1
2
3
4
5
| 특성 20개 중 유용한 특성 3개 + 무관한 특성 17개
RF : 최적 임계값으로 비교 → 무관한 특성은 불순도 감소가 작아 거의 선택 안 됨
ET : 무관한 특성의 무작위 임계값과 유용한 특성의 무작위 임계값이 경쟁
→ 운 나쁘면 유용한 특성의 임계값이 나쁘게 뽑혀 무관한 특성이 선택됨
|
해결책 :
1
2
3
4
5
6
7
8
9
10
11
12
| from sklearn.ensemble import ExtraTreesClassifier
from sklearn.feature_selection import SelectFromModel
# 방법 1: max_features를 키워 후보를 늘림 → 유용한 특성이 후보에 포함될 확률 ↑
et = ExtraTreesClassifier(n_estimators=300, max_features=0.7, random_state=0)
# 방법 2: 중요도 기반으로 특성을 먼저 걸러낸 뒤 학습
selector = SelectFromModel(
ExtraTreesClassifier(n_estimators=300, random_state=0),
threshold='median' # 중요도가 중앙값 이상인 특성만 사용
)
# X_selected = selector.fit_transform(X_train, y_train)
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 지도학습 / 분류 · 회귀 (앙상블, Bagging 계열) |
| 핵심 아이디어 | 특성 + 분할 임계값까지 무작위 → 트리 간 상관 ↓ → 분산 ↓ |
| Random Forest와 차이 | 임계값 무작위 추출, 기본적으로 Bootstrap 미사용 |
| 스케일링 필요? | ❌ 불필요 |
| 핵심 파라미터 | n_estimators, max_features, min_samples_leaf |
| 실전 사용 | 노이즈 많은 연속형 데이터, 빠른 베이스라인, 특성 중요도 산출 |
8. 다른 알고리즘과 무엇이 다른가
Decision Tree vs Random Forest vs Extra Trees
1
2
3
4
5
6
7
| Decision Tree: 전체 데이터 + 전체 특성 + 최적 임계값 → 트리 1개
Random Forest: Bootstrap 데이터 + 일부 특성 + 최적 임계값 → 트리 N개 평균
Extra Trees: 전체 데이터 + 일부 특성 + 무작위 임계값 → 트리 N개 평균
무작위성: DT < RF < ET
개별 트리 정확도: DT > RF > ET
앙상블 분산: DT > RF > ET
|
| 항목 | Decision Tree | Random Forest | Extra Trees |
|---|
| 데이터 샘플링 | 전체 | Bootstrap | 전체 (기본) |
| 특성 선택 | 전체 | 무작위 일부 | 무작위 일부 |
| 임계값 | 최적값 | 최적값 | 무작위 |
| 학습 속도 | 빠름 | 보통 | 빠름 |
| 과적합 | 높음 | 낮음 | 매우 낮음 |
| OOB Score | ❌ | ✅ | bootstrap=True일 때만 |
9. 코드로 보기 — 타이타닉 생존 예측
1
2
3
4
5
6
7
8
9
10
| from sklearn.ensemble import ExtraTreesClassifier
et = ExtraTreesClassifier(
n_estimators = 300, # 생성할 트리 개수
max_features = 'sqrt', # 노드마다 후보로 쓸 특성 수
min_samples_leaf = 2, # Leaf 노드의 최소 샘플 수
bootstrap = False, # 전체 데이터로 학습 (ET 기본값)
random_state = 0,
n_jobs = -1
)
|
| Parameter | Default | 역할 | 과적합 방향 |
|---|
n_estimators | 100 | 트리 개수 | 많을수록 안정 (과적합 ↓) |
max_features | 'sqrt' | 분할 후보 특성 수 | 클수록 과적합 ↑ |
max_depth | None | 트리 최대 깊이 | 클수록 과적합 ↑ |
min_samples_split | 2 | 분할에 필요한 최소 샘플 수 | 작을수록 과적합 ↑ |
min_samples_leaf | 1 | Leaf 노드 최소 샘플 수 | 작을수록 과적합 ↑ |
bootstrap | False | Bootstrap 샘플링 여부 | - |
oob_score | False | OOB 평가 (bootstrap=True 필요) | - |
class_weight | None | 클래스 가중치 | - |
n_estimators : 트리 개수- 개별 트리가 RF보다 약하므로 RF보다 조금 더 많이 쓰는 것이 일반적 (300 ~ 1000)
- 많을수록 성능이 안정되지만 일정 수 이상이면 개선이 멈춤
max_features : 노드마다 후보로 쓸 특성 수- ET에서는 RF보다 영향이 큼 (후보가 적으면 무작위성이 너무 커짐)
- Options
'sqrt' : √M 개 (분류 기본값)float : 전체 대비 비율 (예: 0.5)None / 1.0 : 전체 특성 → 노이즈 특성이 많을 때 유리
min_samples_leaf : Leaf 최소 샘플 수- ET 트리는 깊어지기 쉬우므로 2 ~ 5 정도로 키우면 과적합과 메모리를 함께 줄일 수 있음
bootstrap : Bootstrap 사용 여부False : 전체 데이터 사용 (기본값, 원 논문 권장)True : RF처럼 복원 추출 → oob_score=True 사용 가능
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| import pandas as pd
from sklearn.model_selection import train_test_split
titanic = pd.read_csv('./Data/Titanic.csv')
titanic['FamSize'] = titanic['SibSp'] + titanic['Parch']
use_cols = ['Survived', 'Pclass', 'Sex', 'Age', 'FamSize', 'Fare', 'Embarked']
titanic = titanic[use_cols].dropna(subset=['Age'])
titanic['Age'] = titanic['Age'].astype(int)
titanic = pd.get_dummies(titanic, columns=['Pclass', 'Sex', 'Embarked'], drop_first=True)
y = titanic['Survived']
X = titanic.drop('Survived', axis=1)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=0)
# ⚠️ Extra Trees는 트리 기반 → 스케일링 불필요
|
Note: Extra Trees는 임계값을 각 특성의 [최솟값, 최댓값] 구간에서 뽑으므로 스케일에 영향을 받지 않습니다.
StandardScaler가 필요 없습니다.
9-2. 모델 학습
1
2
3
4
5
6
7
8
| et = ExtraTreesClassifier(
n_estimators = 300,
max_features = 'sqrt',
min_samples_leaf = 2,
random_state = 0,
n_jobs = -1
)
et.fit(X_train, y_train)
|
9-2-1. 교차 검증으로 하이퍼파라미터 탐색
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| from sklearn.model_selection import GridSearchCV
param_grid = {
'max_features' : ['sqrt', 0.5, 1.0],
'min_samples_leaf': [1, 2, 4, 8],
}
et_cv = GridSearchCV(
ExtraTreesClassifier(n_estimators=300, random_state=0, n_jobs=-1),
param_grid,
cv = 5,
scoring = 'roc_auc'
)
et_cv.fit(X_train, y_train)
print(f"Best params : {et_cv.best_params_}")
print(f"Best AUC : {et_cv.best_score_:.4f}")
|
9-3. 평가
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| from sklearn.metrics import (
accuracy_score, confusion_matrix,
classification_report, roc_auc_score
)
pred = et.predict(X_test)
pred_prob = et.predict_proba(X_test)[:, 1]
cfx = confusion_matrix(y_test, pred)
sensitivity = cfx[1, 1] / (cfx[1, 0] + cfx[1, 1])
specificity = cfx[0, 0] / (cfx[0, 0] + cfx[0, 1])
roc_auc = roc_auc_score(y_test, pred_prob)
print(f"Accuracy : {accuracy_score(y_test, pred) * 100:.2f}%")
print(f"Sensitivity : {sensitivity * 100:.2f}%")
print(f"Specificity : {specificity * 100:.2f}%")
print(f"ROC AUC : {roc_auc:.4f}")
print()
print(classification_report(y_test, pred, target_names=['Died (0)', 'Survived (1)']))
|
9-4. Random Forest와 속도・성능 비교
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| import time
import numpy as np
import matplotlib.pyplot as plt
from sklearn.ensemble import RandomForestClassifier
results = {}
for name, Model in [('Random Forest', RandomForestClassifier), ('Extra Trees', ExtraTreesClassifier)]:
times, aucs = [], []
for seed in range(10): # 시드 10개로 반복해 평균
m = Model(n_estimators=300, min_samples_leaf=2, random_state=seed, n_jobs=1)
start = time.perf_counter()
m.fit(X_train, y_train)
times.append(time.perf_counter() - start)
aucs.append(roc_auc_score(y_test, m.predict_proba(X_test)[:, 1]))
results[name] = (np.mean(times), np.mean(aucs), np.std(aucs))
print(f"{name:>13} | 학습 시간 : {np.mean(times):.3f}s | AUC : {np.mean(aucs):.4f} ± {np.std(aucs):.4f}")
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
names = list(results)
colors = ['steelblue', 'tomato']
axes[0].bar(names, [results[n][0] for n in names], color=colors)
axes[0].set_ylabel('학습 시간 (초)')
axes[0].set_title('학습 시간 (트리 300개, 단일 코어)')
axes[1].bar(names, [results[n][1] for n in names], yerr=[results[n][2] for n in names],
color=colors, capsize=6)
axes[1].set_ylim(0.8, 0.9)
axes[1].set_ylabel('Test ROC AUC')
axes[1].set_title('ROC AUC (시드 10개 평균 ± 표준편차)')
for ax in axes:
ax.grid(True, axis='y', alpha=0.3)
plt.tight_layout()
plt.show()
|
읽는 법:
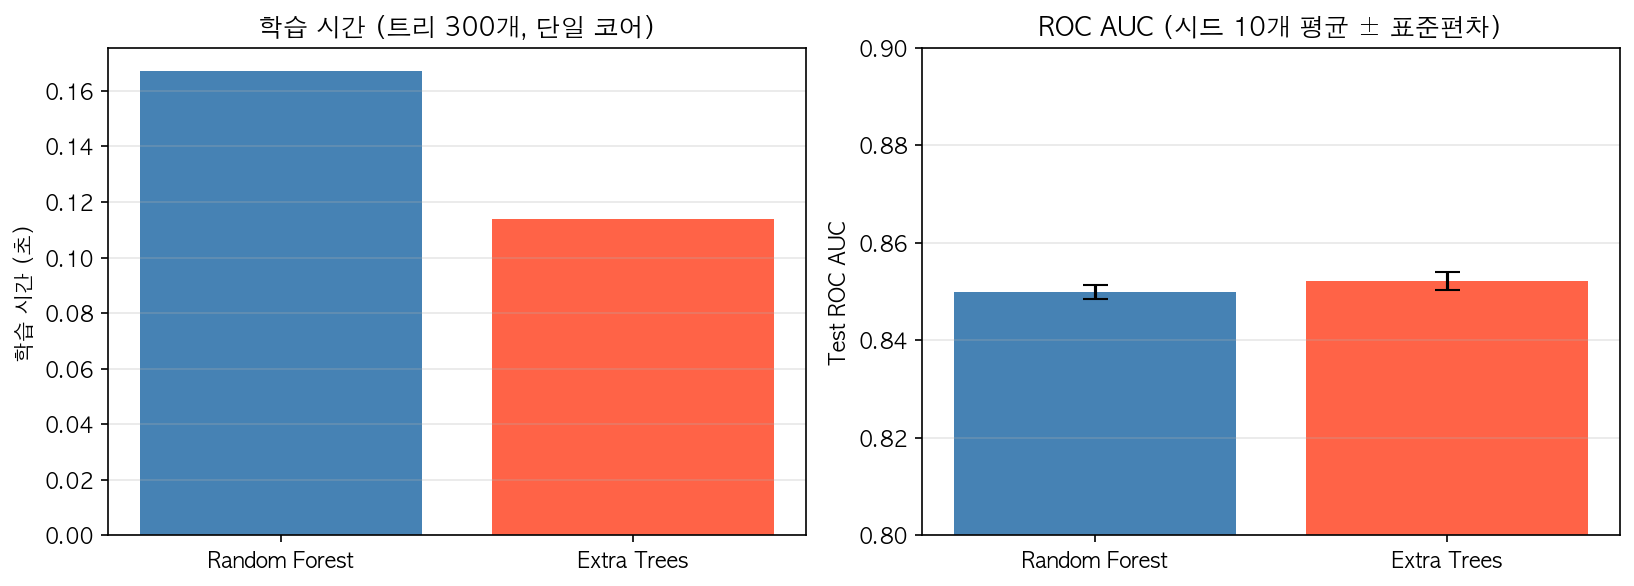
왼쪽은 같은 조건(트리 300개, 코어 1개)에서의 학습 시간, 오른쪽은 시드를 바꿔 10번 학습한 테스트 AUC의 평균과 표준편차(검은 막대)입니다.
이번 실행에서는 RF 0.167초 → ET 0.114초로 약 30% 빨랐고, AUC는 0.850 vs 0.852로 거의 같았습니다.
Extra Trees는 최적 임계값 탐색을 생략하므로 데이터가 커질수록 속도 차이가 더 벌어집니다.
성능은 데이터에 따라 RF와 비슷하거나 약간 차이가 나며, 어느 쪽이 항상 이긴다고 할 수 없으므로 두 모델을 모두 시도해 보는 것이 좋습니다.
9-5. 특성 중요도
1
2
3
4
5
6
7
8
9
| importance = pd.Series(et.feature_importances_, index=X.columns).sort_values()
plt.figure(figsize=(7, 5))
importance.plot(kind='barh', color='tomato')
plt.xlabel('Feature Importance (불순도 감소량 평균)')
plt.title('Extra Trees 특성 중요도')
plt.grid(True, axis='x', alpha=0.3)
plt.tight_layout()
plt.show()
|
읽는 법:
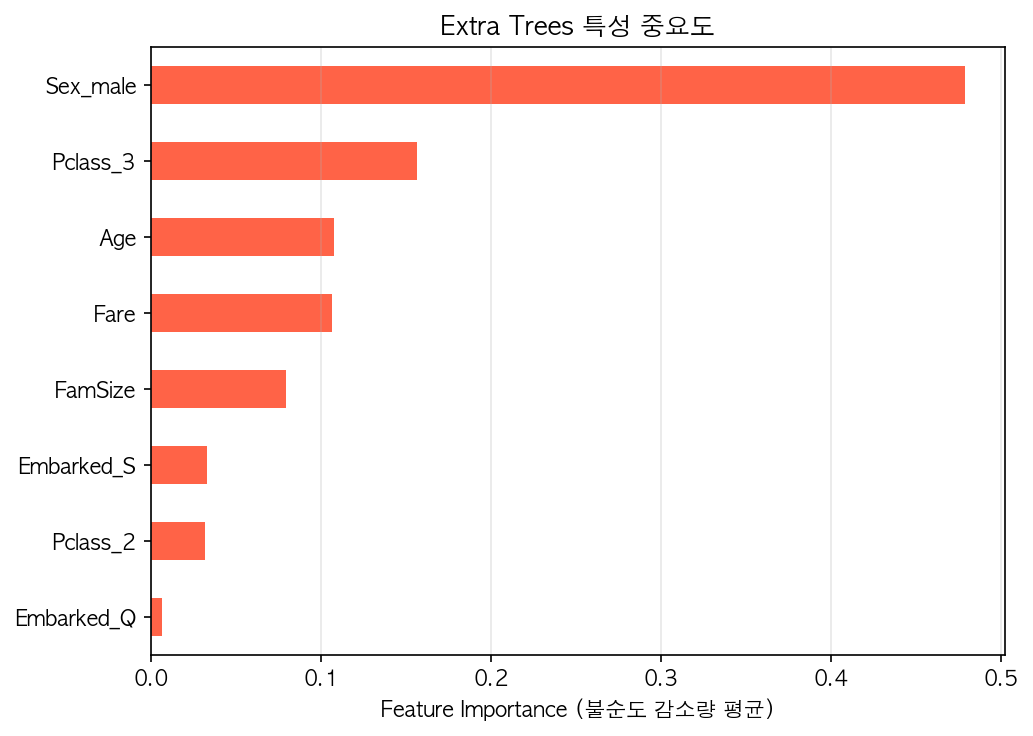
막대가 길수록 트리들이 그 특성으로 분할했을 때 불순도를 많이 줄였다는 뜻입니다.
성별(Sex_male)이 압도적으로 중요하고, 그다음이 3등석 여부(Pclass_3), 나이·요금 순입니다.
Extra Trees는 임계값이 무작위라 연속형 특성(Age, Fare)의 중요도가 RF보다 과대평가되는 경향이 덜하다는 장점도 있습니다.