1. 왜 등장했는가
K-Means는 각 점을 딱 하나의 군집에만 배정(Hard Clustering)하고, 모든 군집이 같은 크기의 원형이라고 가정합니다.
하지만 실제 데이터는 길쭉하거나 기울어진 타원 모양의 군집이 많고, 두 군집 경계에 있는 점은 “A일 확률 60%, B일 확률 40%”처럼 애매하게 표현하는 것이 더 자연스러운 경우가 많습니다.
GMM(Gaussian Mixture Model, 가우시안 혼합 모델)은 데이터가 여러 개의 정규분포(가우시안)가 섞여서 만들어졌다고 보고, 각 정규분포의 평균·공분산·비율을 추정하는 확률적 군집 모델입니다.
K-Means가 “이 점은 무조건 A반”이라고 반을 배정하는 방식이라면,
GMM은 “이 점이 A반일 확률 70%, B반일 확률 30%”라고 확률을 매기는 방식입니다.
2. 핵심 아이디어 — “데이터는 여러 정규분포의 혼합이다”
GMM은 본질적으로 K개의 타원형 정규분포를 데이터에 겹쳐 놓고, 데이터를 가장 잘 설명하도록 각 타원의 위치·모양·크기를 조정하는 모델입니다.
1
2
3
4
5
6
7
8
9
10
11
12
| 키 데이터 1,000명 (성별 정보 없음)
히스토그램을 보면 봉우리가 2개 → 정규분포 2개가 섞인 것으로 가정
GMM (K = 2) 추정 결과:
분포 1: 평균 162cm, 표준편차 5.5cm, 비율 48% → (아마도 여성)
분포 2: 평균 175cm, 표준편차 6.0cm, 비율 52% → (아마도 남성)
키 168cm인 사람:
분포 1에 속할 확률 = 0.45
분포 2에 속할 확률 = 0.55 ← 경계 근처라 확률이 비슷함
→ K-Means라면 "무조건 분포 2"로 배정했을 것
|
읽는 법:
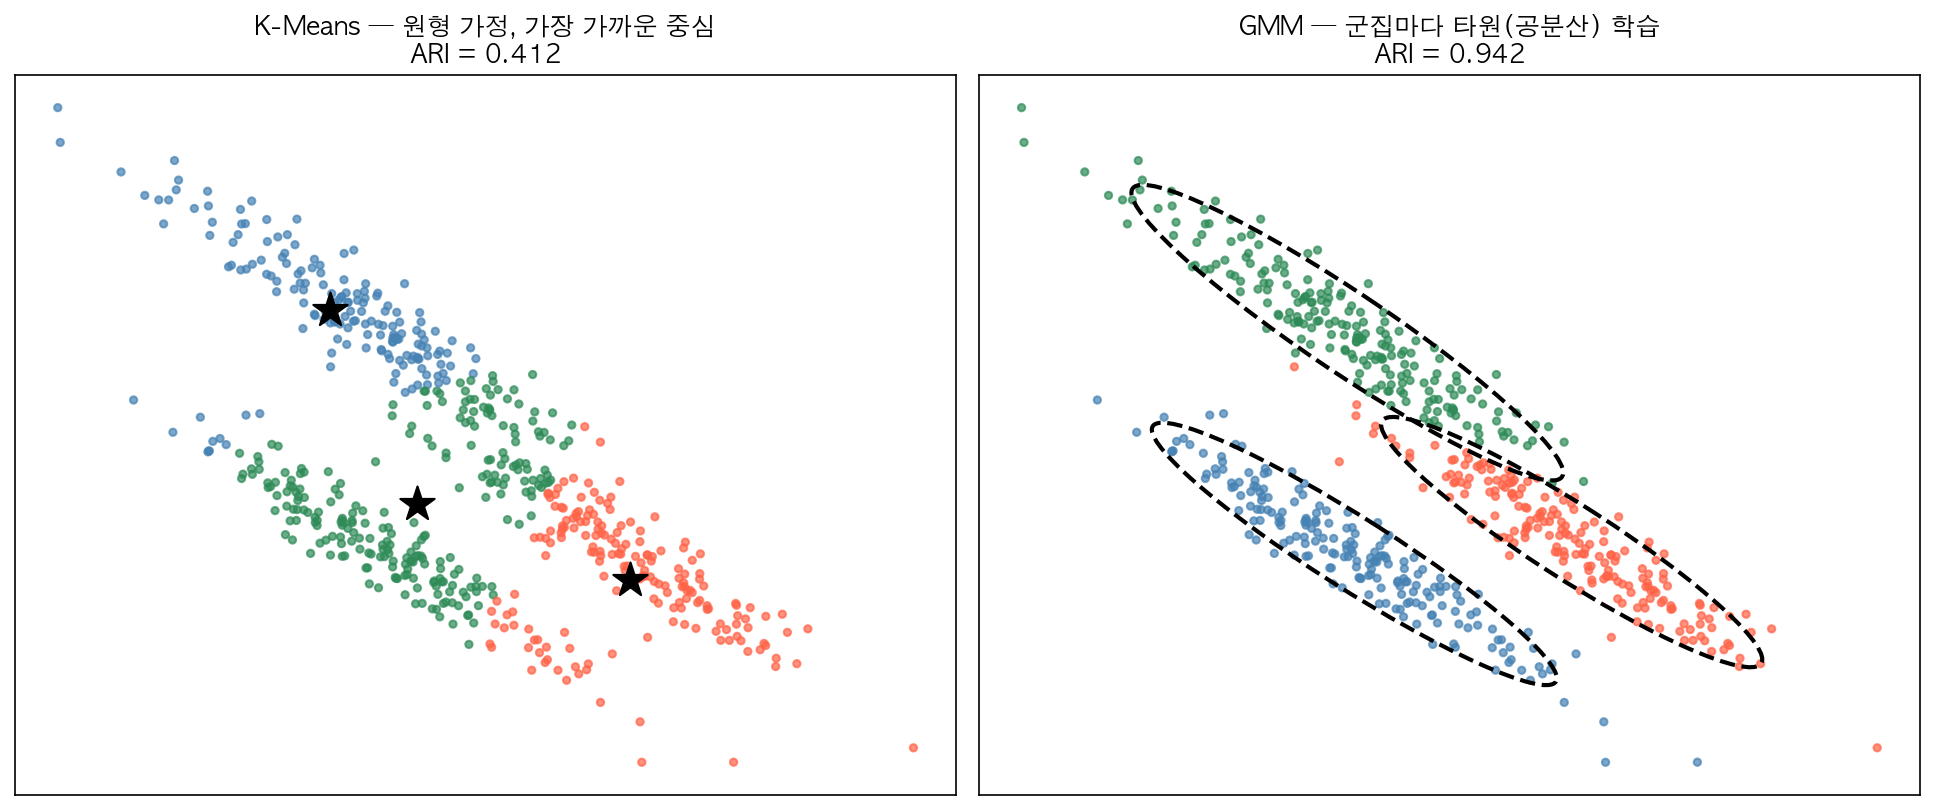
비스듬하게 늘어난 타원 모양의 군집 3개가 있는 데이터입니다.
왼쪽 (K-Means) — 모든 군집을 원형으로 가정하고 가장 가까운 중심으로 나누기 때문에, 길쭉한 군집을 가로질러 잘라버립니다.
오른쪽 (GMM) — 군집마다 타원의 방향과 크기(공분산)를 따로 학습해 데이터 모양에 맞게 군집을 찾습니다. 점선 타원은 각 가우시안 분포의 2 표준편차 범위입니다.
실제 구조와의 일치도(ARI)는 K-Means 0.41, GMM 0.94입니다.
3. 실제 예시로 보기 (군집 / 밀도 추정)
예시 1 — 고객 세분화와 소프트 배정 (군집)
1
2
3
4
5
6
7
8
9
10
11
12
13
| 특성: 월평균 구매액, 월 방문 횟수
GMM (K = 3) 결과 — 고객별 소속 확률:
┌────────┬──────────┬──────────┬──────────┬──────────────────┐
│ 고객 │ 알뜰형 │ 일반형 │ VIP형 │ 해석 │
├────────┼──────────┼──────────┼──────────┼──────────────────┤
│ A │ 0.95 │ 0.05 │ 0.00 │ 확실한 알뜰형 │
│ B │ 0.02 │ 0.10 │ 0.88 │ 확실한 VIP │
│ C │ 0.00 │ 0.52 │ 0.48 │ VIP 전환 후보 ✅ │
└────────┴──────────┴──────────┴──────────┴──────────────────┘
→ 고객 C처럼 두 군집에 걸친 고객을 골라 "VIP 전환 캠페인" 대상으로 활용
→ K-Means는 C를 그냥 "일반형"으로 배정해 이런 정보를 잃음
|
예시 2 — 이상치 탐지 (밀도 추정)
1
2
3
4
5
6
7
8
| 정상 서버 로그 (CPU 사용률, 메모리 사용률, 응답 시간)로 GMM 학습
GMM은 확률 밀도 함수 p(x)를 제공:
정상 패턴과 비슷한 로그 → p(x) 높음
처음 보는 패턴의 로그 → p(x) 매우 낮음
score_samples(x) = log p(x) 가 하위 1% 미만 → 이상 로그로 경보
→ 레이블 없이도 "얼마나 이상한가"를 연속적인 점수로 계산 가능
|
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| ┌────────────────────────────────────────┐
│ K개 가우시안 초기화 (보통 K-Means 결과) │ ← 평균 μₖ, 공분산 Σₖ, 비율 πₖ
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ E-step: 각 점의 군집별 소속 확률 계산 │ ← 책임도 γᵢₖ
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ M-step: 소속 확률을 가중치로 │
│ μₖ, Σₖ, πₖ 다시 추정 │
└──────────────────┬─────────────────────┘
│
로그 가능도 변화 < tol? ── No ──→ E-step으로
│ Yes
▼
┌────────────────────────────────────────┐
│ n_init번 반복 → 가능도가 가장 큰 결과 │
└────────────────────────────────────────┘
|
읽는 법:
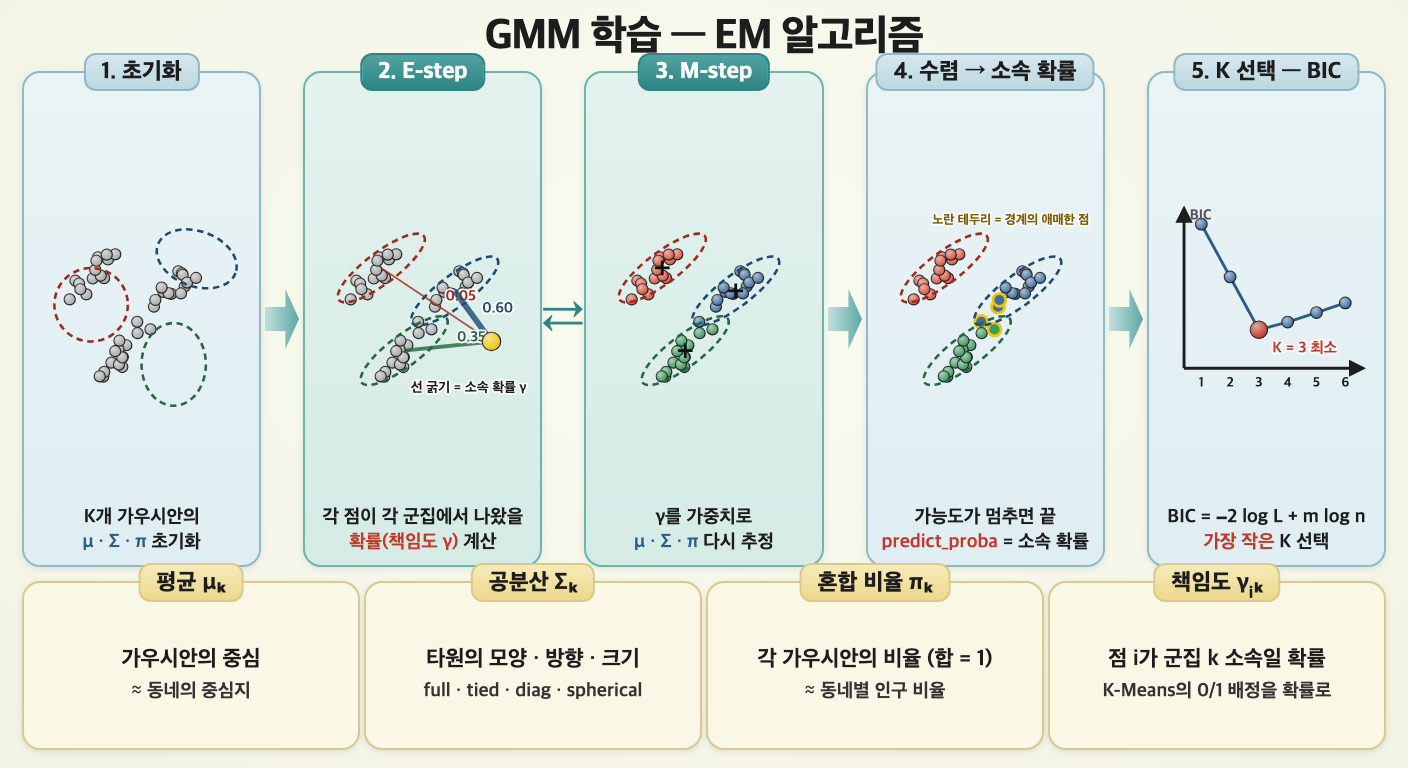
GMM을 학습하는 EM 알고리즘의 흐름을 왼쪽부터 순서대로 그린 그림입니다. 2·3번(청록색)이 수렴할 때까지 반복됩니다.
1 — 가우시안 K개의 평균·공분산·비율을 임의로(보통 K-Means 결과로) 초기화합니다.
2 (E-step) — 각 점이 각 가우시안에서 나왔을 확률(책임도 γ)을 계산합니다. 선이 굵을수록 확률이 높습니다(노란 점: 0.05 / 0.60 / 0.35).
3 (M-step) — 책임도를 가중치로 삼아 각 타원의 위치·모양·비율을 다시 추정합니다.
4 — 가능도가 더 이상 좋아지지 않으면 멈춥니다. 노란 테두리 점처럼 경계에 있는 점은 두 군집에 걸친 소속 확률을 갖습니다.
5 — 군집 수 K는 BIC가 가장 작은 값으로 고릅니다.
아래 네 칸은 GMM이 추정하는 네 가지 값입니다.
| 구성 요소 | 설명 | 비유 |
|---|
| 평균 μₖ | k번째 가우시안의 중심 | 동네의 중심지 |
| 공분산 Σₖ | k번째 가우시안의 모양·방향·크기 | 동네가 퍼진 모양 (길쭉한지, 둥근지) |
| 혼합 비율 πₖ | k번째 가우시안이 차지하는 비율 | 동네별 인구 비율 |
| 책임도 γᵢₖ | 점 i가 군집 k에서 나왔을 확률 | 이 사람이 각 동네 주민일 확률 |
5. 어떻게 분포를 추정하는가
5-1. 혼합 모델
\[p(x) = \sum_{k=1}^{K} \pi_k \, \mathcal{N}(x \mid \mu_k, \Sigma_k), \qquad \sum_{k=1}^{K}\pi_k = 1\]
1
2
3
4
5
6
| 데이터 한 점이 만들어지는 과정을 이렇게 가정:
1. 확률 πₖ에 따라 K개 가우시안 중 하나를 고름
2. 고른 가우시안 N(μₖ, Σₖ)에서 점 하나를 뽑음
→ 우리는 2번의 결과(점)만 보고, 1번(어느 가우시안인지)은 모름 (잠재 변수)
→ 이 "숨겨진 소속"과 각 가우시안의 파라미터를 동시에 추정해야 함 → EM 알고리즘
|
5-2. EM 알고리즘 (Expectation-Maximization)
\[\text{E-step}: \quad \gamma_{ik} = \frac{\pi_k \, \mathcal{N}(x_i \mid \mu_k, \Sigma_k)}{\sum_{j=1}^{K}\pi_j \, \mathcal{N}(x_i \mid \mu_j, \Sigma_j)}\] \[\text{M-step}: \quad N_k = \sum_i \gamma_{ik}, \quad \mu_k = \frac{1}{N_k}\sum_i \gamma_{ik}\, x_i, \quad \Sigma_k = \frac{1}{N_k}\sum_i \gamma_{ik}(x_i - \mu_k)(x_i - \mu_k)^T, \quad \pi_k = \frac{N_k}{n}\]
1
2
3
4
5
6
7
8
| E-step: 현재 파라미터로 "각 점이 각 군집에서 나왔을 확률"(책임도) 계산
M-step: 책임도를 가중치로 삼아 평균·공분산·비율을 다시 계산
(책임도 0.9인 점은 90%만큼, 0.1인 점은 10%만큼 반영)
→ 반복할수록 로그 가능도(데이터를 설명하는 정도)가 항상 증가 → 수렴 보장
→ K-Means와 마찬가지로 지역 최적해 가능 → n_init으로 여러 번 실행
※ K-Means = 공분산을 모두 같은 원형으로 고정하고 책임도를 0/1로만 쓰는 GMM의 특수한 경우
|
5-3. 공분산 유형 (covariance_type)
| 유형 | 각 군집의 모양 | 파라미터 수 | 특징 |
|---|
'full' | 군집마다 자유로운 타원 (방향·크기 모두) | 가장 많음 | 가장 유연, 기본값 |
'tied' | 모든 군집이 같은 타원 공유 | 중간 | LDA와 같은 가정 |
'diag' | 축에 평행한 타원 (특성 간 상관 무시) | 적음 | 고차원에서 안정적 |
'spherical' | 군집마다 크기만 다른 원 | 가장 적음 | K-Means에 가까움 |
5-4. K 선택 — BIC / AIC
\[\text{BIC} = -2\log L + m \log n \qquad \text{AIC} = -2\log L + 2m\]
1
2
3
4
5
6
7
8
| L : 가능도 (데이터를 얼마나 잘 설명하는가) → 클수록 좋음
m : 모델 파라미터 수 → K가 클수록 증가 (복잡도 벌점)
n : 데이터 수
K를 늘리면 가능도 L은 항상 좋아짐 → 그대로 고르면 과적합
BIC/AIC = "설명력 − 복잡도 벌점" → 가장 작은 값의 K 선택
BIC는 n이 클수록 벌점이 커져 더 단순한 모델을 선호 (실무에서 더 많이 사용)
|
6. GMM 장・단점
6-1. ✅ GMM 장점
1
2
3
4
5
6
7
8
9
10
11
| 1. 소프트 군집 (확률 출력)
→ 경계에 있는 점의 불확실성을 표현 → predict_proba
2. 타원형 군집
→ 공분산으로 군집의 방향·크기를 학습 → K-Means보다 유연
3. 밀도 추정
→ p(x)를 계산할 수 있어 이상치 탐지, 새 데이터 생성(sample)에 활용
4. 통계적 기준으로 K 선택
→ BIC / AIC로 군집 수를 객관적으로 비교
|
6-2. ❌ GMM이 약한 상황
1
2
3
4
5
6
7
8
9
10
11
12
| 1. 가우시안이 아닌 모양의 군집
→ 초승달·고리 모양은 여러 가우시안으로 억지로 근사 → DBSCAN 고려
2. 고차원 데이터
→ full 공분산은 군집마다 p(p+1)/2개 파라미터 → 과적합, 수치 불안정
→ covariance_type='diag' 또는 PCA로 차원 축소 후 적용
3. 초기값에 민감, 지역 최적해
→ n_init을 늘려 여러 번 실행
4. K-Means보다 느림
→ 반복마다 공분산 행렬과 역행렬 계산
|
6-2-1. 공분산 특이(Singular) 문제
GMM의 가장 큰 약점입니다.
1
2
3
4
5
6
| 군집 하나가 점 몇 개만 차지하거나, 같은 값이 반복되는 점들을 차지하면
→ 그 군집의 분산이 0에 가까워짐 → 가우시안이 한 점에 뾰족하게 몰림
→ 가능도가 무한대로 발산 (의미 없는 "완벽한" 적합)
→ 공분산 역행렬 계산 실패
sklearn은 공분산 대각선에 작은 값(reg_covar)을 더해 이를 방지
|
해결책 :
1
2
3
4
5
6
7
8
9
10
| from sklearn.mixture import GaussianMixture
# 방법 1: reg_covar를 키워 공분산 안정화
gmm = GaussianMixture(n_components=3, reg_covar=1e-3, random_state=0)
# 방법 2: 더 단순한 공분산 유형 사용
gmm = GaussianMixture(n_components=3, covariance_type='diag', random_state=0)
# 방법 3: n_init을 늘려 나쁜 초기값으로 인한 퇴화 해 회피
gmm = GaussianMixture(n_components=3, n_init=10, random_state=0)
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 비지도학습 / 군집 · 밀도 추정 (확률 모델) |
| 핵심 아이디어 | 데이터 = K개 가우시안의 혼합 → EM 알고리즘으로 평균·공분산·비율 추정 |
| 군집 방식 | 소프트 군집 (각 점의 군집별 확률) |
| 스케일링 필요? | ✅ 권장 (full 공분산은 이론상 불변이지만 수치 안정성과 diag/spherical 사용 시 필요) |
| 핵심 파라미터 | n_components, covariance_type, n_init |
| K 선택 | BIC, AIC |
| 실전 사용 | 타원형 군집, 고객 세분화(소프트 배정), 이상치 탐지, 음성 인식 |
8. 다른 알고리즘과 무엇이 다른가
K-Means vs GMM
1
2
3
4
5
6
7
8
9
| K-Means: 거리 기반 Hard 배정 → 각 점은 군집 하나에만
모든 군집이 같은 크기의 원형이라고 가정
SSE 최소화
GMM: 확률 기반 Soft 배정 → 각 점은 모든 군집에 확률적으로 소속
군집마다 다른 크기·방향의 타원 허용
로그 가능도 최대화 (EM)
K-Means ≈ GMM(covariance_type='spherical', 모든 분산 동일, 책임도 0/1)
|
| 항목 | K-Means | GMM |
|---|
| 배정 방식 | Hard (0/1) | Soft (확률) |
| 군집 모양 | 원형 | 타원형 |
| 추정 대상 | 중심 | 평균 + 공분산 + 비율 |
| 최적화 | SSE 최소화 | 가능도 최대화 (EM) |
| K 선택 | Elbow, Silhouette | BIC, AIC |
| 밀도 추정 | ❌ | ✅ score_samples |
| 속도 | 빠름 | 느림 |
9. 코드로 보기 — 타원형 군집 데이터
1
2
3
4
5
6
7
8
9
| from sklearn.mixture import GaussianMixture
gmm = GaussianMixture(
n_components = 3, # 가우시안(군집) 수
covariance_type = 'full', # 공분산 형태
n_init = 5, # 초기값 바꿔 실행할 횟수
init_params = 'kmeans', # 초기화 방법
random_state = 0
)
|
| Parameter | Default | 역할 | 비고 |
|---|
n_components | 1 | 가우시안 수 K | BIC로 탐색 |
covariance_type | 'full' | 공분산 형태 | 'tied', 'diag', 'spherical' |
n_init | 1 | 초기값 바꿔 실행할 횟수 | 클수록 안정 |
init_params | 'kmeans' | 초기화 방법 | 'k-means++', 'random' |
max_iter | 100 | EM 최대 반복 | - |
tol | 1e-3 | 수렴 판정 (가능도 변화량) | - |
reg_covar | 1e-6 | 공분산 대각선에 더하는 값 | 특이 행렬 방지 |
n_components : 가우시안 수- K-Means의 K와 같은 역할, BIC가 최소인 값을 선택
covariance_type : 군집 모양의 자유도'full' : 가장 유연 (기본값), 데이터가 충분할 때'diag' : 특성이 많거나 데이터가 적을 때- BIC로 K와 함께 비교하면 데이터에 맞는 조합을 고를 수 있음
n_init : 기본값 1은 지역 최적해에 빠지기 쉬움 → 5~10 권장reg_covar : 공분산 정규화ConvergenceWarning이나 특이 행렬 오류가 나면 키움
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
12
| import numpy as np
from sklearn.datasets import make_blobs
from sklearn.preprocessing import StandardScaler
# 원형 군집 3개를 만든 뒤, 선형 변환으로 비스듬한 타원 모양으로 늘림
X, y_true = make_blobs(n_samples=600, centers=3, cluster_std=2.3, random_state=8)
transformation = [[0.6, -0.64], [-0.41, 0.85]]
X = X @ transformation
# ✅ 스케일 맞추기 (수치 안정성)
X_scaled = StandardScaler().fit_transform(X)
print(X_scaled.shape)
|
Note: covariance_type='full'인 GMM은 이론상 스케일에 영향을 받지 않지만, 특성 간 단위 차이가 크면 공분산 추정이 수치적으로 불안정해질 수 있습니다.
'diag'나 'spherical'을 쓴다면 스케일링이 결과에 직접 영향을 주므로 반드시 맞춰야 합니다.
9-2. 최적의 K와 공분산 유형 찾기 (BIC)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| import matplotlib.pyplot as plt
K_range = range(1, 8)
cov_types = ['spherical', 'diag', 'tied', 'full']
bic = {ct: [] for ct in cov_types}
for ct in cov_types:
for k in K_range:
g = GaussianMixture(n_components=k, covariance_type=ct, n_init=5, random_state=0).fit(X_scaled)
bic[ct].append(g.bic(X_scaled))
plt.figure(figsize=(9, 4.5))
for ct, marker in zip(cov_types, ['o', 's', '^', 'D']):
plt.plot(K_range, bic[ct], marker=marker, lw=2, label=ct)
plt.xlabel('n_components (K)')
plt.ylabel('BIC (낮을수록 좋음)')
plt.title('GMM — K와 공분산 유형별 BIC')
plt.legend(title='covariance_type')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
best = min(((ct, k) for ct in cov_types for k in K_range), key=lambda t: bic[t[0]][t[1] - 1])
print(f"최적 조합 : covariance_type = '{best[0]}', K = {best[1]}")
|
읽는 법:
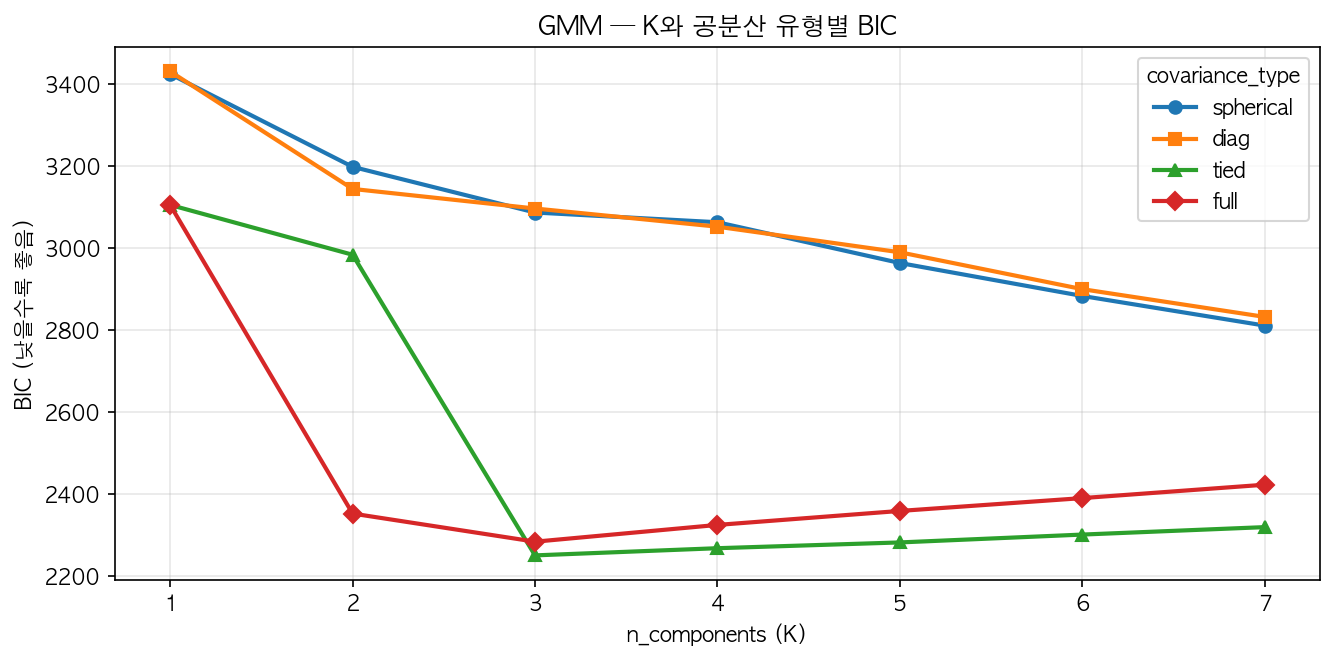
선마다 공분산 유형이 다르고, 가로축은 군집 수 K, 세로축은 BIC(낮을수록 좋음)입니다.
tied(모든 군집이 같은 타원 공유)와 full(군집마다 자유로운 타원)은 모두 K=3에서 BIC가 최소이고, 그 뒤로는 K를 늘려도 BIC가 오히려 커집니다. 설명력 향상보다 복잡도 벌점이 더 커지기 때문입니다.
최적 조합이 tied인 것은 이 데이터가 원형 군집 3개에 같은 선형 변환을 적용해 만든 것이라, 실제로 세 군집의 타원 모양이 똑같기 때문입니다. 같은 성능이면 파라미터가 적은 쪽을 고르는 BIC의 성격이 그대로 드러납니다.
spherical·diag는 축에 평행하거나 둥근 모양만 허용하므로 비스듬한 타원을 표현하지 못해, K를 7까지 늘려도 BIC가 계속 높습니다.
9-3. 모델 학습
1
2
3
4
5
6
7
| gmm = GaussianMixture(n_components=3, covariance_type='full', n_init=5, random_state=0)
labels = gmm.fit_predict(X_scaled)
proba = gmm.predict_proba(X_scaled) # 각 점의 군집별 소속 확률
print(f"수렴 여부 : {gmm.converged_}")
print(f"EM 반복 횟수 : {gmm.n_iter_}")
print(f"혼합 비율 (π) : {gmm.weights_.round(3)}")
|
9-4. 평가 — K-Means와 비교
1
2
3
4
5
6
7
8
| from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score, silhouette_score
km_labels = KMeans(n_clusters=3, n_init=10, random_state=0).fit_predict(X_scaled)
for name, lab in [('K-Means', km_labels), ('GMM', labels)]:
print(f"{name:>7} | ARI : {adjusted_rand_score(y_true, lab):.4f} | "
f"Silhouette : {silhouette_score(X_scaled, lab):.4f}")
|
1
2
| K-Means | ARI : 0.4117 | Silhouette : 0.4128
GMM | ARI : 0.9416 | Silhouette : 0.4060
|
Note: 실루엣 점수는 “둥근” 군집을 선호하므로, 실제 구조를 더 잘 찾은 GMM보다 K-Means의 실루엣이 더 높게 나오기도 합니다.
타원형 군집에서는 실루엣보다 BIC와 시각화로 판단하는 것이 더 정확합니다.
9-5. 소프트 군집 — 소속 확률 시각화
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| confidence = proba.max(axis=1) # 가장 높은 소속 확률 = 확신도
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
axes[0].scatter(X_scaled[:, 0], X_scaled[:, 1], c=labels, cmap='viridis', s=15)
axes[0].set_title('GMM 군집 결과 (Hard 배정)')
sc = axes[1].scatter(X_scaled[:, 0], X_scaled[:, 1], c=confidence, cmap='RdYlGn', s=15, vmin=0.5, vmax=1)
plt.colorbar(sc, ax=axes[1], label='최대 소속 확률')
uncertain = confidence < 0.8
axes[1].scatter(X_scaled[uncertain, 0], X_scaled[uncertain, 1],
facecolors='none', edgecolors='black', s=50, lw=1, label=f'확률 < 0.8 ({uncertain.sum()}개)')
axes[1].set_title('소속 확률 (Soft 배정) — 경계의 점은 확신이 낮음')
axes[1].legend()
for ax in axes:
ax.grid(True, alpha=0.2)
plt.tight_layout()
plt.show()
|
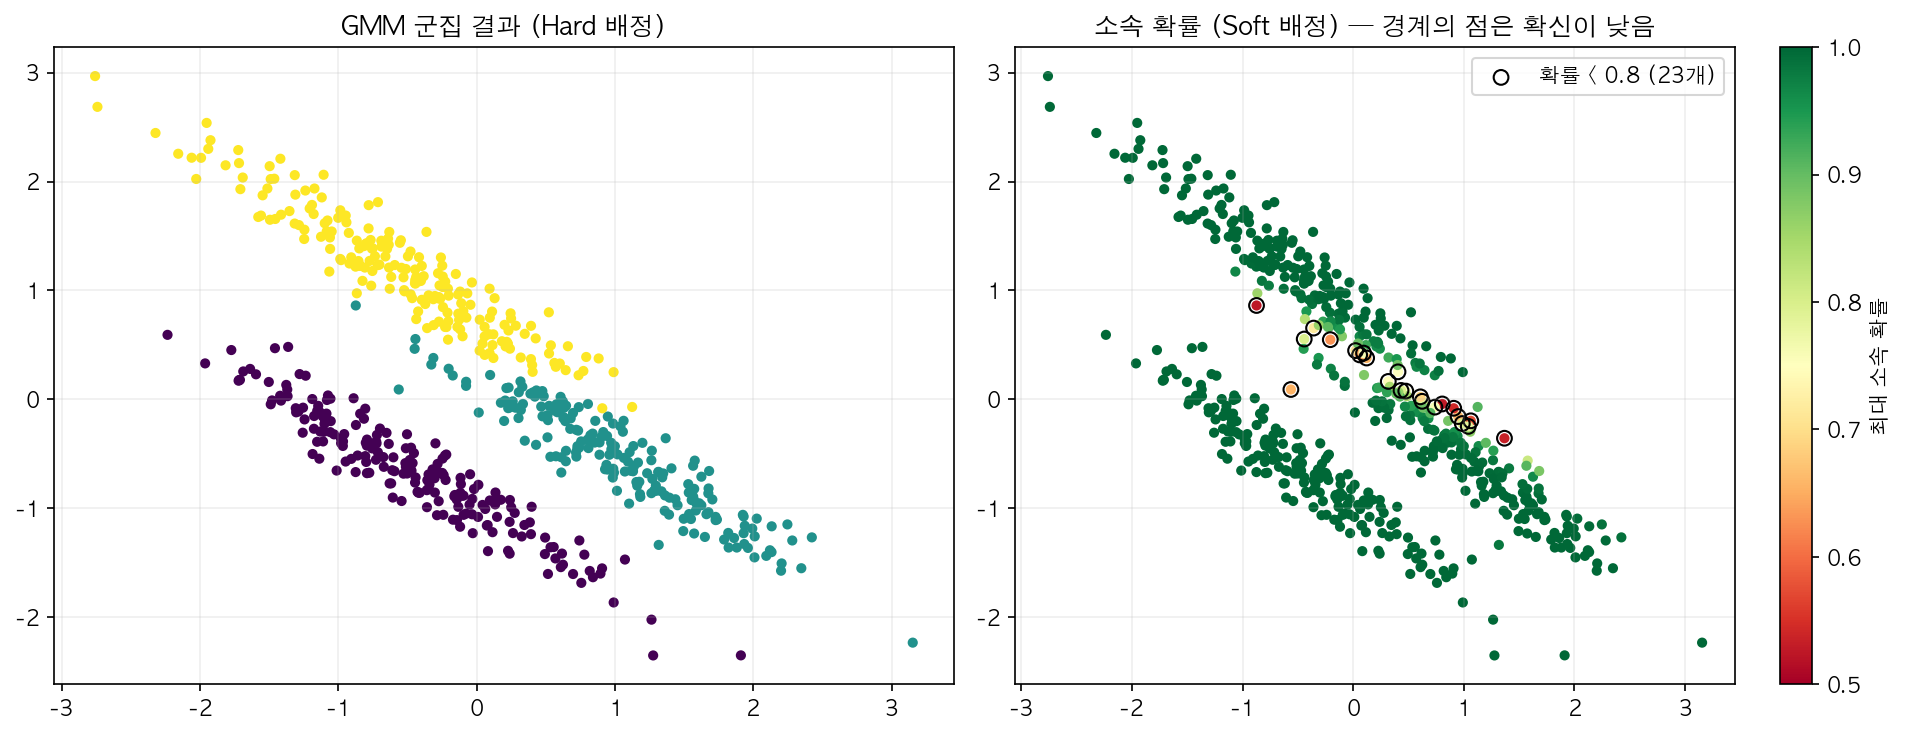
읽는 법:
왼쪽 — 각 점을 확률이 가장 높은 군집에 배정한 결과로, 비스듬한 세 타원을 거의 정확히 찾았습니다(ARI 0.94, K-Means는 0.41).
오른쪽 — 색이 초록일수록 한 군집에 확실히 속하고, 빨간색에 가까울수록 두 군집 사이에서 애매한 점입니다. 검은 원은 최대 소속 확률이 0.8 미만인 점입니다.
확률이 0.8 미만인 23개는 위쪽 두 타원이 맞닿은 경계에만 모여 있습니다. K-Means라면 이 점들도 아무 구분 없이 하나의 군집으로 배정했겠지만, GMM은 “판단이 어려운 점”을 따로 골라낼 수 있습니다.
9-6. 밀도 추정과 이상치 탐지
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| log_density = gmm.score_samples(X_scaled) # 각 점의 log p(x)
threshold = np.percentile(log_density, 2) # 하위 2%를 이상치로
outlier = log_density < threshold
xx, yy = np.meshgrid(np.linspace(X_scaled[:, 0].min() - 0.5, X_scaled[:, 0].max() + 0.5, 300),
np.linspace(X_scaled[:, 1].min() - 0.5, X_scaled[:, 1].max() + 0.5, 300))
zz = gmm.score_samples(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)
plt.figure(figsize=(8, 6))
plt.contour(xx, yy, zz, levels=np.linspace(zz.max() - 8, zz.max(), 10), cmap='Blues')
plt.scatter(X_scaled[~outlier, 0], X_scaled[~outlier, 1], c='gray', s=10, alpha=0.6)
plt.scatter(X_scaled[outlier, 0], X_scaled[outlier, 1], c='red', s=40, marker='x', label='이상치 (하위 2%)')
plt.title('GMM 확률 밀도 등고선과 이상치')
plt.legend()
plt.tight_layout()
plt.show()
|
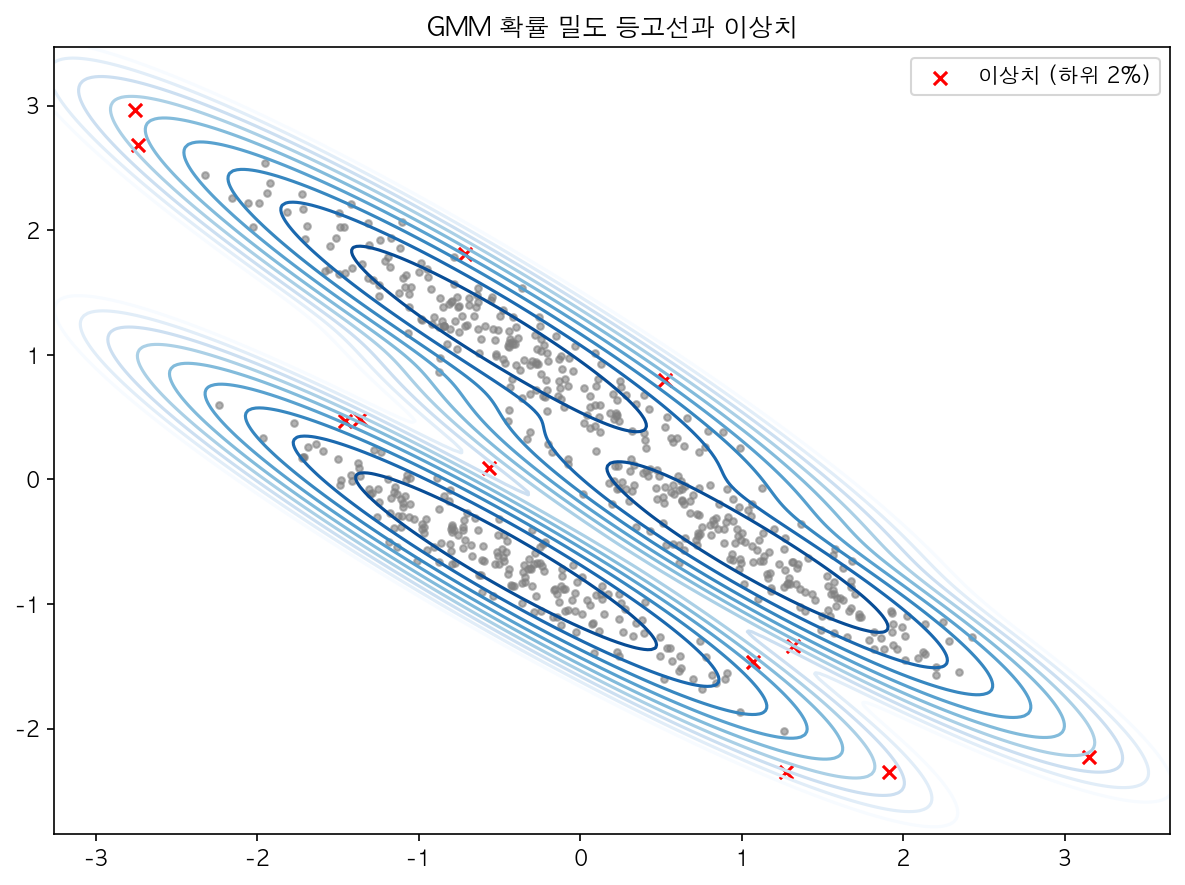
읽는 법:
파란 등고선은 GMM이 추정한 확률 밀도로, 안쪽일수록 데이터가 나올 확률이 높습니다.
빨간 X는 밀도가 하위 2%인 점들로, 타원의 바깥 가장자리나 군집 사이의 빈 공간에 있습니다.
GMM은 군집뿐 아니라 “이 데이터가 얼마나 흔한가”를 확률로 알려주기 때문에, 같은 모델로 이상치 탐지까지 할 수 있습니다.