1. 왜 등장했는가
Lasso는 불필요한 특성을 0으로 잘라내지만, 서로 비슷한 특성이 여러 개 있으면 그중 하나만 남기고 나머지를 버리는 문제가 있습니다.
Ridge는 상관된 특성을 고르게 다루지만 특성 선택을 하지 못합니다.
ElasticNet은 손실 함수에 L1(Lasso)과 L2(Ridge) 패널티를 함께 넣어 두 장점을 모두 취합니다. (Zou & Hastie, 2005)
Lasso가 “가위”, Ridge가 “다이어트”라면,
ElasticNet은 “필요 없는 건 자르고, 남은 건 고르게 줄이는” 정리 정돈에 가깝습니다.
2. 핵심 아이디어 — L1과 L2를 섞어 쓰기
ElasticNet은 본질적으로 Lasso의 특성 선택 + Ridge의 그룹 유지를 비율(l1_ratio)로 섞은 선형 모델입니다.
1
2
3
4
5
6
7
8
9
10
11
| 상관이 높은 특성 3개: 면적, 방 수, 화장실 수 (모두 "집 크기"를 나타냄)
무관한 특성 2개 : 건물 번호, 우편번호 끝자리
Lasso : 면적 = 2.1, 방 수 = 0.0, 화장실 = 0.0, 건물번호 = 0.0, 우편번호 = 0.0
→ 집 크기 그룹에서 하나만 선택 (어느 것이 남을지 데이터에 따라 불안정)
Ridge : 면적 = 0.8, 방 수 = 0.7, 화장실 = 0.6, 건물번호 = 0.1, 우편번호 = 0.1
→ 무관한 특성도 0이 되지 않음
ElasticNet : 면적 = 0.9, 방 수 = 0.7, 화장실 = 0.5, 건물번호 = 0.0, 우편번호 = 0.0
→ 집 크기 그룹은 함께 유지 + 무관한 특성은 제거 ✅
|
읽는 법:
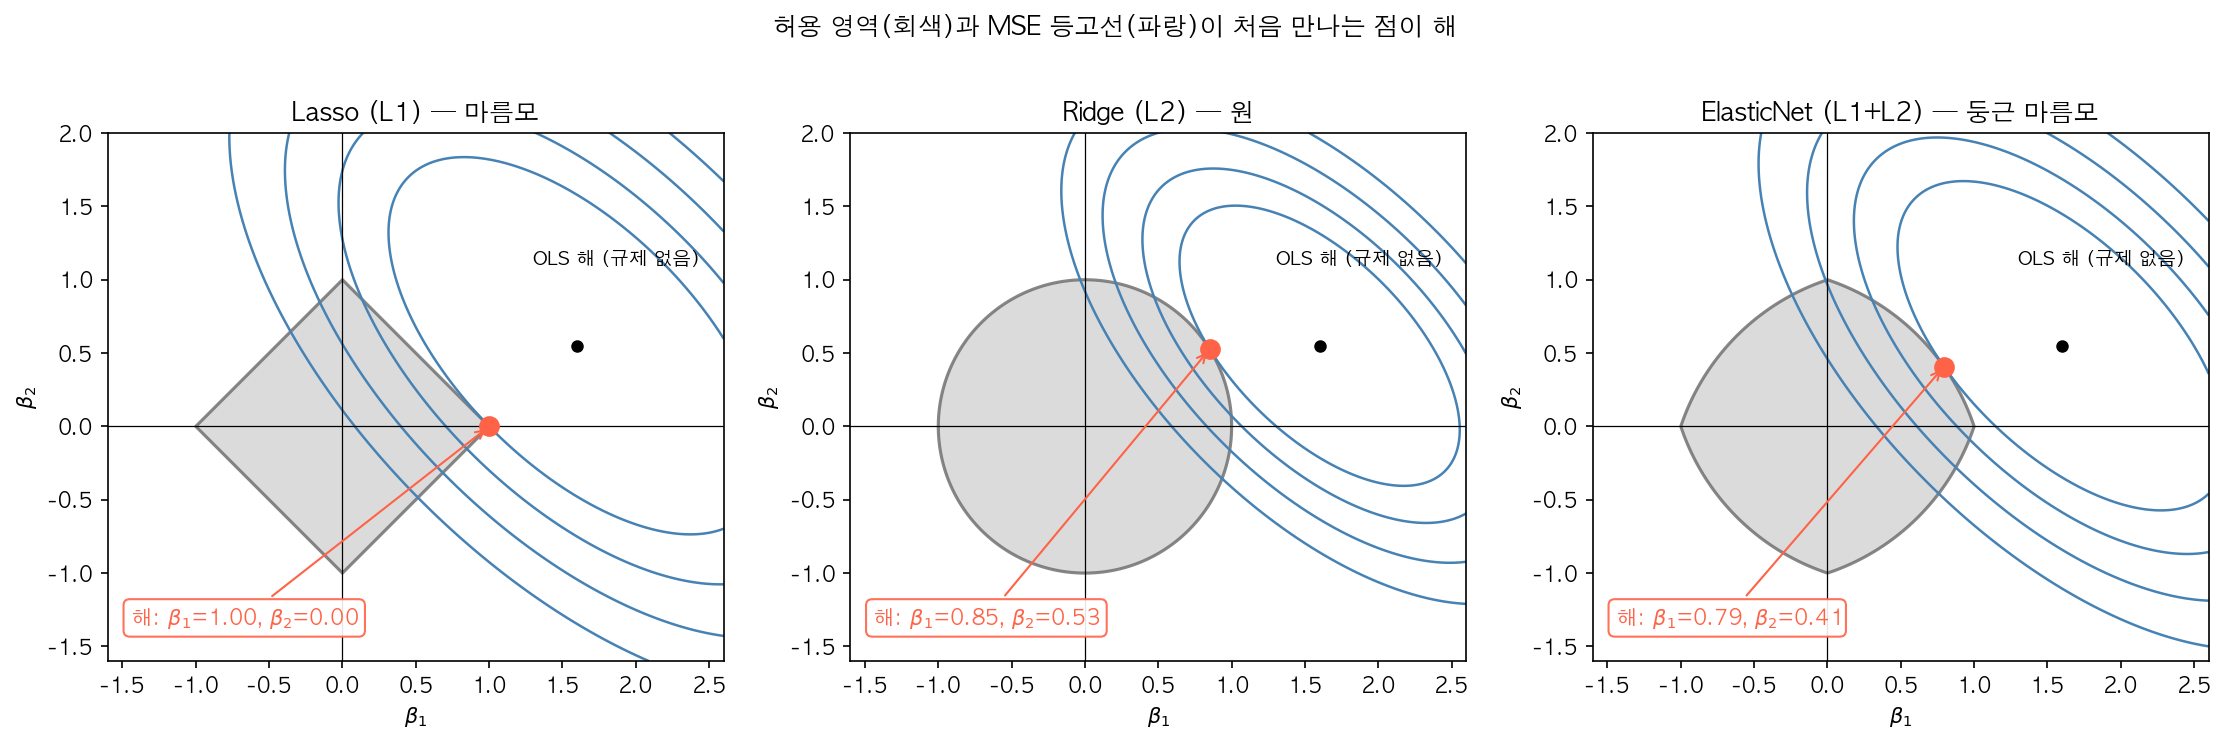
세 그림은 계수 두 개(β₁, β₂)가 움직일 수 있는 허용 영역(제약 영역) 을 나타냅니다. 타원은 MSE 등고선이며, 등고선이 허용 영역에 처음 닿는 점(빨간 점)이 해가 됩니다.
왼쪽 (Lasso, 마름모) — 꼭짓점이 축 위에 있어 해가 꼭짓점에 걸리기 쉽고, 그러면 한 계수가 정확히 0이 됩니다.
가운데 (Ridge, 원) — 모서리가 없어 두 계수가 모두 0이 아닌 값으로 남습니다.
오른쪽 (ElasticNet) — 마름모와 원의 중간 모양입니다. 꼭짓점이 있어 0을 만들 수 있으면서도 변이 둥글게 부풀어 있어 상관된 특성을 함께 남길 수 있습니다.
3. 실제 예시로 보기 (회귀)
예시 1 — 유전자 데이터로 질병 위험도 예측 (회귀)
1
2
3
4
5
6
7
8
9
10
11
| 특성: 유전자 발현량 20,000개 / 환자 200명 (p >> n)
같은 경로(pathway)에 속한 유전자들은 함께 움직임 (강한 상관)
Lasso:
→ 최대 n=200개까지만 특성 선택 가능 (수학적 한계)
→ 같은 경로의 유전자 중 1개만 무작위로 선택 → 해석 어려움
ElasticNet (l1_ratio=0.5):
→ 200개 넘게도 선택 가능
→ 같은 경로의 유전자들이 함께 선택됨 (Grouping Effect)
→ "이 경로 전체가 질병과 관련 있다"는 해석 가능
|
ElasticNet 논문이 처음 제시한 대표 사례이며, 지금도 유전체 분석에서 표준처럼 쓰입니다.
예시 2 — 마케팅 채널별 매출 기여도 (회귀)
1
2
3
4
5
6
| 특성: 네이버 검색광고, 구글 검색광고, 카카오 배너, 인스타 배너, 유튜브, 전단지 ...
검색광고끼리, 배너끼리 집행 시기가 겹쳐 상관이 높음
Lasso : 네이버 검색광고만 남고 구글 검색광고 = 0 → "구글 광고는 효과 없음"으로 오해
ElasticNet: 두 검색광고 모두 비슷한 계수로 유지 → "검색광고 그룹이 효과 있음"
전단지 = 0 → 실제로 효과 없는 채널은 제거
|
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| ┌────────────────────────────────────────┐
│ 선형 모델 ŷ = β₀ + Σ βⱼxⱼ │
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 손실 = MSE + 패널티 │
└──────────────────┬─────────────────────┘
│
┌─────────┴──────────┐
▼ ▼
[L1 패널티 × ρ] [L2 패널티 × (1-ρ)]
계수를 정확히 0으로 상관 특성 그룹 유지
(특성 선택) (계수 안정화)
└─────────┬──────────┘
▼
┌────────────────────────────────────────┐
│ 좌표 하강법(Coordinate Descent)으로 최적화 │
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 일부 계수 = 0, 나머지는 축소된 값 │
└────────────────────────────────────────┘
|
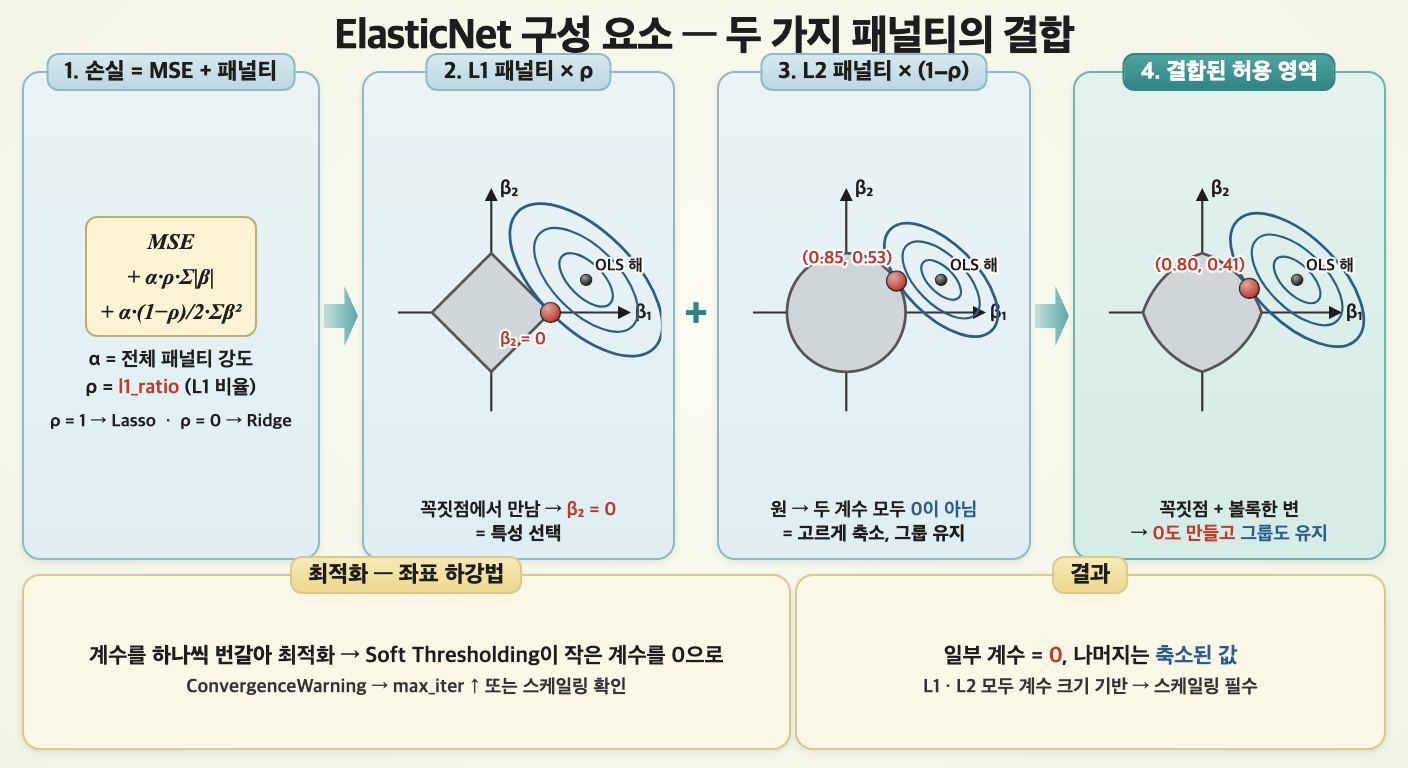
읽는 법:
가로·세로축은 계수 β₁, β₂, 회색 영역은 패널티가 허용하는 범위, 파란 타원은 MSE 등고선입니다. 등고선이 회색 영역에 처음 닿는 빨간 점이 해입니다.
1 — 손실은 MSE에 L1(ρ 비율)과 L2(1−ρ 비율) 패널티를 더한 것입니다.
2 (L1) — 마름모의 꼭짓점에서 만나 β₂ = 0이 됩니다. 이것이 특성 선택입니다.
3 (L2) — 원에서 만나 두 계수가 모두 0이 아닌 값으로 남습니다.
4 (ElasticNet) — 둘을 섞으면 꼭짓점은 남아 있으면서 변이 볼록해집니다. 그래서 계수를 0으로 만들 수도 있고, 상관된 특성을 함께 남길 수도 있습니다.
아래 칸은 실제 계산 방법(좌표 하강법)과 결과입니다.
| 구성 요소 | 설명 | 비유 |
|---|
| alpha (α) | 전체 패널티 강도 | 세금의 총액 |
| l1_ratio (ρ) | 패널티 중 L1이 차지하는 비율 | 세금 중 “퇴출세”의 비중 |
| L1 부분 | Σ|βⱼ| → 계수를 0으로 | 쓸모없는 직원 해고 |
| L2 부분 | Σβⱼ² → 계수를 고르게 축소 | 팀 전체 연봉을 조금씩 삭감 |
5. 어떻게 계수가 결정되는가
5-1. 목적 함수
\[\min_{\beta} \; \frac{1}{2n}\|y - X\beta\|_2^2 + \alpha\rho\|\beta\|_1 + \frac{\alpha(1-\rho)}{2}\|\beta\|_2^2\]
1
2
3
4
5
6
7
8
9
| α (alpha) : 패널티 전체 크기 → 클수록 계수가 더 많이 줄어듦
ρ (l1_ratio) : L1과 L2의 혼합 비율
ρ = 1.0 → 순수 Lasso
ρ = 0.0 → 순수 Ridge
ρ = 0.5 → L1과 L2를 반반
※ sklearn의 alpha·l1_ratio 정의는 위 식을 따름
(R의 glmnet에서는 alpha가 l1_ratio, lambda가 alpha 역할 → 이름 혼동 주의)
|
5-2. Grouping Effect (그룹 효과)
\[\text{특성 } x_i, x_j \text{의 상관계수 } r \to 1 \;\Rightarrow\; |\hat\beta_i - \hat\beta_j| \to 0\]
1
2
3
4
5
| L2 패널티가 섞여 있으면 거의 같은 특성 두 개의 계수가 비슷한 값으로 수렴
예: 면적(㎡)과 면적(평)이 둘 다 들어 있을 때
Lasso : 하나는 2.0, 하나는 0.0 (어느 쪽이 남을지 불안정)
ElasticNet: 둘 다 1.0 근처 (안정적으로 나눠 가짐)
|
5-3. 좌표 하강법 (Coordinate Descent)
1
2
3
4
5
6
7
8
9
| L1 패널티(|β|)는 0에서 미분이 불가능 → 정규방정식으로 한 번에 풀 수 없음
좌표 하강법:
1. 나머지 계수를 고정하고 β₁ 하나만 최적화 (이건 공식으로 바로 풀림)
2. β₂, β₃, ... 순서대로 반복
3. 변화가 tol보다 작아질 때까지 전체를 반복
→ 각 단계에서 "Soft Thresholding" 연산이 작은 계수를 정확히 0으로 만듦
→ 수렴 경고(ConvergenceWarning)가 뜨면 max_iter를 늘리거나 스케일링 확인
|
6. ElasticNet 장・단점
6-1. ✅ ElasticNet 장점
1
2
3
4
5
6
7
8
9
10
11
| 1. 특성 선택 + 안정성
→ Lasso처럼 불필요한 특성을 0으로, Ridge처럼 계수를 안정적으로
2. 상관 특성 그룹을 함께 유지
→ Grouping Effect로 해석이 자연스러움
3. p > n 에서도 동작
→ Lasso는 최대 n개까지만 선택하지만 ElasticNet은 제한 없음
4. Lasso와 Ridge를 모두 포함
→ l1_ratio 하나로 두 모델 사이를 연속적으로 탐색 가능
|
6-2. ❌ ElasticNet이 약한 상황
1
2
3
4
5
6
7
8
| 1. 튜닝할 파라미터가 2개
→ alpha × l1_ratio 조합 탐색 → Ridge/Lasso보다 학습 시간 증가
2. 비선형 관계
→ 여전히 선형 모델 → 트리 기반 모델 고려
3. 상관이 거의 없는 데이터
→ Lasso 대비 이점이 거의 없음 (계수만 조금 더 축소됨)
|
6-2-1. 두 파라미터 동시 튜닝 문제
ElasticNet의 가장 큰 약점입니다.
1
2
3
4
| alpha 후보 100개 × l1_ratio 후보 6개 × CV 5-fold = 3,000번 학습
다만 좌표 하강법은 alpha를 큰 값 → 작은 값 순서로 풀 때
직전 해를 시작점으로 재사용(warm start)할 수 있어 실제로는 빠름
|
해결책 :
1
2
3
4
5
6
7
8
9
10
| from sklearn.linear_model import ElasticNetCV
# ElasticNetCV: l1_ratio 후보마다 alpha 경로 전체를 한 번에 계산
en_cv = ElasticNetCV(
l1_ratio = [0.1, 0.5, 0.7, 0.9, 0.95, 0.99, 1.0], # 1에 가까운 값을 촘촘히 (공식 문서 권장)
n_alphas = 100, # alpha 후보는 자동 생성
cv = 5,
n_jobs = -1,
random_state = 0
)
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 지도학습 / 회귀 |
| 핵심 아이디어 | MSE + L1 + L2 패널티 → 특성 선택과 계수 안정화를 동시에 |
| 특성 선택 | ✅ 자동 특성 선택 (상관 특성은 그룹으로) |
| 스케일링 필요? | ✅ 필수 |
| 핵심 파라미터 | alpha, l1_ratio |
| 실전 사용 | 고차원·상관 특성이 많은 데이터 (유전체, 텍스트, 마케팅 믹스) |
8. 다른 알고리즘과 무엇이 다른가
Ridge vs Lasso vs ElasticNet
1
2
3
4
5
6
7
8
| 손실 함수 비교:
Ridge: MSE + α×Σβⱼ² (L2만)
Lasso: MSE + α×Σ|βⱼ| (L1만)
ElasticNet: MSE + α×(ρ×Σ|βⱼ| + (1-ρ)/2×Σβⱼ²) (L1 + L2)
→ ElasticNet(l1_ratio=1) = Lasso
→ ElasticNet(l1_ratio=0) ≈ Ridge
|
| 항목 | Ridge | Lasso | ElasticNet |
|---|
| 계수 = 0 | ❌ | ✅ | ✅ |
| 상관 특성 | ✅ 그룹 유지 | ⚠️ 하나만 선택 | ✅ 그룹 유지 |
| p > n | ✅ | ⚠️ 최대 n개 선택 | ✅ |
| 파라미터 | alpha | alpha | alpha, l1_ratio |
| 최적화 | 정규방정식 | 좌표 하강법 | 좌표 하강법 |
9. 코드로 보기 — 집값 예측 (회귀)
1
2
3
4
5
6
7
| from sklearn.linear_model import ElasticNet, ElasticNetCV
en = ElasticNet(
alpha = 0.01, # 전체 패널티 강도
l1_ratio = 0.5, # L1 비율 (0=Ridge, 1=Lasso)
max_iter = 10000
)
|
| Parameter | Default | 역할 | 과적합 방향 |
|---|
alpha | 1.0 | 전체 정규화 강도 | 작을수록 과적합 ↑ |
l1_ratio | 0.5 | L1 패널티 비율 | - |
max_iter | 1000 | 좌표 하강법 최대 반복 | - |
tol | 1e-4 | 수렴 판정 기준 | - |
selection | 'cyclic' | 계수 업데이트 순서 | - |
alpha : 가장 중요한 파라미터- 클수록 → 더 많은 계수가 0 → 단순한 모델
- 작을수록 → 일반 선형 회귀에 가까워짐
- 기본값 1.0은 대부분 너무 큼 →
ElasticNetCV로 탐색 권장
l1_ratio : L1과 L2의 혼합 비율- 1에 가까울수록 → Lasso처럼 희소(sparse)한 모델
- 0에 가까울수록 → Ridge처럼 모든 계수 유지
- 0.5 ~ 1.0 사이를 촘촘히 탐색하는 것이 일반적
selection : 계수 업데이트 순서'cyclic' : 순서대로 (기본값)'random' : 무작위 순서 → 특성이 많을 때 더 빠르게 수렴하기도 함
9-1. 전처리
California Housing은 특성이 8개뿐이라 규제 효과를 보기 어렵습니다.
2차 다항 특성(x², x₁x₂ …)을 만들어 서로 강하게 상관된 특성 44개로 늘린 뒤 비교합니다.
이때 AveOccup처럼 극단값이 있는 특성을 그대로 제곱하면 테스트 R²가 음수로 떨어질 만큼 예측이 망가지므로, 먼저 로그 변환을 합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
| import numpy as np
import pandas as pd
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
data = fetch_california_housing()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target
# 오른쪽으로 크게 치우친 특성은 로그 변환 (다항 특성에서 이상치가 폭발하는 것 방지)
skewed = ['AveRooms', 'AveBedrms', 'Population', 'AveOccup']
X[skewed] = np.log1p(X[skewed])
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=0)
# 2차 다항 특성 → 8개 → 44개 (상관이 높은 특성이 대량 생성됨)
poly = PolynomialFeatures(degree=2, include_bias=False)
X_train = poly.fit_transform(X_train)
X_test = poly.transform(X_test)
feature_names = poly.get_feature_names_out(data.feature_names)
# ✅ L1·L2 패널티 모두 계수 크기 기반 → 스케일링 필수
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)
print(f"특성 수 : {X_train.shape[1]}")
|
Note: ElasticNet도 Ridge·Lasso와 마찬가지로 StandardScaler가 반드시 필요합니다.
스케일이 다르면 단위가 작은 특성이 부당하게 큰 패널티를 받아 먼저 0이 됩니다.
9-2. 모델 학습
1
2
3
4
| en = ElasticNet(alpha=0.01, l1_ratio=0.5, max_iter=10000)
en.fit(X_train, y_train)
print(f"0이 아닌 계수 : {np.sum(en.coef_ != 0)} / {len(en.coef_)}")
|
9-2-1. 교차 검증으로 최적 α, l1_ratio 탐색
1
2
3
4
5
6
7
8
9
10
11
12
| en_cv = ElasticNetCV(
l1_ratio = [0.1, 0.5, 0.7, 0.9, 0.95, 0.99, 1.0],
n_alphas = 100,
cv = 5,
max_iter = 10000,
n_jobs = -1
)
en_cv.fit(X_train, y_train)
print(f"Best alpha : {en_cv.alpha_:.5f}")
print(f"Best l1_ratio : {en_cv.l1_ratio_}")
print(f"0이 아닌 계수 : {np.sum(en_cv.coef_ != 0)} / {len(en_cv.coef_)}")
|
9-3. 평가 — Linear / Ridge / Lasso / ElasticNet 비교
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| from sklearn.linear_model import LinearRegression, RidgeCV, LassoCV
from sklearn.metrics import mean_squared_error, r2_score
models = {
'Linear' : LinearRegression(),
'Ridge' : RidgeCV(alphas=np.logspace(-3, 3, 50)),
'Lasso' : LassoCV(cv=5, max_iter=10000, n_jobs=-1),
'ElasticNet': en_cv,
}
for name, model in models.items():
if name != 'ElasticNet':
model.fit(X_train, y_train)
pred = model.predict(X_test)
nonzero = np.sum(np.abs(model.coef_) > 1e-10)
print(f"{name:>10} | R² : {r2_score(y_test, pred):.4f} | "
f"RMSE : {np.sqrt(mean_squared_error(y_test, pred)):.4f} | 사용 특성 : {nonzero:>2}개")
|
1
2
3
4
| Linear | R² : 0.7205 | RMSE : 0.6078 | 사용 특성 : 44개
Ridge | R² : 0.7205 | RMSE : 0.6079 | 사용 특성 : 44개
Lasso | R² : 0.6909 | RMSE : 0.6392 | 사용 특성 : 26개
ElasticNet | R² : 0.6909 | RMSE : 0.6392 | 사용 특성 : 26개
|
결과 해석:
이 데이터에서는 ElasticNetCV가 l1_ratio = 1.0, 즉 순수 Lasso를 최적으로 골랐습니다. ElasticNet은 Lasso와 Ridge를 모두 포함하므로, 교차 검증이 데이터에 맞는 쪽을 스스로 선택한 것입니다.
또 훈련 데이터가 15,480개로 특성 수(44개)보다 훨씬 많아 과적합 위험이 작기 때문에, 규제가 없는 Linear가 R²는 가장 높습니다.
대신 Lasso·ElasticNet은 R²를 약 0.03 양보하고 사용 특성을 44개 → 26개로 줄였습니다. 규제의 진짜 이득은 데이터가 적거나 특성이 데이터보다 많을 때(p > n) 커집니다.
9-4. l1_ratio에 따른 희소성 변화
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
| import matplotlib.pyplot as plt
ratios = [0.01, 0.1, 0.3, 0.5, 0.7, 0.9, 1.0]
n_nonzero, r2s = [], []
for r in ratios:
m = ElasticNet(alpha=0.01, l1_ratio=r, max_iter=10000).fit(X_train, y_train)
n_nonzero.append(np.sum(m.coef_ != 0))
r2s.append(r2_score(y_test, m.predict(X_test)))
fig, ax1 = plt.subplots(figsize=(8, 4.5))
ax1.plot(ratios, n_nonzero, 'o-', color='steelblue', lw=2, label='0이 아닌 계수 수')
ax1.set_xlabel('l1_ratio (0 = Ridge → 1 = Lasso)')
ax1.set_ylabel('0이 아닌 계수 수', color='steelblue')
ax2 = ax1.twinx()
ax2.plot(ratios, r2s, 's--', color='tomato', lw=2, label='Test R²')
ax2.set_ylabel('Test R²', color='tomato')
plt.title('ElasticNet (alpha=0.01) — l1_ratio가 커질수록 더 많은 계수가 0')
ax1.grid(True, alpha=0.3)
fig.tight_layout()
plt.show()
|
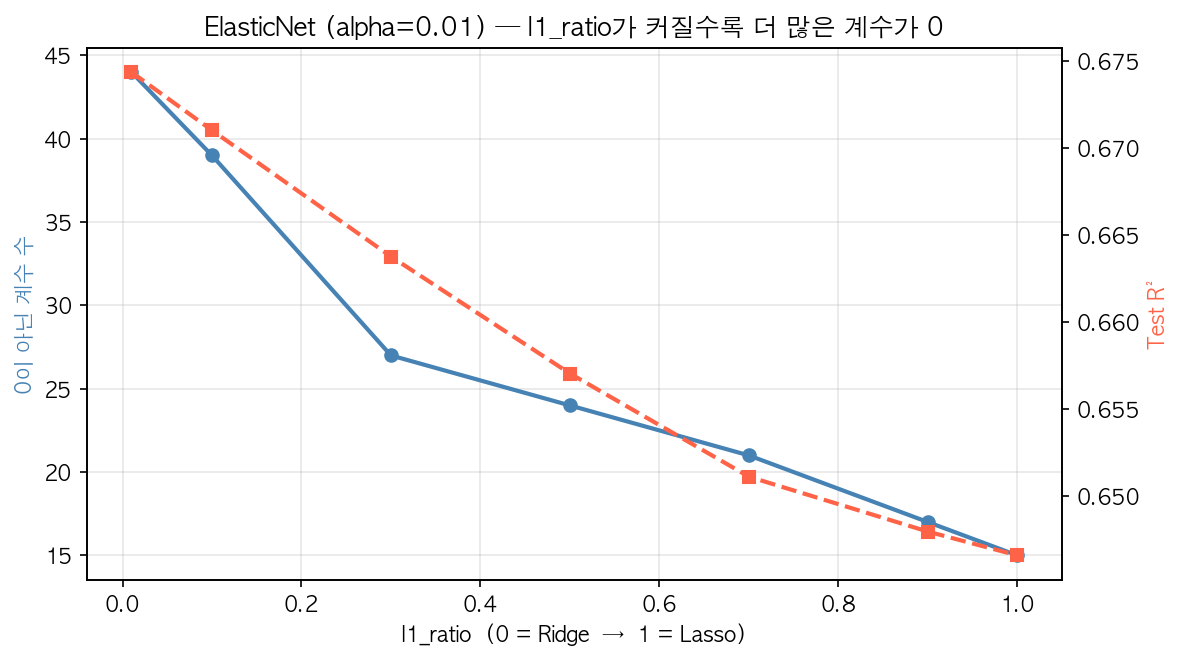
읽는 법:
파란 실선(왼쪽 축)은 0이 아닌 계수의 개수, 빨간 점선(오른쪽 축)은 테스트 R²입니다.
l1_ratio가 0(Ridge 쪽)에 가까우면 44개 특성을 거의 모두 쓰고, 1(Lasso 쪽)로 갈수록 사용하는 특성이 줄어듭니다.
성능(R²)이 크게 떨어지지 않는 범위에서 특성 수를 줄일 수 있는 지점을 고르는 것이 l1_ratio 튜닝의 목표입니다.
9-5. α에 따른 계수 변화 (정규화 경로)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
| from sklearn.linear_model import enet_path, lasso_path
alphas_en, coefs_en, _ = enet_path(X_train, y_train, l1_ratio=0.5, n_alphas=100)
alphas_la, coefs_la, _ = lasso_path(X_train, y_train, n_alphas=100)
fig, axes = plt.subplots(1, 2, figsize=(13, 4.5), sharey=True)
for ax, alphas, coefs, title in [
(axes[0], alphas_la, coefs_la, 'Lasso (l1_ratio=1.0)'),
(axes[1], alphas_en, coefs_en, 'ElasticNet (l1_ratio=0.5)'),
]:
for c in coefs:
ax.semilogx(alphas, c, lw=1)
ax.set_xlabel('alpha')
ax.set_title(title)
ax.grid(True, alpha=0.3)
axes[0].set_ylabel('Coefficient')
axes[0].set_ylim(-1, 1)
plt.suptitle('정규화 경로 비교 — 44개 다항 특성', fontweight='bold')
plt.tight_layout()
plt.show()
|
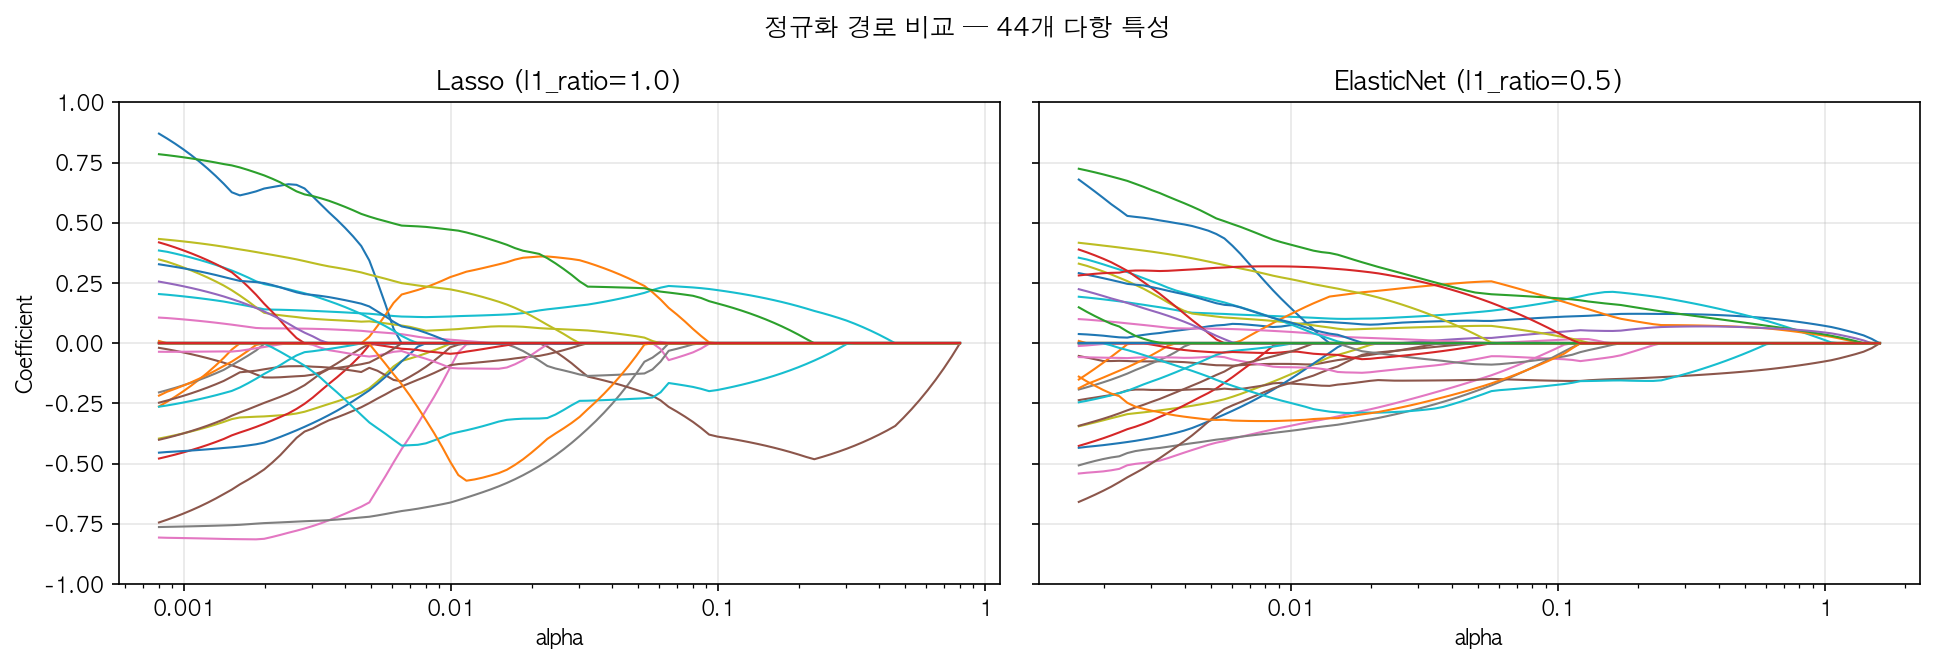
읽는 법:
x축(로그 스케일)은 α, 각 선은 특성 하나의 계수입니다. 오른쪽(α 큼)에서 왼쪽(α 작음)으로 읽으면 특성이 하나씩 모델에 들어옵니다.
왼쪽 (Lasso) — 상관된 특성들이 서로 경쟁해 한 계수가 커지면 다른 계수가 꺾여 들어가는 등 경로가 들쭉날쭉합니다.
오른쪽 (ElasticNet) — L2 성분 덕분에 경로가 더 부드럽고, 비슷한 특성들이 함께 들어와 함께 커집니다(Grouping Effect).