1. 왜 등장했는가
지금까지의 모델(KNN, Random Forest, SVM …)은 모두 정답(레이블)이 있는 데이터로 학습하는 지도학습이었습니다.
하지만 실무 데이터의 대부분은 정답이 없습니다. “우리 고객은 어떤 유형으로 나뉘는가?”처럼 데이터 스스로 비슷한 것끼리 묶는 방법이 필요합니다.
K-Means는 데이터를 K개의 그룹(군집) 으로 나누는 가장 대표적인 비지도학습 군집 알고리즘입니다. (Lloyd, 1957 / MacQueen, 1967)
KNN이 “가까운 이웃의 정답을 보고 따라가는” 모델이라면,
K-Means는 “정답 없이 가까운 것끼리 모아 K개의 동네를 만드는” 모델입니다.
2. 핵심 아이디어 — “중심을 옮기고, 다시 배정하고”
K-Means는 본질적으로 “각 점을 가장 가까운 중심에 배정 → 중심을 배정된 점들의 평균으로 이동”을 반복하는 알고리즘입니다.
1
2
3
4
5
6
7
8
| K = 3, 고객 데이터 (연간 구매액, 방문 횟수)
1. 초기화 : 중심 3개를 임의로 놓음 ★ ★ ★
2. 배정 : 모든 고객을 가장 가까운 중심에 배정 ● → ★₁, ● → ★₂ ...
3. 업데이트 : 각 중심을 배정된 고객들의 평균 위치로 이동 ★ 이동
4. 반복 : 2~3을 중심이 더 이상 움직이지 않을 때까지
결과: VIP 고객 / 일반 고객 / 휴면 고객 3개 그룹
|
읽는 법:
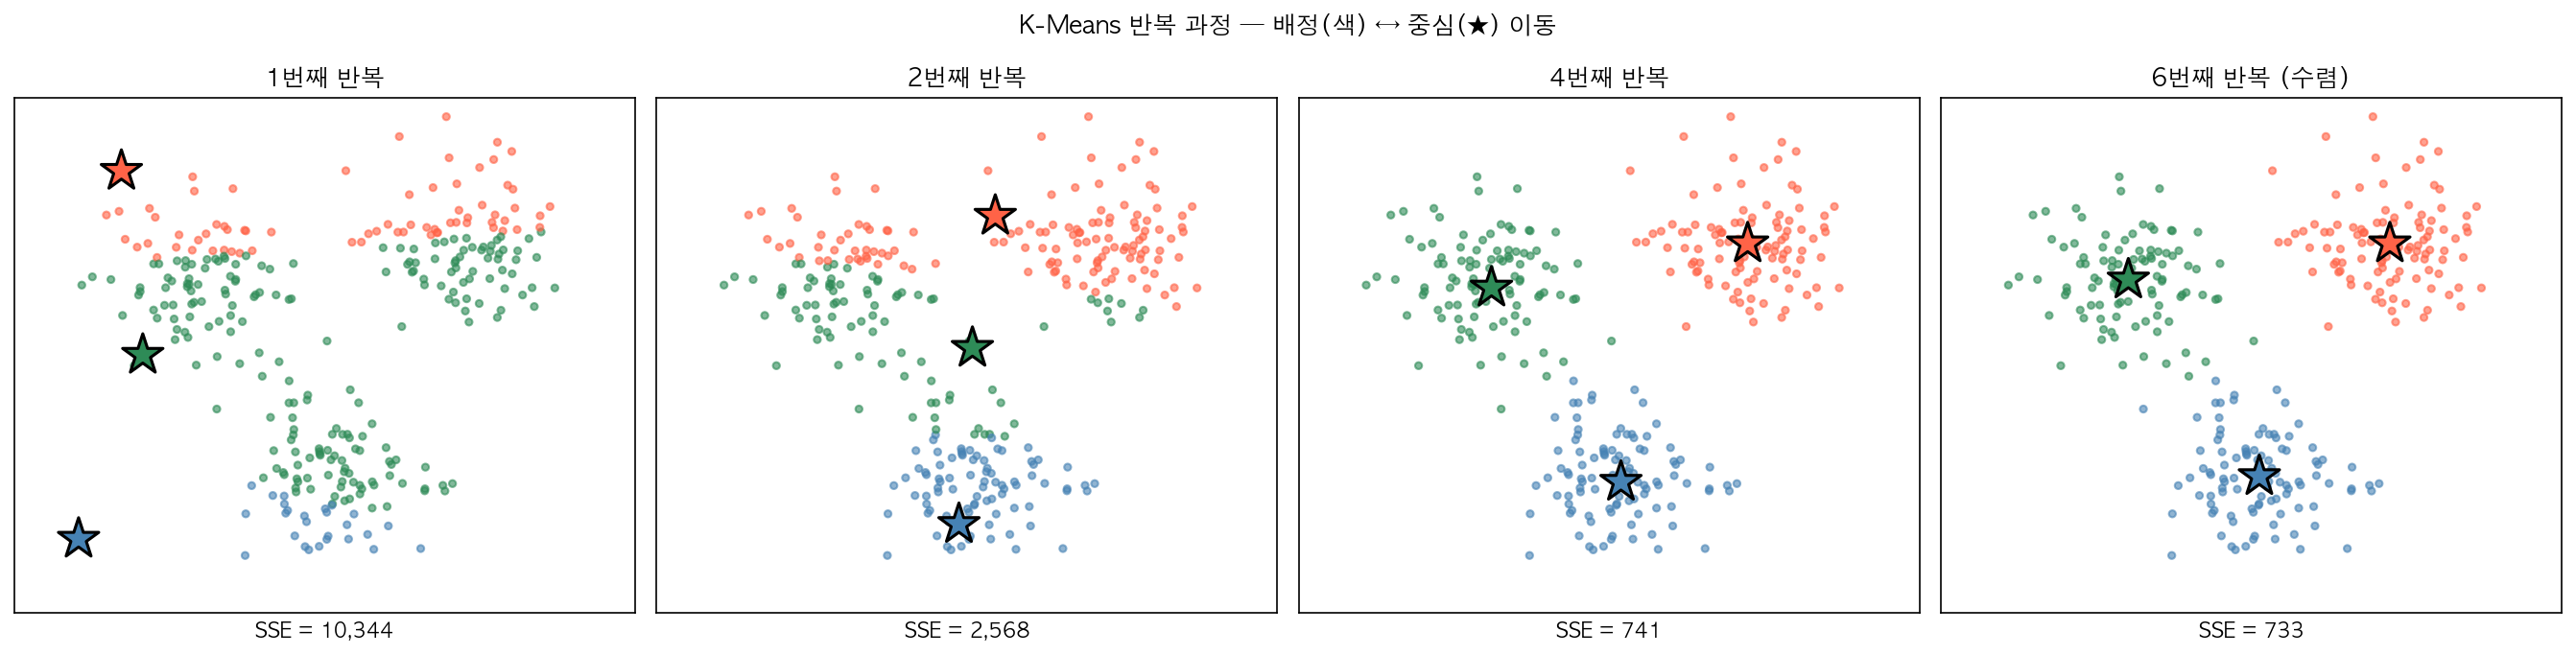
왼쪽부터 오른쪽으로, K-Means가 반복할수록 군집이 어떻게 바뀌는지 보여줍니다. 점의 색은 현재 배정된 군집, ★는 군집 중심입니다.
1번째 반복 — 중심이 엉뚱한 곳에서 시작해 군집 경계가 실제 그룹과 맞지 않습니다.
반복이 진행될수록 중심(★)이 각 그룹의 한가운데로 이동하고, 그에 따라 점들의 배정도 바로잡힙니다.
마지막 그림 — 중심이 더 이상 움직이지 않으면(수렴) 학습이 끝납니다. 아래쪽 숫자 SSE(군집 내 거리 제곱합)는 반복할수록 줄어듭니다.
3. 실제 예시로 보기 (군집)
예시 1 — 고객 세분화 (군집)
1
2
3
4
5
6
7
8
9
10
11
12
13
| 특성: 최근 구매일(Recency), 구매 빈도(Frequency), 구매 금액(Monetary) ← RFM 분석
K-Means (K = 4) 결과:
┌──────────┬──────────┬────────┬──────────┬───────────────────────┐
│ 군집 │ Recency │ 빈도 │ 금액 │ 해석 │
├──────────┼──────────┼────────┼──────────┼───────────────────────┤
│ 0 │ 5일 │ 30회 │ 300만원 │ VIP → 전용 혜택 │
│ 1 │ 20일 │ 10회 │ 50만원 │ 충성 고객 → 등급 상향 │
│ 2 │ 90일 │ 3회 │ 10만원 │ 이탈 위험 → 쿠폰 발송 │
│ 3 │ 300일 │ 1회 │ 3만원 │ 휴면 고객 → 재활성화 │
└──────────┴──────────┴────────┴──────────┴───────────────────────┘
→ 군집 번호 자체에는 의미가 없음. 각 군집의 평균값을 보고 사람이 해석해야 함
|
예시 2 — 이미지 색상 압축 (군집)
1
2
3
4
5
6
| 사진 한 장 = 픽셀 100만 개, 각 픽셀은 (R, G, B) 3차원 점
K-Means (K = 16):
100만 개 픽셀을 색이 비슷한 16개 군집으로 묶음
→ 각 픽셀을 소속 군집의 중심 색으로 바꿈
→ 1,600만 색 → 16색으로 표현 (용량 대폭 감소, 눈으로 보기엔 비슷)
|
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| ┌────────────────────────────────────────┐
│ K 결정 (사람이 지정) │ ← Elbow, Silhouette로 탐색
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 중심 K개 초기화 (k-means++) │ ← 서로 멀리 떨어지게 배치
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 배정: 각 점 → 가장 가까운 중심 │ ← 유클리드 거리
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 업데이트: 중심 = 소속 점들의 평균 │
└──────────────────┬─────────────────────┘
│
중심이 움직였나? ── Yes ──→ 배정 단계로
│ No
▼
┌────────────────────────────────────────┐
│ n_init번 반복 → SSE가 가장 작은 결과 선택 │
└────────────────────────────────────────┘
|
읽는 법:
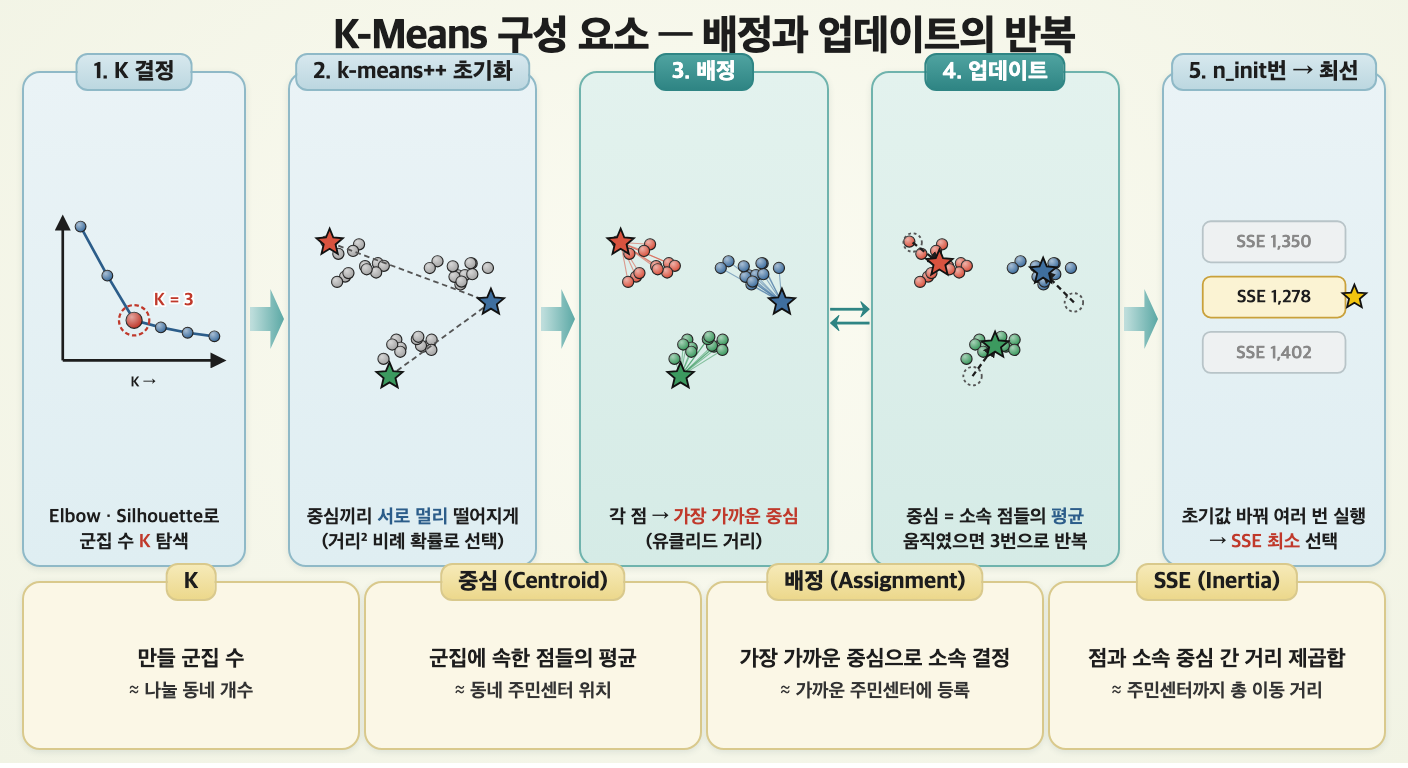
K-Means의 전체 흐름을 왼쪽부터 순서대로 그린 그림입니다. 가운데 3·4번(청록색)이 반복되는 핵심 루프입니다.
1 — Elbow(또는 Silhouette)로 군집 수 K를 정합니다.
2 — k-means++로 서로 멀리 떨어진 점들을 초기 중심(★)으로 고릅니다.
3 — 각 점을 가장 가까운 중심에 배정합니다. 가는 선이 배정 관계입니다.
4 — 각 중심을 소속 점들의 평균 위치로 옮깁니다(점선 화살표). 중심이 움직였다면 3번으로 돌아갑니다.
5 — 초기값을 바꿔 n_init번 실행한 뒤 SSE가 가장 작은 결과를 고릅니다.
아래 네 칸은 K·중심·배정·SSE를 동네와 주민센터에 비유해 정리한 것입니다.
| 구성 요소 | 설명 | 비유 |
|---|
| K | 만들 군집 수 | 나눌 동네 개수 |
| 중심 (Centroid) | 군집에 속한 점들의 평균 위치 | 동네 주민센터 위치 |
| 배정 (Assignment) | 가장 가까운 중심으로 소속 결정 | 가장 가까운 주민센터에 등록 |
| SSE (Inertia) | 각 점과 소속 중심 간 거리 제곱합 | 주민들이 주민센터까지 가는 총 거리 |
5. 어떻게 군집을 찾는가
5-1. 목적 함수 (SSE, Inertia)
\[\text{SSE} = \sum_{k=1}^{K}\sum_{x_i \in C_k}\|x_i - \mu_k\|^2\]
1
2
3
4
5
6
7
8
| μₖ : k번째 군집의 중심 (소속 점들의 평균)
배정 단계 : μ를 고정하고 각 점을 가장 가까운 중심에 → SSE 감소
업데이트 단계: 배정을 고정하고 μ를 평균으로 → SSE 감소 (평균이 거리 제곱합을 최소화)
→ 매 단계 SSE가 줄어들기만 하므로 반드시 수렴
→ 하지만 전역 최적해가 아닌 지역 최적해(Local Minimum)에 빠질 수 있음
→ 초기값을 바꿔 여러 번(n_init) 실행 후 SSE가 가장 작은 결과 선택
|
5-2. k-means++ 초기화
1
2
3
4
5
6
7
8
9
10
| 무작위 초기화의 문제: 중심 2개가 같은 그룹 안에 놓이면 → 잘못된 군집으로 수렴
k-means++ (Arthur & Vassilvitskii, 2007):
1. 첫 중심은 데이터 중 무작위로 1개 선택
2. 각 점에서 가장 가까운 기존 중심까지 거리 D(x) 계산
3. D(x)²에 비례하는 확률로 다음 중심 선택 → 멀리 있는 점일수록 뽑힐 확률 ↑
4. K개가 될 때까지 반복
→ 중심들이 처음부터 서로 멀리 퍼져 시작 → 더 빠르고 안정적인 수렴
→ sklearn 기본값 init='k-means++'
|
5-3. 최적의 K 찾기
1
2
3
4
5
6
7
8
9
10
| 1. Elbow Method
K를 늘리면 SSE는 항상 감소 (K = 데이터 수이면 SSE = 0)
→ SSE 감소 폭이 급격히 줄어드는 "팔꿈치" 지점의 K 선택
2. Silhouette Score
각 점 i에 대해:
a(i) = 같은 군집 내 다른 점들까지의 평균 거리 (응집도, 작을수록 좋음)
b(i) = 가장 가까운 다른 군집의 점들까지의 평균 거리 (분리도, 클수록 좋음)
s(i) = (b(i) - a(i)) / max(a(i), b(i)) → -1 ~ 1
→ 전체 평균 실루엣이 가장 큰 K 선택 (1에 가까울수록 잘 분리된 군집)
|
6. K-Means 장・단점
6-1. ✅ K-Means 장점
1
2
3
4
5
6
7
8
9
10
11
| 1. 단순하고 빠름
→ 계산량 O(n × K × 반복 수) → 수백만 건 데이터도 처리 가능 (MiniBatchKMeans)
2. 결과 해석이 쉬움
→ 각 군집의 중심 = 그 군집의 "대표 프로필"
3. 새 데이터 배정이 쉬움
→ predict()로 가장 가까운 중심에 바로 배정
4. 구현과 튜닝이 간단
→ 사실상 K 하나만 정하면 됨
|
6-2. ❌ K-Means가 약한 상황
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| 1. K를 미리 정해야 함
→ 데이터에 몇 개 그룹이 있는지 모르는 경우가 대부분
2. 구형(원형)이 아닌 군집
→ 초승달·고리 모양, 길쭉한 타원 → 경계를 직선으로 나눠 실패 → DBSCAN, GMM
3. 군집 크기·밀도가 크게 다를 때
→ 큰 군집을 쪼개고 작은 군집을 합쳐버림
4. 이상치에 민감
→ 평균을 쓰므로 이상치 하나가 중심을 크게 끌어당김 → K-Medoids 고려
5. 스케일에 민감
→ 유클리드 거리 기반 → 단위가 큰 특성이 군집을 지배
|
6-2-1. 구형이 아닌 군집 문제
K-Means의 가장 큰 약점입니다.
1
2
3
4
5
6
7
| 초승달 모양 두 개가 맞물린 데이터 (make_moons)
K-Means (K=2): 각 점을 "가장 가까운 중심"으로 배정
→ 군집 경계가 항상 두 중심의 수직이등분선 (직선)
→ 초승달 모양을 무시하고 데이터를 위·아래로 반씩 잘라버림
원인: K-Means는 모든 군집이 "중심 주변의 둥근 덩어리"라고 암묵적으로 가정
|
해결책 :
1
2
3
4
5
6
7
8
9
10
| from sklearn.cluster import DBSCAN, KMeans
from sklearn.mixture import GaussianMixture
# 방법 1: 밀도 기반 군집 → 임의 모양의 군집 탐지 (+ 이상치 자동 분리)
dbscan = DBSCAN(eps=0.2, min_samples=5)
# 방법 2: 타원형 군집 → 공분산까지 학습하는 GMM
gmm = GaussianMixture(n_components=3, covariance_type='full', random_state=0)
# 방법 3: 이상치 영향 줄이기 → 이상치 제거 후 K-Means, 또는 RobustScaler 사용
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 비지도학습 / 군집 |
| 핵심 아이디어 | 배정(가장 가까운 중심) ↔ 업데이트(평균으로 이동) 반복 → SSE 최소화 |
| 핵심 가정 | 군집이 구형이고 크기가 비슷함 |
| 스케일링 필요? | ✅ 필수 (유클리드 거리 기반) |
| 핵심 파라미터 | n_clusters(K), init, n_init |
| K 선택 | Elbow Method, Silhouette Score |
| 실전 사용 | 고객 세분화, 이미지 압축, 문서 군집, 다른 모델의 전처리(군집 특성) |
8. 다른 알고리즘과 무엇이 다른가
KNN vs K-Means
1
2
3
4
5
6
7
8
9
10
11
| 이름이 비슷하지만 완전히 다른 알고리즘
KNN: 지도학습 (분류/회귀)
K = 참고할 이웃 수
새 점 → 가장 가까운 K개 이웃의 정답으로 예측
학습 단계 없음 (데이터 저장만)
K-Means: 비지도학습 (군집)
K = 만들 군집 수
데이터 → K개 그룹으로 분할
반복 학습으로 중심 위치 결정
|
| 항목 | KNN | K-Means |
|---|
| 학습 유형 | 지도학습 | 비지도학습 |
| K의 의미 | 이웃 수 | 군집 수 |
| 레이블 필요 | ✅ | ❌ |
| 출력 | 클래스 / 값 | 군집 번호 |
| 공통점 | 유클리드 거리 기반 → 스케일링 필수 | |
9. 코드로 보기 — 와인 데이터 군집화
1
2
3
4
5
6
7
8
9
| from sklearn.cluster import KMeans
kmeans = KMeans(
n_clusters = 3, # 군집 수 K
init = 'k-means++', # 초기 중심 선택 방법
n_init = 10, # 초기값을 바꿔 실행할 횟수
max_iter = 300, # 한 번 실행에서 최대 반복 수
random_state = 0
)
|
| Parameter | Default | 역할 | 비고 |
|---|
n_clusters | 8 | 군집 수 K | 가장 중요 |
init | 'k-means++' | 초기 중심 선택 | 'random'도 가능 |
n_init | 'auto' | 초기값 바꿔 반복 실행 횟수 | 클수록 안정, 느림 |
max_iter | 300 | 1회 실행 최대 반복 | - |
tol | 1e-4 | 수렴 판정 기준 | - |
algorithm | 'lloyd' | 최적화 방식 | 'elkan': 군집이 잘 분리될 때 빠름 |
n_clusters : 군집 수 K- 기본값 8은 의미 없는 값 → Elbow·Silhouette로 반드시 탐색
- 비즈니스 관점(예: 마케팅 팀이 관리 가능한 고객 그룹 수)도 함께 고려
n_init : 서로 다른 초기값으로 실행할 횟수- K-Means는 지역 최적해에 빠질 수 있으므로 여러 번 실행해 SSE가 가장 작은 결과 사용
'auto' : k-means++이면 1회, random이면 10회
init : 초기 중심 선택'k-means++' : 서로 멀리 떨어진 점을 초기 중심으로 (권장)'random' : 무작위 선택
9-1. 전처리
와인 데이터는 3개 품종의 와인 178개에 대해 알코올 도수, 색 농도 등 13개 화학 성분을 측정한 데이터입니다.
품종 레이블은 학습에 사용하지 않고, 마지막에 군집 결과가 실제 품종과 얼마나 일치하는지 확인하는 용도로만 씁니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| import numpy as np
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.preprocessing import StandardScaler
wine = load_wine()
X = pd.DataFrame(wine.data, columns=wine.feature_names)
y_true = wine.target # ⚠️ 학습에 사용하지 않음 (평가용)
# ✅ K-Means는 유클리드 거리 기반 → 스케일링 필수
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
print(X.shape)
print(X[['alcohol', 'magnesium', 'proline']].describe().loc[['mean', 'std']].round(1))
|
Note: 와인 데이터의 proline은 평균이 약 750, hue는 약 1로 단위 차이가 수백 배입니다.
스케일링 없이 K-Means를 돌리면 사실상 proline 하나로만 군집이 나뉩니다.
9-2. 최적의 K 찾기 (Elbow & Silhouette)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| import matplotlib.pyplot as plt
from sklearn.metrics import silhouette_score
K_range = range(2, 11)
sse, sil = [], []
for k in K_range:
km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X_scaled)
sse.append(km.inertia_)
sil.append(silhouette_score(X_scaled, km.labels_))
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
axes[0].plot(K_range, sse, 'o-', color='steelblue', lw=2)
axes[0].set_xlabel('K'); axes[0].set_ylabel('SSE (inertia)')
axes[0].set_title('Elbow Method')
axes[1].plot(K_range, sil, 's-', color='tomato', lw=2)
axes[1].set_xlabel('K'); axes[1].set_ylabel('Silhouette Score')
axes[1].set_title('Silhouette Score')
for ax in axes:
ax.axvline(3, color='gray', ls='--', lw=1)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
|
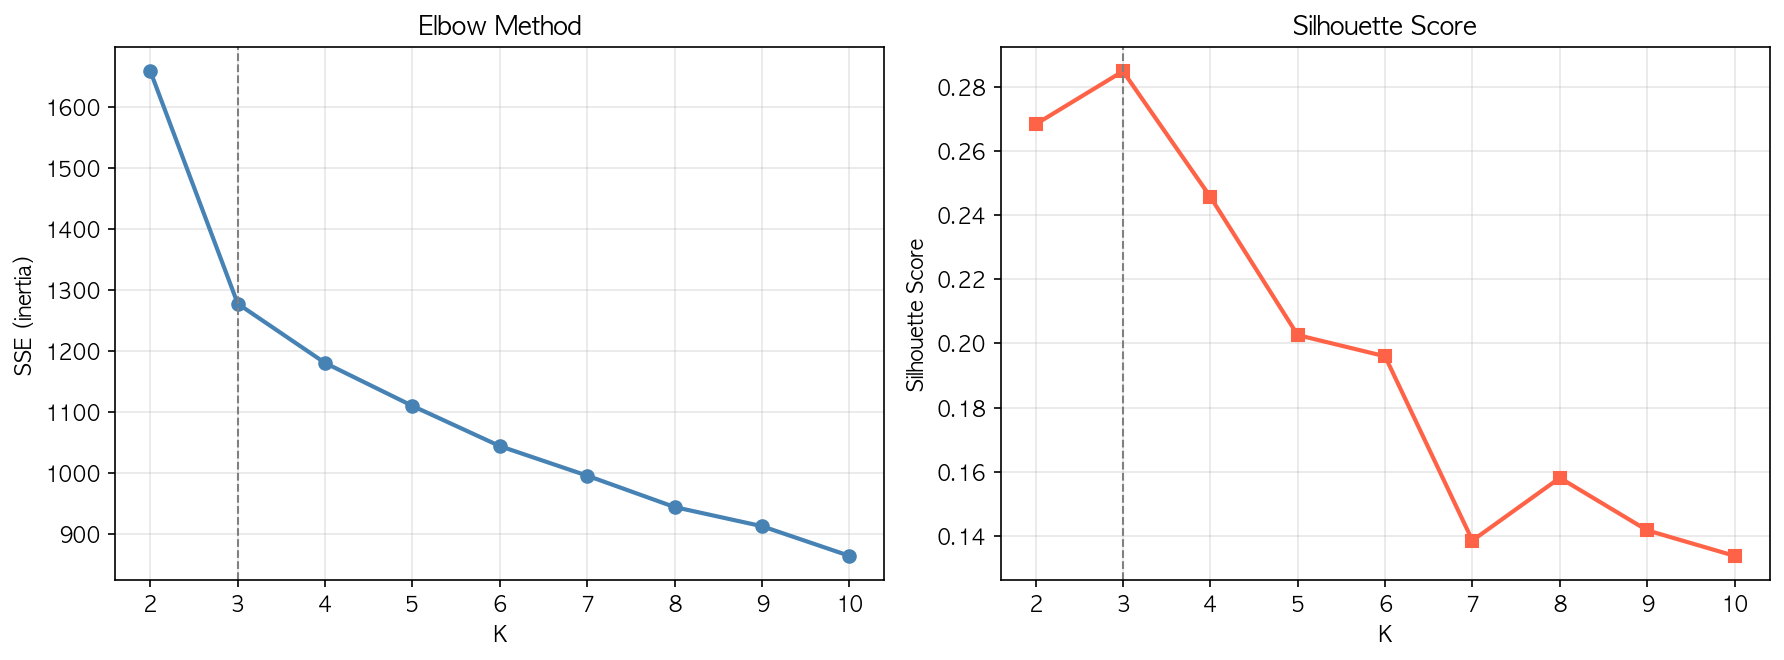
읽는 법:
왼쪽 (Elbow) — K가 커질수록 SSE는 계속 줄어들지만, K=3 이후로는 감소 폭이 눈에 띄게 완만해집니다. 이 꺾이는 지점이 “팔꿈치”입니다.
오른쪽 (Silhouette) — K=3에서 실루엣 점수가 가장 높습니다. 군집 안은 촘촘하고 군집 사이는 잘 떨어져 있다는 뜻입니다.
두 방법 모두 K=3을 가리키며, 실제 와인 품종 수(3개)와도 일치합니다. 실무에서는 두 지표가 서로 다른 K를 가리키는 경우도 많아 해석 가능성까지 함께 고려합니다.
9-3. 모델 학습
1
2
3
4
5
6
| kmeans = KMeans(n_clusters=3, init='k-means++', n_init=10, random_state=0)
labels = kmeans.fit_predict(X_scaled)
print(f"군집별 샘플 수 : {np.bincount(labels)}")
print(f"SSE (inertia) : {kmeans.inertia_:.1f}")
print(f"반복 횟수 : {kmeans.n_iter_}")
|
9-4. 평가
1
2
3
4
5
6
| from sklearn.metrics import silhouette_score, adjusted_rand_score, confusion_matrix
print(f"Silhouette Score : {silhouette_score(X_scaled, labels):.4f}") # 정답 없이 평가
print(f"ARI : {adjusted_rand_score(y_true, labels):.4f}") # 정답과 비교 (참고용)
print()
print(pd.crosstab(y_true, labels, rownames=['실제 품종'], colnames=['군집']))
|
1
2
3
4
5
6
7
8
| Silhouette Score : 0.2849
ARI : 0.8975
군집 0 1 2
실제 품종
0 0 0 59
1 65 3 3
2 0 48 0
|
결과 해석:
품종 0은 전부 군집 2로, 품종 2는 전부 군집 1로 묶였고, 품종 1만 71개 중 6개가 다른 군집으로 갔습니다.
정답을 한 번도 보지 않고 178개 중 172개(96.6%)를 품종대로 나눈 셈이며, ARI 0.90도 거의 완벽한 일치를 뜻합니다.
반면 Silhouette은 0.28로 높지 않은데, 13차원 공간에서 군집 경계가 맞닿아 있기 때문입니다. 내부 지표가 낮아도 의미 있는 군집일 수 있으므로 지표 하나만 보고 판단하지 않습니다.
| 지표 | 정답 필요 | 범위 | 의미 |
|---|
| Silhouette Score | ❌ | -1 ~ 1 | 군집 내 응집도 vs 군집 간 분리도 |
| Inertia (SSE) | ❌ | 0 ~ ∞ | 중심까지 거리 제곱합 (같은 K끼리만 비교) |
| ARI (Adjusted Rand Index) | ✅ | -1 ~ 1 | 실제 레이블과의 일치도 (1 = 완전 일치, 0 = 무작위 수준) |
Note: 실무에서는 정답이 없으므로 Silhouette 같은 내부 지표와 군집별 특성 해석으로 평가합니다.
ARI는 이번처럼 정답을 알고 있을 때 알고리즘 성능을 확인하는 용도입니다.
9-5. 군집 결과 시각화 (PCA 2차원)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| from sklearn.decomposition import PCA
pca = PCA(n_components=2)
X_2d = pca.fit_transform(X_scaled)
centers_2d = pca.transform(kmeans.cluster_centers_)
fig, axes = plt.subplots(1, 2, figsize=(12, 5))
axes[0].scatter(X_2d[:, 0], X_2d[:, 1], c=labels, cmap='viridis', s=30, alpha=0.8)
axes[0].scatter(centers_2d[:, 0], centers_2d[:, 1], c='red', marker='*', s=300, edgecolor='black')
axes[0].set_title('K-Means 군집 결과 (K=3)')
axes[1].scatter(X_2d[:, 0], X_2d[:, 1], c=y_true, cmap='viridis', s=30, alpha=0.8)
axes[1].set_title('실제 와인 품종')
for ax in axes:
ax.set_xlabel('PC1'); ax.set_ylabel('PC2')
ax.grid(True, alpha=0.2)
plt.tight_layout()
plt.show()
|
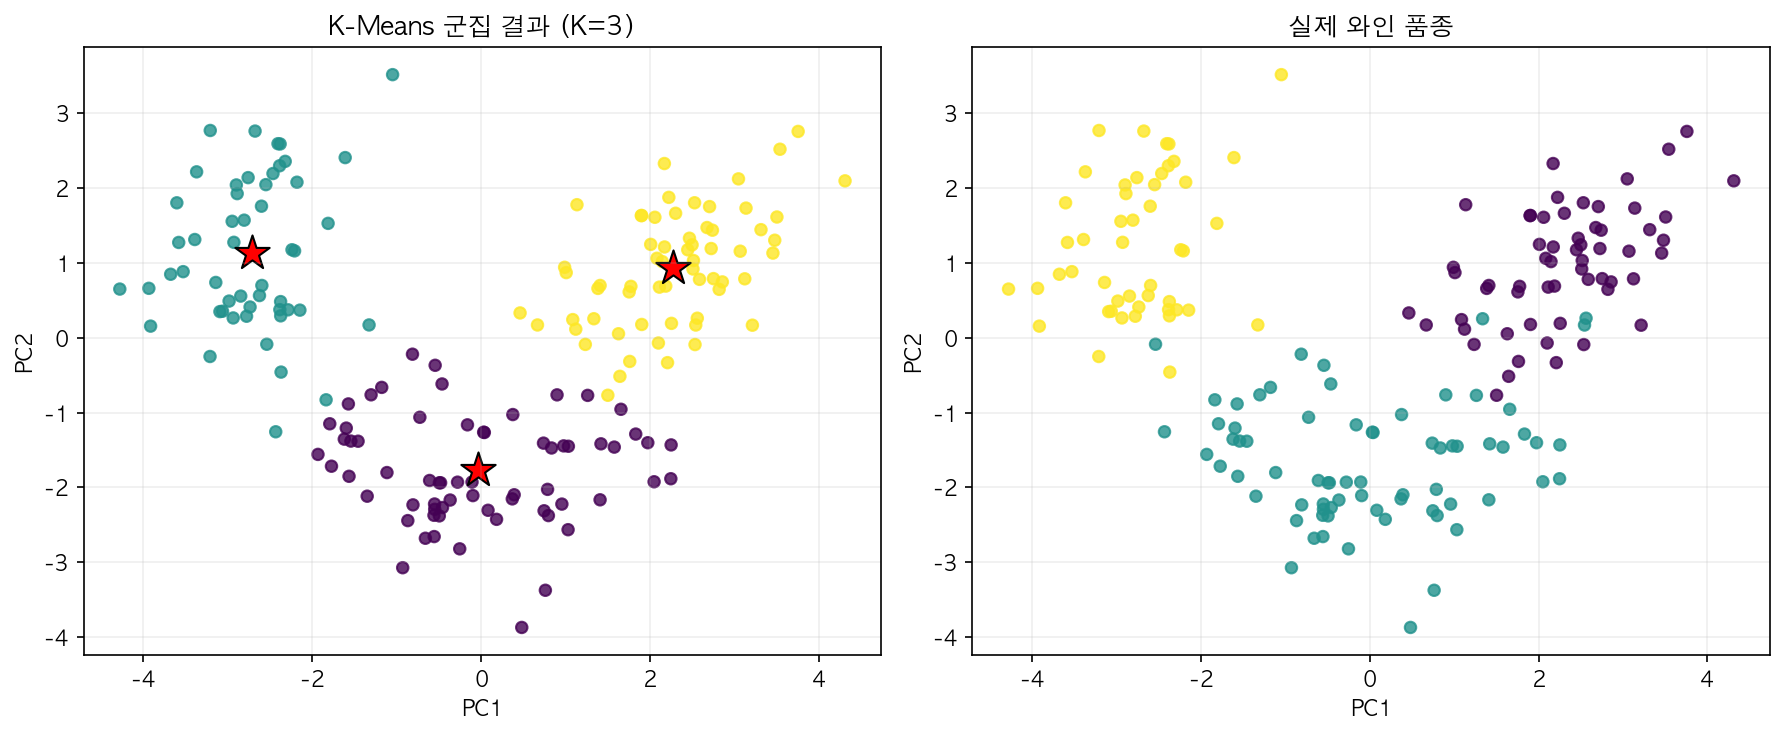
읽는 법:
13차원 데이터를 PCA로 2차원에 투영해 그린 그림입니다. 왼쪽은 K-Means가 찾은 군집(★ = 중심), 오른쪽은 실제 품종입니다.
정답을 전혀 보지 않았는데도 두 그림의 색 배치가 거의 같습니다. 색이 서로 다른 것은 군집 번호가 임의로 붙기 때문이며, 번호 자체에는 의미가 없습니다.
경계 부근의 몇몇 점만 다르게 묶였는데, 화학 성분상 다른 품종과 비슷한 와인들입니다.
9-6. 군집별 특성 해석
1
2
| profile = X.assign(cluster=labels).groupby('cluster').mean()
print(profile[['alcohol', 'malic_acid', 'flavanoids', 'color_intensity', 'proline']].round(2))
|
1
2
3
4
5
| alcohol malic_acid flavanoids color_intensity proline
cluster
0 12.25 1.90 2.05 2.97 510.17
1 13.13 3.31 0.82 7.23 619.06
2 13.68 2.00 3.00 5.45 1100.23
|
| 군집 | 특징 | 이름 붙이기 |
|---|
| 0 | 알코올·색 농도·proline 모두 낮음 | 가볍고 연한 와인 |
| 1 | 색이 가장 진하고 malic acid ↑, flavanoids ↓ | 진하고 산미 강한 와인 |
| 2 | 알코올·flavanoids·proline 모두 가장 높음 | 묵직하고 풍부한 와인 |
군집 번호는 의미가 없으므로, 이렇게 군집별 평균을 보고 사람이 이름을 붙여야 K-Means 결과가 비로소 쓸모 있어집니다.