1. 왜 등장했는가
“면적이 넓을수록 집값이 비싸다”처럼 두 값 사이의 관계를 하나의 직선(수식) 으로 표현하고 싶을 때가 많습니다.
Linear Regression은 데이터를 가장 잘 설명하는 직선(또는 평면)을 찾아 연속적인 값을 예측하는 가장 기본적인 회귀 모델입니다.
최소제곱법(Least Squares)은 1800년대 초 Legendre와 Gauss가 제안했으며, Ridge·Lasso·Logistic Regression 등 수많은 모델의 출발점이 됩니다.
Ridge와 Lasso가 “계수에 세금을 매기는” 모델이라면,
Linear Regression은 “세금 없이 오차만 최소화하는” 기본형입니다.
2. 핵심 아이디어 — “오차의 제곱합이 가장 작은 직선”
Linear Regression은 본질적으로 모든 점까지의 세로 거리(잔차)를 제곱해서 더한 값이 가장 작아지는 직선을 찾습니다.
1
2
3
4
5
6
7
8
| 집값 = β₀ + β₁ × 면적
데이터: (20평, 3억), (30평, 4.5억), (40평, 5.5억), (50평, 7억)
후보 직선 A: 집값 = 0.50 + 0.12 × 면적 → 잔차 제곱합 = 0.46
후보 직선 B: 집값 = 0.45 + 0.13 × 면적 → 잔차 제곱합 = 0.05 ✅
→ 잔차 제곱합(SSE)이 가장 작은 직선 B를 선택
|
읽는 법:
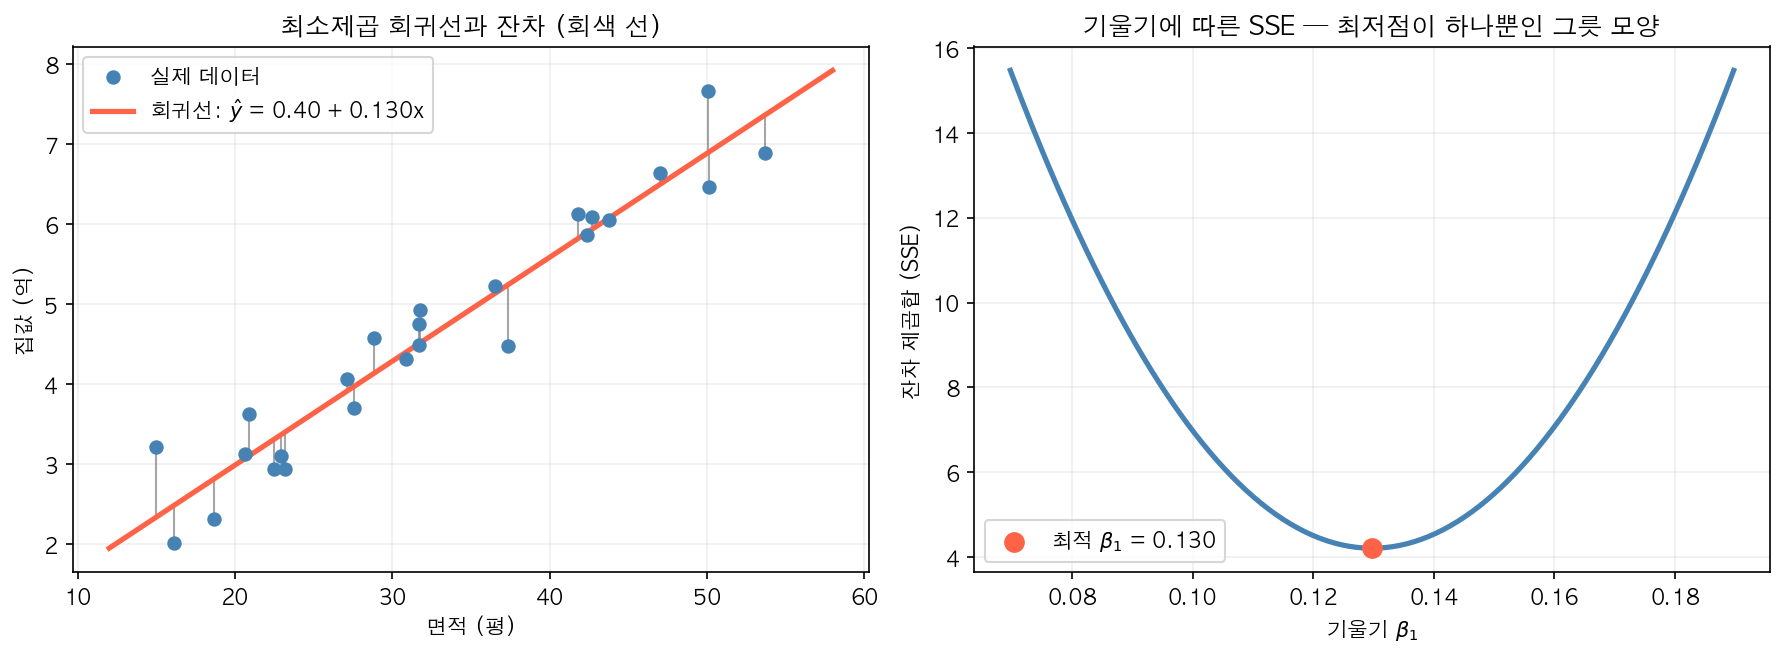
왼쪽 — 파란 점은 실제 데이터, 빨간 선은 최소제곱법으로 찾은 회귀선입니다. 회색 세로선이 각 점의 잔차(실제값 − 예측값) 입니다.
오른쪽 — 기울기 β₁를 바꿔가며 잔차 제곱합(SSE)을 계산한 곡선입니다. 그릇 모양(볼록 함수)이므로 최저점이 단 하나 존재하고, 그 지점이 최적 기울기입니다.
이 “그릇 모양” 덕분에 Linear Regression은 수식 하나(정규방정식)로 정답을 바로 구할 수 있습니다.
3. 실제 예시로 보기 (회귀)
예시 1 — 집값 예측 (회귀)
1
2
3
4
5
6
7
8
9
10
11
| 특성: 면적(평), 방 수, 건물 나이(년)
학습된 모델:
집값(억) = 0.8 + 0.12×면적 + 0.30×방 수 − 0.05×건물 나이
해석:
면적 1평 증가 → 집값 0.12억(1,200만 원) 증가 (다른 조건이 같을 때)
건물 나이 1년 증가 → 집값 0.05억(500만 원) 감소
새 집: 면적 32평, 방 3개, 건물 나이 10년
예측 = 0.8 + 0.12×32 + 0.30×3 − 0.05×10 = 5.04억
|
계수 하나하나가 “다른 조건이 같을 때 이 특성이 1 늘면 결과가 얼마나 변하는가”를 뜻하므로
해석력이 매우 높다는 것이 Linear Regression의 가장 큰 무기입니다.
예시 2 — 광고비와 매출 (회귀)
1
2
3
4
5
6
7
8
9
10
11
12
13
| ┌────────────┬──────────────┬────────┐
│ TV 광고비 │ 라디오 광고비│ 매출 │
├────────────┼──────────────┼────────┤
│ 230 │ 38 │ 22.1 │
│ 44 │ 39 │ 10.4 │
│ 17 │ 46 │ 9.3 │
│ 151 │ 41 │ 18.5 │
└────────────┴──────────────┴────────┘
학습 결과: 매출 = 2.9 + 0.046×TV + 0.19×라디오
→ 라디오 광고 1단위가 TV 광고 1단위보다 매출 효과가 약 4배 큼
→ 예산 배분 의사결정에 바로 활용 가능
|
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| ┌────────────────────────────────────────┐
│ 선형 가설 설정 │ ← ŷ = β₀ + β₁x₁ + ... + βₚxₚ
└──────────────────┬─────────────────────┘
│
▼
┌────────────────────────────────────────┐
│ 손실 함수 정의 (MSE) │ ← 잔차 제곱의 평균
└──────────────────┬─────────────────────┘
│
┌─────────┴──────────┐
▼ ▼
[정규방정식 (OLS)] [경사하강법 (GD)]
한 번에 정확한 해 반복적으로 최저점 접근
(sklearn 기본) (SGDRegressor, 대용량)
│
▼
┌────────────────────────────────────────┐
│ 계수 β 확정 → 새 데이터 예측 │
└────────────────────────────────────────┘
|
읽는 법:
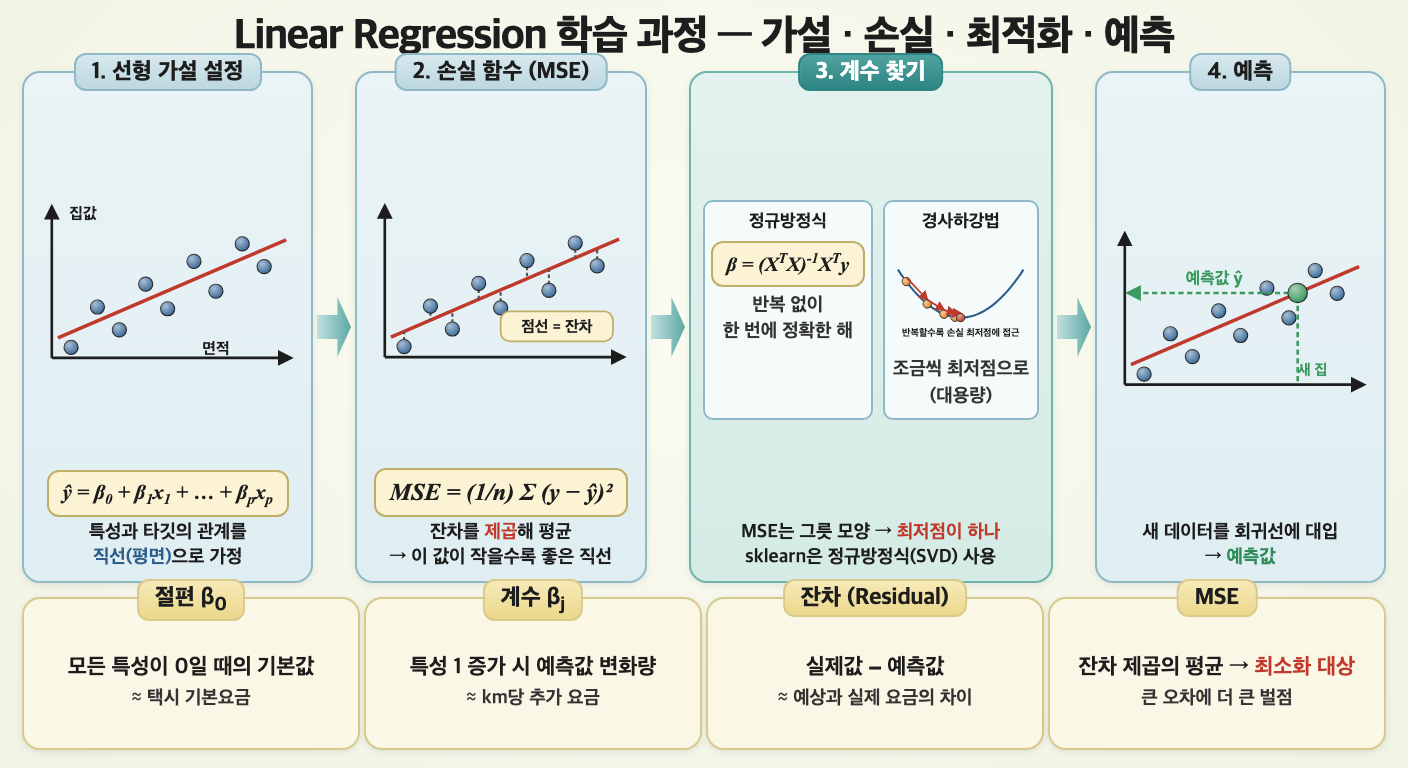
위쪽 네 칸을 왼쪽에서 오른쪽으로 읽으면 학습 순서입니다.
1 — 특성과 타깃의 관계를 직선(평면) ŷ = β₀ + β₁x₁ + … 로 가정합니다.
2 — 점과 직선 사이의 점선이 잔차이고, 잔차 제곱의 평균(MSE)이 줄여야 할 대상입니다.
3 — 계수는 정규방정식으로 한 번에 구하거나, 경사하강법으로 그릇 모양 손실 곡선의 바닥까지 조금씩 내려가며 찾습니다.
4 — 학습된 직선에 새 데이터(초록 점)를 대입하면 예측값이 나옵니다.
아래 네 칸은 절편·계수·잔차·MSE를 택시 요금에 비유해 정리한 것입니다.
| 구성 요소 | 설명 | 비유 |
|---|
| 절편 β₀ | 모든 특성이 0일 때의 기본값 | 택시 기본요금 |
| 계수 βⱼ | 특성 1단위 증가 시 예측값 변화량 | km당 추가 요금 |
| 잔차 (Residual) | 실제값 − 예측값 | 실제 요금과 예상 요금의 차이 |
| MSE | 잔차 제곱의 평균 → 최소화 대상 | 예상이 얼마나 빗나갔는지 점수 |
5. 어떻게 계수를 찾는가
5-1. 손실 함수 (MSE)
\[\text{MSE} = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2 = \frac{1}{n}\sum_{i=1}^{n}\left(y_i - \beta_0 - \sum_{j=1}^{p}\beta_j x_{ij}\right)^2\]
1
2
3
4
| 왜 제곱을 하는가?
1. 양수/음수 잔차가 서로 상쇄되지 않도록
2. 큰 오차에 더 큰 벌점 → 크게 빗나가는 예측을 강하게 억제
3. 미분이 쉬워 해를 수식으로 구할 수 있음
|
\[\hat{\beta} = (X^TX)^{-1}X^Ty\]
1
2
3
4
5
6
| MSE를 β로 미분해 0이 되는 지점을 찾으면 위 공식이 나옴
장점: 반복 없이 한 번에 정확한 해
단점: XᵀX의 역행렬 계산 → 특성 수 p에 대해 O(p³)
특성끼리 강하게 상관되면 XᵀX가 역행렬을 갖기 어려움 → 계수 폭발
→ 이 문제를 해결하려고 Ridge가 등장 (XᵀX + αI)
|
5-3. 경사하강법 (Gradient Descent)
\[\beta \leftarrow \beta - \eta \cdot \frac{\partial \text{MSE}}{\partial \beta} = \beta + \eta \cdot \frac{2}{n}X^T(y - X\beta)\]
1
2
3
4
5
6
7
| 데이터가 수백만 건이거나 특성이 매우 많아 역행렬 계산이 부담될 때 사용
1. β를 임의 값으로 시작
2. 손실이 줄어드는 방향(기울기 반대)으로 η(학습률)만큼 이동
3. 손실이 더 이상 줄지 않을 때까지 반복
η가 너무 크면 → 발산 / 너무 작으면 → 수렴이 매우 느림
|
읽는 법:
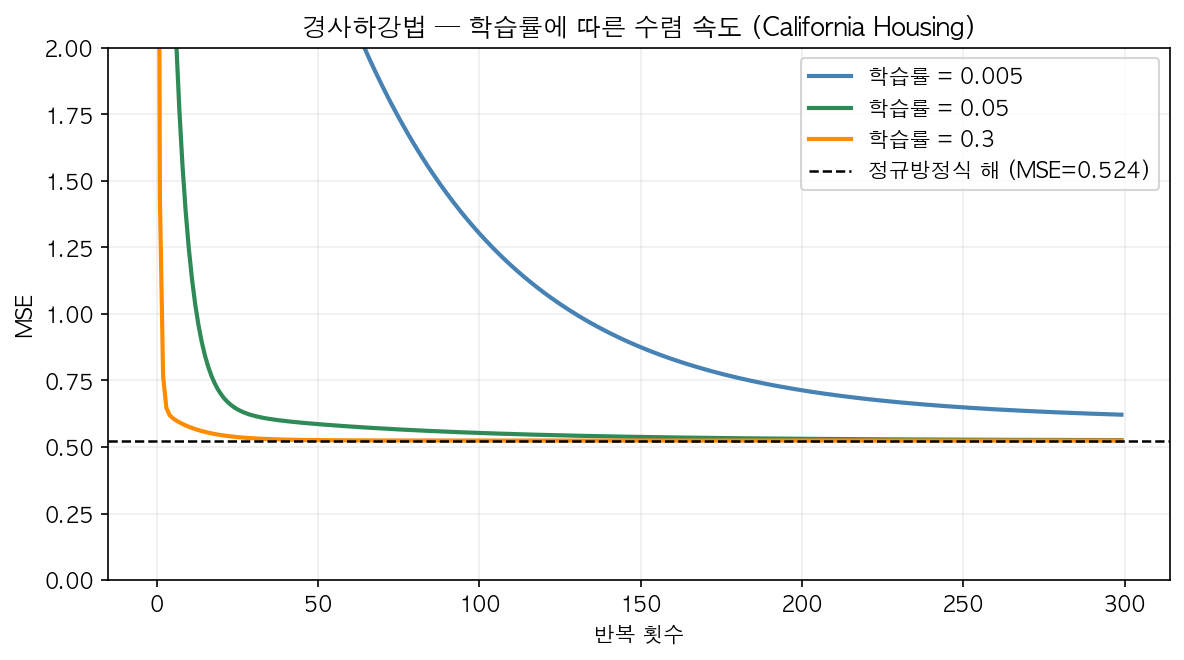
학습률에 따라 반복 횟수 대비 MSE가 어떻게 줄어드는지 비교한 그림입니다.
학습률이 클수록(주황·초록) 빠르게 최저점에 수렴하고, 너무 작으면(파랑) 300번을 반복해도 아직 도달하지 못합니다.
점선은 정규방정식으로 한 번에 구한 최소 MSE로, 경사하강법이 결국 같은 답에 도달함을 보여줍니다.
5-4. Linear Regression의 가정
| 가정 | 의미 | 위반 시 |
|---|
| 선형성 | 특성과 타깃이 직선 관계 | 예측 편향 → 다항 특성/트리 모델 |
| 독립성 | 각 관측치의 오차가 서로 독립 | 시계열에서 자주 위반 |
| 등분산성 | 잔차의 분산이 일정 | 신뢰구간 왜곡 → 로그 변환 |
| 정규성 | 잔차가 정규분포 | 검정(p-value) 신뢰도 하락 |
| 다중공선성 없음 | 특성끼리 강한 상관이 없음 | 계수 불안정 → Ridge/Lasso |
6. Linear Regression 장・단점
6-1. ✅ Linear Regression 장점
1
2
3
4
5
6
7
8
9
10
11
| 1. 해석이 쉬움
→ 계수 하나하나가 "이 특성이 결과에 미치는 영향"을 직접 의미
2. 매우 빠름
→ 정규방정식으로 한 번에 해를 구함, 하이퍼파라미터 튜닝 거의 불필요
3. 다른 모델의 기준선(Baseline)
→ 복잡한 모델이 Linear Regression보다 나은지 비교하는 출발점
4. 통계적 추론 가능
→ statsmodels로 계수별 p-value, 신뢰구간 계산 가능
|
6-2. ❌ Linear Regression이 약한 상황
1
2
3
4
5
6
7
8
9
10
11
| 1. 비선형 관계
→ 직선으로 곡선 관계를 표현할 수 없음 → 다항 특성 또는 트리 모델
2. 다중공선성
→ 비슷한 특성끼리 계수를 나눠 가지며 값이 요동침 → Ridge/Lasso
3. 이상치에 민감
→ 제곱 손실이라 이상치 하나가 직선을 크게 끌어당김 → HuberRegressor
4. 특성이 데이터보다 많을 때 (p > n)
→ XᵀX 역행렬이 존재하지 않음 → Lasso/Ridge 필수
|
6-2-1. 비선형 관계 문제
Linear Regression의 가장 큰 약점입니다.
1
2
3
4
5
6
| 실제 관계: 매출 = 광고비의 제곱근 형태 (처음엔 급증, 점점 둔화)
Linear Regression: 직선 하나로 근사
→ 광고비가 적은 구간: 과소 예측
→ 광고비가 많은 구간: 과대 예측
→ 잔차 그래프에 U자 패턴이 나타남 (선형성 가정 위반 신호)
|
해결책 :
1
2
3
4
5
6
7
8
9
10
11
12
13
| from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import LinearRegression, HuberRegressor
# 방법 1: 다항 특성 추가 (x, x², x₁x₂ ...)
poly_lr = make_pipeline(
PolynomialFeatures(degree=2, include_bias=False),
StandardScaler(),
LinearRegression()
)
# 방법 2: 이상치에 강한 Huber 손실 사용
huber = HuberRegressor(epsilon=1.35) # epsilon보다 큰 잔차는 절댓값 손실로 처리
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 지도학습 / 회귀 |
| 핵심 아이디어 | 잔차 제곱합(MSE)을 최소화하는 직선(평면) 찾기 |
| 해 구하는 법 | 정규방정식 (XᵀX)⁻¹Xᵀy 또는 경사하강법 |
| 스케일링 필요? | ❌ 예측 성능엔 불필요 / ✅ 계수 크기 비교·경사하강법엔 필요 |
| 핵심 파라미터 | 사실상 없음 (fit_intercept 정도) |
| 실전 사용 | 베이스라인 모델, 영향 요인 해석, 수요·가격 예측 |
8. 다른 알고리즘과 무엇이 다른가
Linear vs Ridge vs Lasso
1
2
3
4
5
6
7
8
| 손실 함수 비교:
Linear: MSE ← 패널티 없음, 데이터에 최대한 맞춤
Ridge: MSE + α×Σβⱼ² ← 계수를 고르게 축소
Lasso: MSE + α×Σ|βⱼ| ← 일부 계수를 정확히 0으로
→ Ridge/Lasso는 Linear Regression에 "규제"를 더한 확장판
→ α = 0이면 Ridge와 Lasso 모두 Linear Regression과 같아짐
|
| 항목 | Linear | Ridge | Lasso |
|---|
| 패널티 | 없음 | L2 | L1 |
| 과적합 위험 | 높음 (특성 많을 때) | 낮음 | 낮음 |
| 다중공선성 | ❌ 약함 | ✅ 강함 | ⚠️ 하나만 선택 |
| 특성 선택 | ❌ | ❌ | ✅ |
| 하이퍼파라미터 | 없음 | alpha | alpha |
9. 코드로 보기 — 집값 예측 (회귀)
1
2
3
4
5
| from sklearn.linear_model import LinearRegression
lr = LinearRegression(
fit_intercept = True # 절편 β₀ 학습 여부
)
|
| Parameter | Default | 역할 | 과적합 방향 |
|---|
fit_intercept | True | 절편 포함 여부 | - |
positive | False | 계수를 양수로 제한 | - |
n_jobs | None | 병렬 처리 (다중 타깃일 때) | - |
fit_intercept : 절편 학습 여부- 데이터를 미리 중심화(평균 0)하지 않았다면 반드시
True
positive : 계수를 0 이상으로 강제- 가격·수량처럼 음수 영향이 말이 안 되는 경우에 사용
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| import pandas as pd
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
data = fetch_california_housing()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target # 단위: 10만 달러
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=0)
# ⚠️ 예측 성능엔 영향 없지만, 계수 크기를 서로 비교하려면 스케일링 필요
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)
|
Note: Linear Regression은 스케일링을 해도 예측값은 동일합니다.
다만 스케일링 후에는 계수가 “특성 1 표준편차 변화당 효과”가 되어 특성 간 영향력 비교가 가능해집니다.
9-2. 모델 학습
1
2
3
4
5
6
| lr = LinearRegression(fit_intercept=True)
lr.fit(X_train, y_train)
print(f"절편 (β₀) : {lr.intercept_:.4f}")
for name, coef in zip(data.feature_names, lr.coef_):
print(f"{name:>10} : {coef:+.4f}")
|
9-2-1. 교차 검증으로 안정성 확인
1
2
3
4
| from sklearn.model_selection import cross_val_score
scores = cross_val_score(LinearRegression(), X_train, y_train, cv=5, scoring='r2')
print(f"CV R² : {scores.mean():.4f} ± {scores.std():.4f}")
|
9-3. 평가
1
2
3
4
5
6
7
8
| import numpy as np
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
pred = lr.predict(X_test)
print(f"R² : {r2_score(y_test, pred):.4f}")
print(f"RMSE : {np.sqrt(mean_squared_error(y_test, pred)):.4f}")
print(f"MAE : {mean_absolute_error(y_test, pred):.4f}")
|
| 지표 | 의미 | 해석 |
|---|
| R² | 타깃 분산 중 모델이 설명하는 비율 | 1에 가까울수록 좋음 (0.6 ≈ 60% 설명) |
| RMSE | 오차 제곱 평균의 제곱근 | 타깃과 같은 단위, 큰 오차에 민감 |
| MAE | 오차 절댓값의 평균 | 이상치에 덜 민감 |
9-4. 계수 시각화
1
2
3
4
5
6
7
8
9
10
11
12
| import matplotlib.pyplot as plt
coef = pd.Series(lr.coef_, index=data.feature_names).sort_values()
plt.figure(figsize=(7, 5))
colors = ['tomato' if c > 0 else 'steelblue' for c in coef]
coef.plot(kind='barh', color=colors)
plt.axvline(0, color='black', linewidth=0.8)
plt.xlabel('Coefficient (표준화 기준)')
plt.title('Linear Regression 계수')
plt.tight_layout()
plt.show()
|
읽는 법:
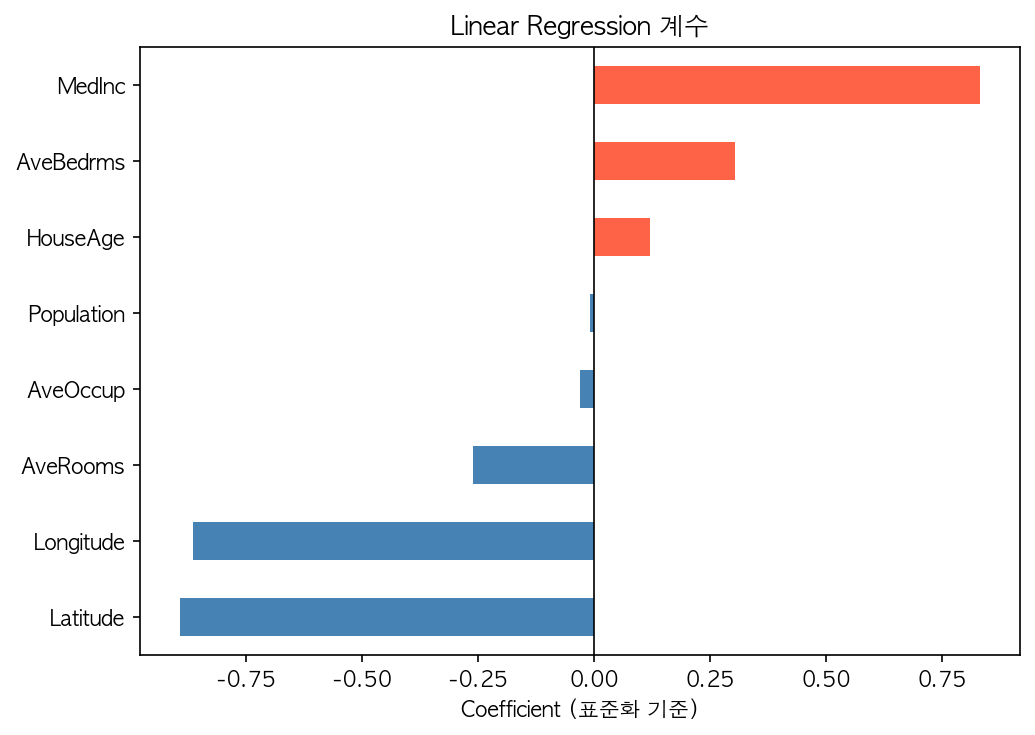
빨간 막대는 값이 커질수록 집값을 올리는 특성, 파란 막대는 내리는 특성입니다.
MedInc(소득)가 가장 강한 양의 영향을 줍니다.
Latitude·Longitude가 크게 음수인 것은 위도·경도가 서로 강하게 얽혀 있기 때문으로(다중공선성), 계수를 단독으로 해석할 때 주의해야 합니다.
9-5. 잔차 분석
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
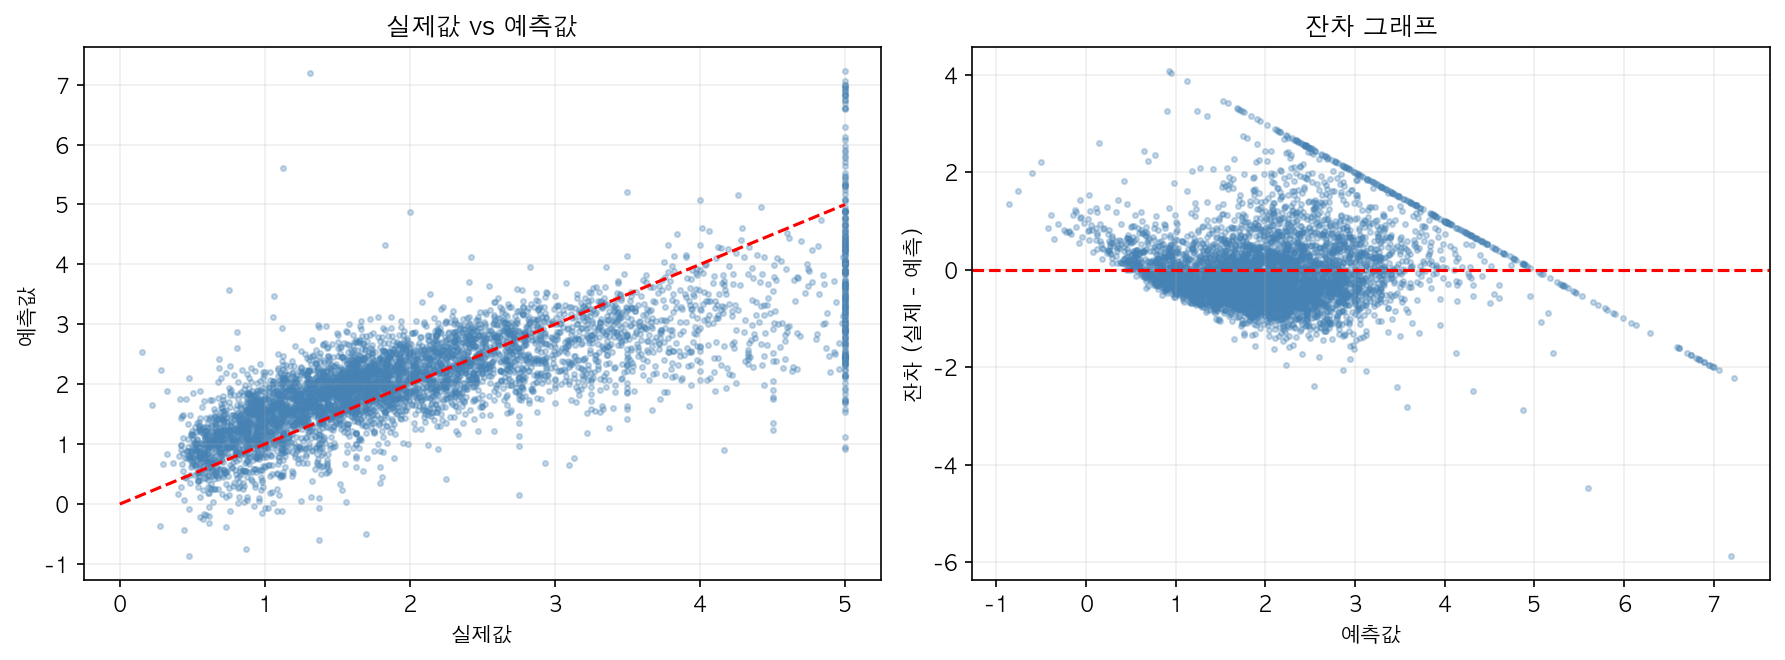
| residual = y_test - pred
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
# 실제값 vs 예측값
axes[0].scatter(y_test, pred, s=6, alpha=0.3, color='steelblue')
axes[0].plot([0, 5], [0, 5], 'r--', lw=1.5)
axes[0].set_xlabel('실제값'); axes[0].set_ylabel('예측값')
axes[0].set_title('실제값 vs 예측값')
# 예측값 vs 잔차
axes[1].scatter(pred, residual, s=6, alpha=0.3, color='steelblue')
axes[1].axhline(0, color='red', ls='--', lw=1.5)
axes[1].set_xlabel('예측값'); axes[1].set_ylabel('잔차 (실제 - 예측)')
axes[1].set_title('잔차 그래프')
for ax in axes:
ax.grid(True, alpha=0.2)
plt.tight_layout()
plt.show()
|
읽는 법:
왼쪽 — 점들이 빨간 대각선에 가까울수록 정확한 예측입니다. 실제값 5(상한선)에서 점들이 일자로 쌓인 것은 데이터의 집값이 50만 달러로 잘려 있기 때문입니다.
오른쪽 — 잔차가 0을 중심으로 고르게 퍼져 있어야 좋은 모델입니다. 오른쪽 위에서 아래로 그어진 사선은 상한선(5)에 잘린 집들이 만든 패턴입니다.
이처럼 잔차에 뚜렷한 모양이 보인다면 선형성·등분산성 가정이 깨졌다는 신호로, 타깃 로그 변환이나 트리 기반 모델을 고려할 수 있습니다.