1. 왜 등장했는가
특성이 수십 ~ 수천 개가 되면 학습이 느려지고, 거리 기반 모델(KNN, K-Means)은 차원의 저주로 성능이 떨어지며, 사람이 데이터를 눈으로 확인할 수도 없습니다.
게다가 많은 특성은 서로 강하게 상관되어 같은 정보를 중복해서 담고 있는 경우가 많습니다.
PCA(Principal Component Analysis, 주성분 분석)는 데이터의 분산(정보)을 최대한 보존하는 새로운 축을 찾아, 적은 수의 축으로 데이터를 요약하는 차원 축소 기법입니다. (Pearson, 1901 / Hotelling, 1933)
Lasso가 “필요 없는 특성을 골라 버리는” 특성 선택이라면,
PCA는 “여러 특성을 섞어 핵심만 담은 새 특성을 만드는” 특성 추출입니다.
2. 핵심 아이디어 — “데이터가 가장 넓게 퍼진 방향을 찾는다”
PCA는 본질적으로 데이터를 가장 넓게 퍼뜨려 보이는 방향(분산 최대 방향)으로 좌표축을 돌리는 방법입니다.
1
2
3
4
5
6
7
8
9
| 학생 성적: 국어, 영어 점수 (두 과목 상관 높음)
원래 축: 국어 축, 영어 축 → 두 축 모두 비슷한 정보 (언어 능력)
PCA:
PC1 = 0.71×국어 + 0.71×영어 → "언어 능력 종합" (분산 90%)
PC2 = 0.71×국어 − 0.71×영어 → "국어 vs 영어 성향" (분산 10%)
→ PC1 하나만 남겨도 정보의 90%를 유지 → 2차원 → 1차원 축소
|
읽는 법:
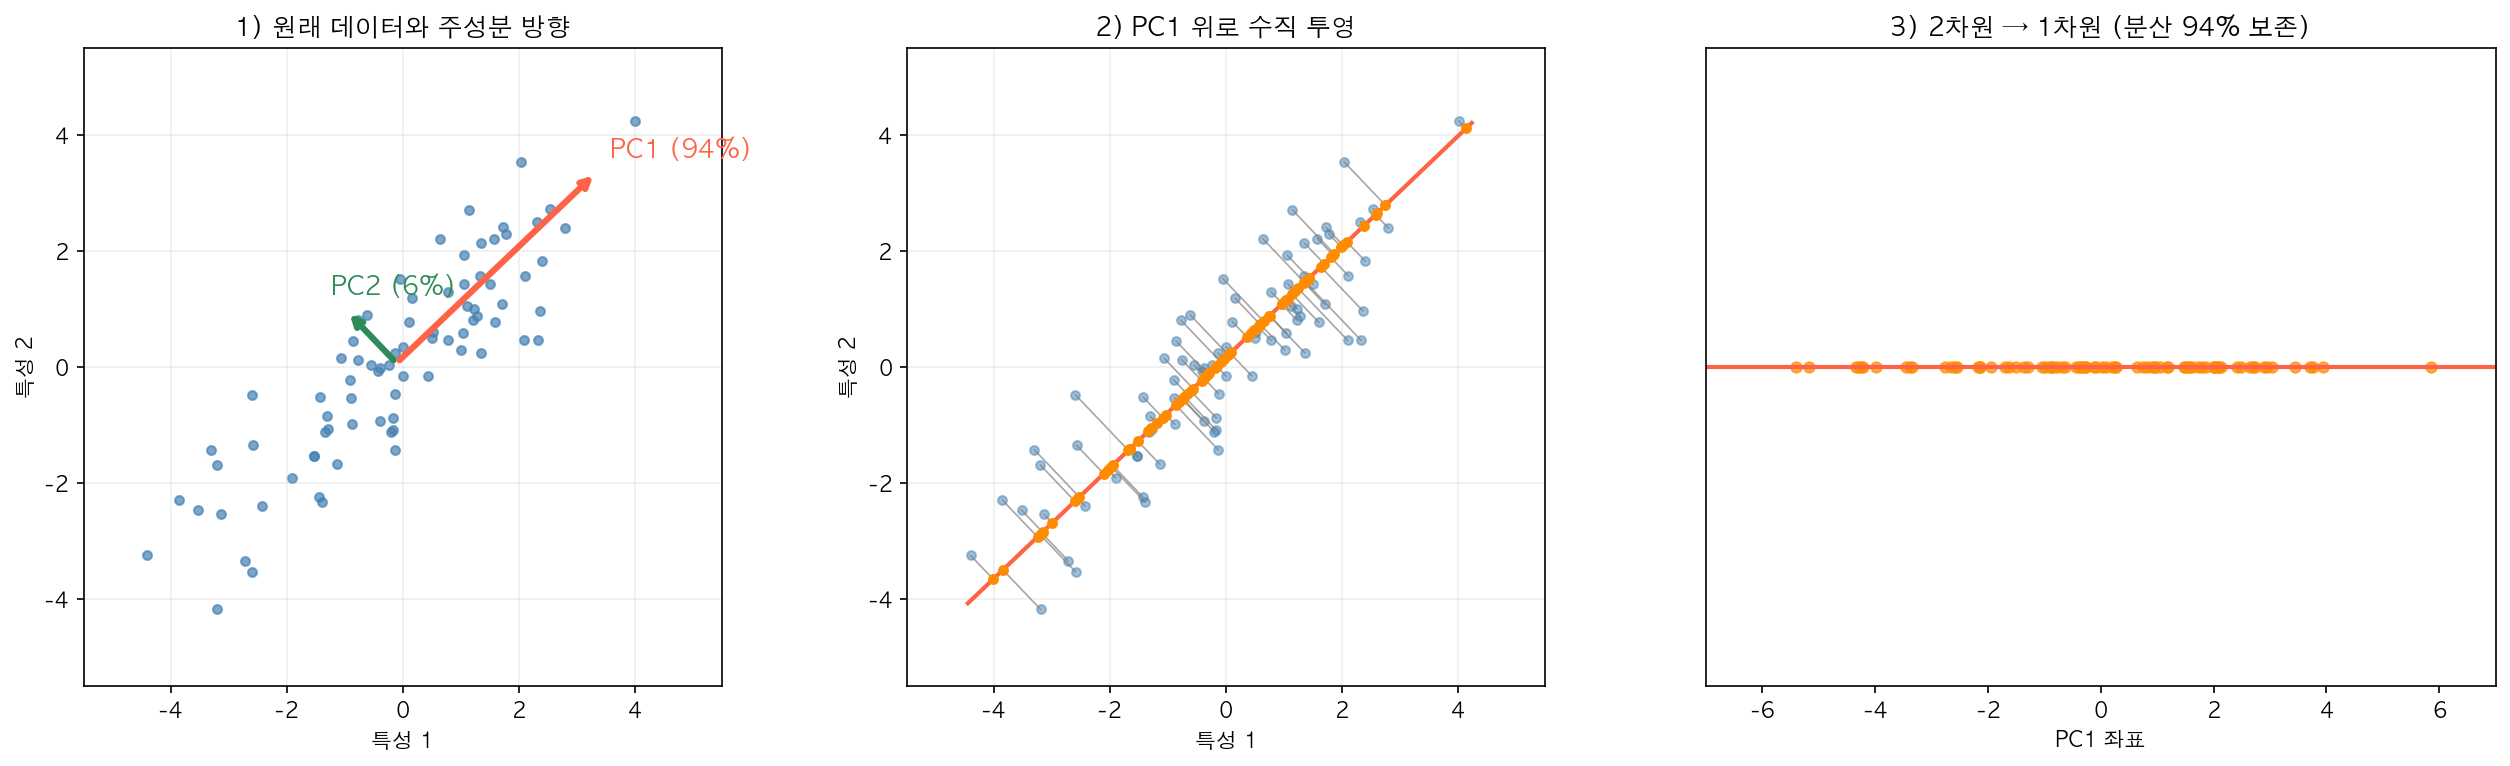
왼쪽 — 상관이 높은 2차원 데이터와 PCA가 찾은 두 축입니다. 빨간 화살표(PC1)는 데이터가 가장 넓게 퍼진 방향, 초록 화살표(PC2)는 그와 직교하는 방향이며 화살표 길이는 그 방향의 분산 크기입니다.
가운데 — 각 점을 PC1 위로 수직 투영(회색 선)한 모습입니다. 투영된 점(주황)들이 원래 데이터의 퍼짐을 대부분 유지합니다.
오른쪽 — PC1 하나만으로 표현한 1차원 데이터입니다. 2차원에서 1차원으로 줄었지만 분산의 대부분이 남아 있습니다.
PCA는 투영했을 때 분산이 가장 큰 축 = 투영 거리(회색 선)의 제곱합이 가장 작은 축을 찾는 것과 같습니다.
3. 실제 예시로 보기 (차원 축소)
예시 1 — 유방암 진단 데이터 (차원 축소 + 분류)
1
2
3
4
5
6
7
8
9
10
| 특성 30개: 종양의 반지름, 둘레, 면적, 질감, 오목함 ... (평균·표준오차·최댓값)
→ 반지름·둘레·면적은 사실상 같은 정보 (상관 0.99 이상)
PCA 결과:
PC1 하나 → 분산의 약 44%
PC1 ~ PC2 → 약 63%
PC1 ~ PC10 → 약 95%
→ 30차원을 10차원으로 줄여도 정보 95% 유지
→ 2차원으로 줄이면 악성/양성이 눈에 보이게 분리됨 (시각화)
|
예시 2 — 얼굴 이미지 압축 (Eigenfaces)
1
2
3
4
5
6
7
8
| 얼굴 사진 64×64 = 픽셀 4,096개 → 4,096차원 벡터
PCA로 주성분 150개 추출:
각 주성분 = "고유 얼굴(Eigenface)" — 조명 방향, 얼굴 윤곽, 눈·코 위치 같은 패턴
모든 얼굴 ≈ 평균 얼굴 + Σ (계수 × 고유 얼굴)
→ 4,096개 숫자 대신 150개 계수로 얼굴 표현 (약 96% 압축)
→ 얼굴 인식 모델의 입력으로 사용
|
4. 알고리즘 구성 요소
5. 어떻게 주성분을 찾는가
5-1. 분산 최대화
\[w_1 = \arg\max_{\|w\|=1} \; \text{Var}(Xw) = \arg\max_{\|w\|=1} \; w^T \Sigma\, w\]
1
2
3
4
5
6
7
8
9
| Σ : 표준화된 데이터의 공분산 행렬 (p × p)
w : 단위 길이의 방향 벡터
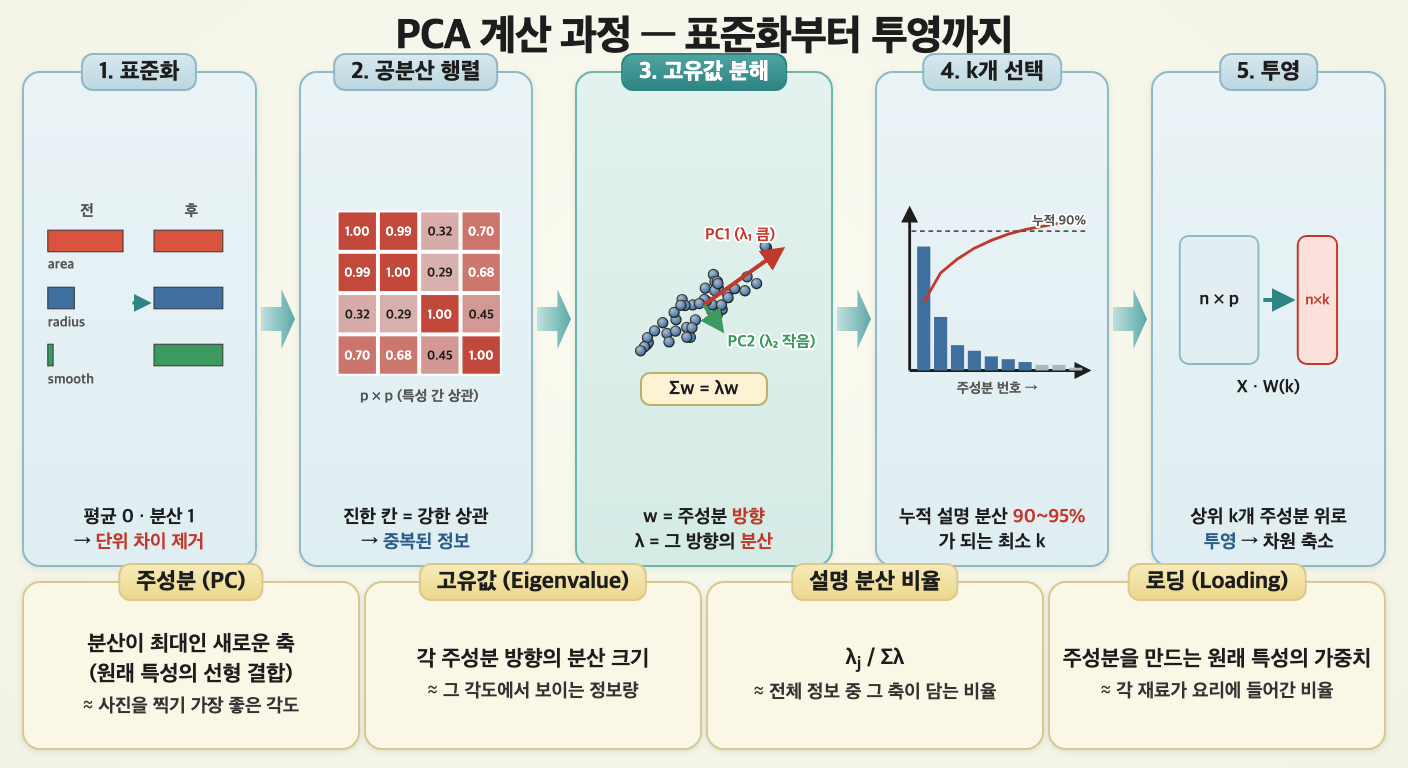
라그랑주 승수법으로 풀면 → Σw = λw (고유값 문제)
→ 분산을 최대로 하는 방향 = 가장 큰 고유값의 고유벡터 = PC1
→ PC2 = PC1과 직교하면서 분산이 최대인 방향 = 두 번째 고유벡터
→ ...
각 주성분의 분산 = 해당 고유값 λ
|
5-2. 설명 분산 비율과 k 선택
\[\text{설명 분산 비율}_j = \frac{\lambda_j}{\sum_{i=1}^{p}\lambda_i}\]
1
2
3
4
5
6
7
8
9
10
| k를 정하는 3가지 방법:
1. 누적 설명 분산 기준
→ 누적 비율이 90% 또는 95%가 되는 최소 k (가장 많이 사용)
2. Scree Plot (팔꿈치)
→ 고유값 그래프가 꺾이며 평평해지기 직전의 k
3. 모델 성능 기준
→ PCA + 모델 Pipeline에서 k를 하이퍼파라미터로 교차 검증
|
5-3. 왜 표준화가 필수인가
1
2
3
4
5
6
7
8
9
| 유방암 데이터: area(면적) 분산 ≈ 123,000 / smoothness(매끄러움) 분산 ≈ 0.0002
표준화 없이 PCA:
→ 분산이 압도적으로 큰 area 방향이 곧 PC1
→ PC1 설명 분산 98% → "정보를 잘 요약했다"는 착각
→ 실제로는 단위가 큰 특성 하나를 그대로 가져온 것뿐
표준화 후 PCA:
→ 모든 특성이 분산 1로 동등하게 경쟁 → 진짜 상관 구조를 반영한 주성분
|
6. PCA 장・단점
6-1. ✅ PCA 장점
1
2
3
4
5
6
7
8
9
10
11
12
13
| 1. 차원 축소로 학습 속도 향상, 차원의 저주 완화
→ 거리 기반 모델(KNN, SVM, K-Means)의 전처리로 효과적
2. 다중공선성 제거
→ 주성분끼리는 서로 완전히 무상관 (직교)
3. 시각화
→ 고차원 데이터를 2~3차원으로 투영해 구조 확인
4. 노이즈 제거
→ 분산이 작은 하위 주성분을 버리면 잡음이 줄어듦
5. 레이블 불필요, 하이퍼파라미터가 사실상 k 하나
|
6-2. ❌ PCA가 약한 상황
1
2
3
4
5
6
7
8
9
10
11
12
13
| 1. 해석력 손실
→ PC1 = 0.22×반지름 + 0.21×둘레 + ... 30개 특성의 혼합 → 의미 설명이 어려움
2. 비선형 구조
→ 선형 투영만 가능 → 휘어진 매니폴드(스위스 롤 등)는 펼치지 못함
→ Kernel PCA, t-SNE, UMAP 고려
3. 분산이 크다 ≠ 예측에 중요하다
→ PCA는 레이블을 보지 않음 → 분류에 중요한 정보가 작은 분산 방향에 있을 수 있음
→ 지도 차원 축소가 필요하면 LDA 고려
4. 이상치에 민감
→ 분산 기반이라 이상치 하나가 주성분 방향을 크게 바꿈
|
6-2-1. “분산이 크다 ≠ 중요하다” 문제
PCA의 가장 큰 약점입니다.
1
2
3
4
5
6
7
| 두 클래스가 분산이 작은 방향으로만 갈라져 있는 데이터
클래스 A: 가로로 길게 퍼진 띠, 세로 위치 +1
클래스 B: 가로로 길게 퍼진 띠, 세로 위치 −1
PCA PC1 = 가로 방향 (분산 최대) → 두 클래스가 완전히 겹침 ❌
LDA = 세로 방향 (클래스 분리 최대) → 두 클래스가 완벽히 분리 ✅
|
해결책 :
1
2
3
4
5
6
7
8
9
10
| from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.decomposition import KernelPCA
# 방법 1: 레이블을 활용하는 지도 차원 축소 (LDA)
lda = LinearDiscriminantAnalysis(n_components=1)
# 방법 2: 비선형 구조 → Kernel PCA
kpca = KernelPCA(n_components=2, kernel='rbf', gamma=0.1)
# 방법 3: PCA의 k를 최종 모델 성능 기준으로 교차 검증 (9-5 참고)
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 비지도학습 / 차원 축소 (특성 추출) |
| 핵심 아이디어 | 분산이 최대인 직교 축(주성분)을 찾아 상위 k개로 투영 |
| 수학적 원리 | 공분산 행렬의 고유값 분해 (실제 구현은 SVD) |
| 스케일링 필요? | ✅ 필수 (분산 기반) |
| 핵심 파라미터 | n_components |
| 실전 사용 | 시각화, 고차원 데이터 전처리, 다중공선성 제거, 노이즈 제거, 이미지 압축 |
8. 다른 알고리즘과 무엇이 다른가
PCA vs LDA
1
2
3
4
5
| PCA: 비지도 — 레이블 없이 "데이터가 가장 넓게 퍼진 방향"
LDA: 지도 — 레이블을 보고 "클래스가 가장 잘 갈라지는 방향"
PCA 최대 성분 수 = min(n, p)
LDA 최대 성분 수 = 클래스 수 − 1 (이진 분류면 1개)
|
| 항목 | PCA | LDA |
|---|
| 학습 유형 | 비지도 | 지도 |
| 목적 | 분산 최대화 | 클래스 분리 최대화 |
| 레이블 필요 | ❌ | ✅ |
| 최대 차원 | min(n, p) | 클래스 수 − 1 |
| 주 용도 | 압축, 시각화, 전처리 | 분류용 차원 축소, 분류기 |
9. 코드로 보기 — 유방암 데이터 차원 축소
1
2
3
4
5
6
7
8
| from sklearn.decomposition import PCA
pca = PCA(
n_components = 0.95, # int: 주성분 개수 / float(0~1): 누적 설명 분산 비율
svd_solver = 'auto', # SVD 계산 방식
whiten = False, # 주성분마다 분산을 1로 맞출지
random_state = 0
)
|
| Parameter | Default | 역할 | 비고 |
|---|
n_components | None | 남길 주성분 수 | None이면 전부 유지 |
svd_solver | 'auto' | SVD 방식 | 'full', 'randomized', 'arpack' |
whiten | False | 주성분 분산을 1로 정규화 | 일부 모델 입력에 유리 |
random_state | None | 'randomized' solver 시드 | - |
n_components : 가장 중요한 파라미터int (예: 2) : 주성분 개수를 직접 지정 → 시각화는 2 또는 3float (예: 0.95) : 누적 설명 분산이 95%가 되는 최소 개수를 자동 선택None : 모든 주성분 유지 → 설명 분산 확인용
svd_solver : SVD 계산 방식'auto' : 데이터 크기에 따라 자동 선택'randomized' : 대용량 데이터에서 소수의 주성분만 필요할 때 빠름
whiten : 백색화True면 각 주성분을 분산 1로 맞춤 → 이후 모델이 모든 주성분을 동등하게 취급- 정보 손실은 없지만 주성분 간 상대적 중요도(분산 크기) 정보는 사라짐
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
12
| import numpy as np
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.preprocessing import StandardScaler
cancer = load_breast_cancer()
X = pd.DataFrame(cancer.data, columns=cancer.feature_names)
y = cancer.target # 0 = 악성(malignant), 1 = 양성(benign)
# ✅ PCA는 분산 기반 → 스케일링 필수
X_scaled = StandardScaler().fit_transform(X)
print(X.shape)
|
Note: 유방암 데이터는 mean area(평균 약 650)와 mean smoothness(평균 약 0.1)처럼 단위 차이가 수천 배입니다.
스케일링 없이 PCA를 하면 PC1이 사실상 area 계열 특성의 복사본이 됩니다.
9-2. 설명 분산 확인
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
| import matplotlib.pyplot as plt
pca_full = PCA().fit(X_scaled)
ratio = pca_full.explained_variance_ratio_
cum = np.cumsum(ratio)
k95 = np.argmax(cum >= 0.95) + 1
print(f"PC1 설명 분산 : {ratio[0]:.3f}")
print(f"PC1~PC2 누적 : {cum[1]:.3f}")
print(f"95% 도달 주성분 수 : {k95}")
plt.figure(figsize=(9, 4.5))
plt.bar(range(1, 31), ratio, color='steelblue', alpha=0.7, label='개별 설명 분산')
plt.step(range(1, 31), cum, where='mid', color='tomato', lw=2, label='누적 설명 분산')
plt.axhline(0.95, color='gray', ls='--', lw=1)
plt.axvline(k95, color='gray', ls='--', lw=1)
plt.text(k95 + 0.5, 0.5, f'95% → {k95}개', color='gray')
plt.xlabel('주성분 번호'); plt.ylabel('설명 분산 비율')
plt.title('PCA 설명 분산 (Scree Plot)')
plt.legend(loc='center right')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
|
읽는 법:
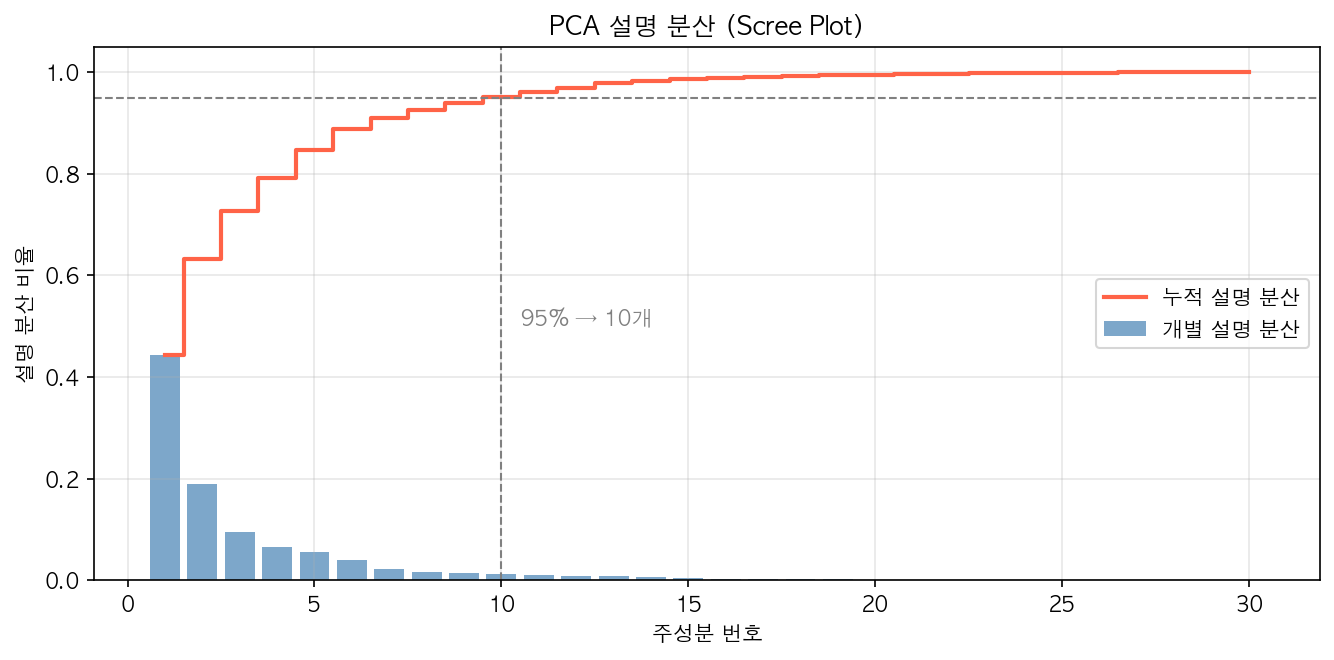
파란 막대는 각 주성분이 설명하는 분산 비율, 빨간 계단선은 누적 비율입니다.
PC1 하나가 전체 분산의 약 44%를 담고, 뒤로 갈수록 막대가 급격히 작아집니다. 30개 특성의 정보가 소수의 방향에 몰려 있다는 뜻입니다.
회색 점선은 누적 95%에 도달하는 지점으로, 30개 중 10개 주성분만으로 정보의 95%를 보존할 수 있습니다.
9-3. 모델 학습 (2차원 투영)
1
2
3
4
5
| pca = PCA(n_components=2)
X_2d = pca.fit_transform(X_scaled)
print(X_2d.shape)
print(f"2개 주성분 누적 설명 분산 : {pca.explained_variance_ratio_.sum():.3f}")
|
9-4. 2차원 시각화와 주성분 해석
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
| fig, axes = plt.subplots(1, 2, figsize=(14, 5.5))
# 왼쪽: 2차원 투영
for label, color, name in [(0, 'tomato', '악성 (0)'), (1, 'steelblue', '양성 (1)')]:
axes[0].scatter(X_2d[y == label, 0], X_2d[y == label, 1], c=color, s=15, alpha=0.6, label=name)
axes[0].set_xlabel(f'PC1 ({pca.explained_variance_ratio_[0]*100:.1f}%)')
axes[0].set_ylabel(f'PC2 ({pca.explained_variance_ratio_[1]*100:.1f}%)')
axes[0].set_title('30차원 → 2차원 PCA 투영')
axes[0].legend(); axes[0].grid(True, alpha=0.2)
# 오른쪽: PC1 로딩 상위 10개 (어떤 특성이 PC1을 만드는가)
loading = pd.Series(pca.components_[0], index=cancer.feature_names)
top = loading.abs().sort_values(ascending=False).head(10).index
loading[top].sort_values().plot(kind='barh', ax=axes[1], color='tomato')
axes[1].set_title('PC1 로딩 상위 10개 특성')
axes[1].set_xlabel('Loading (가중치)')
axes[1].grid(True, axis='x', alpha=0.3)
plt.tight_layout()
plt.show()
|
읽는 법:
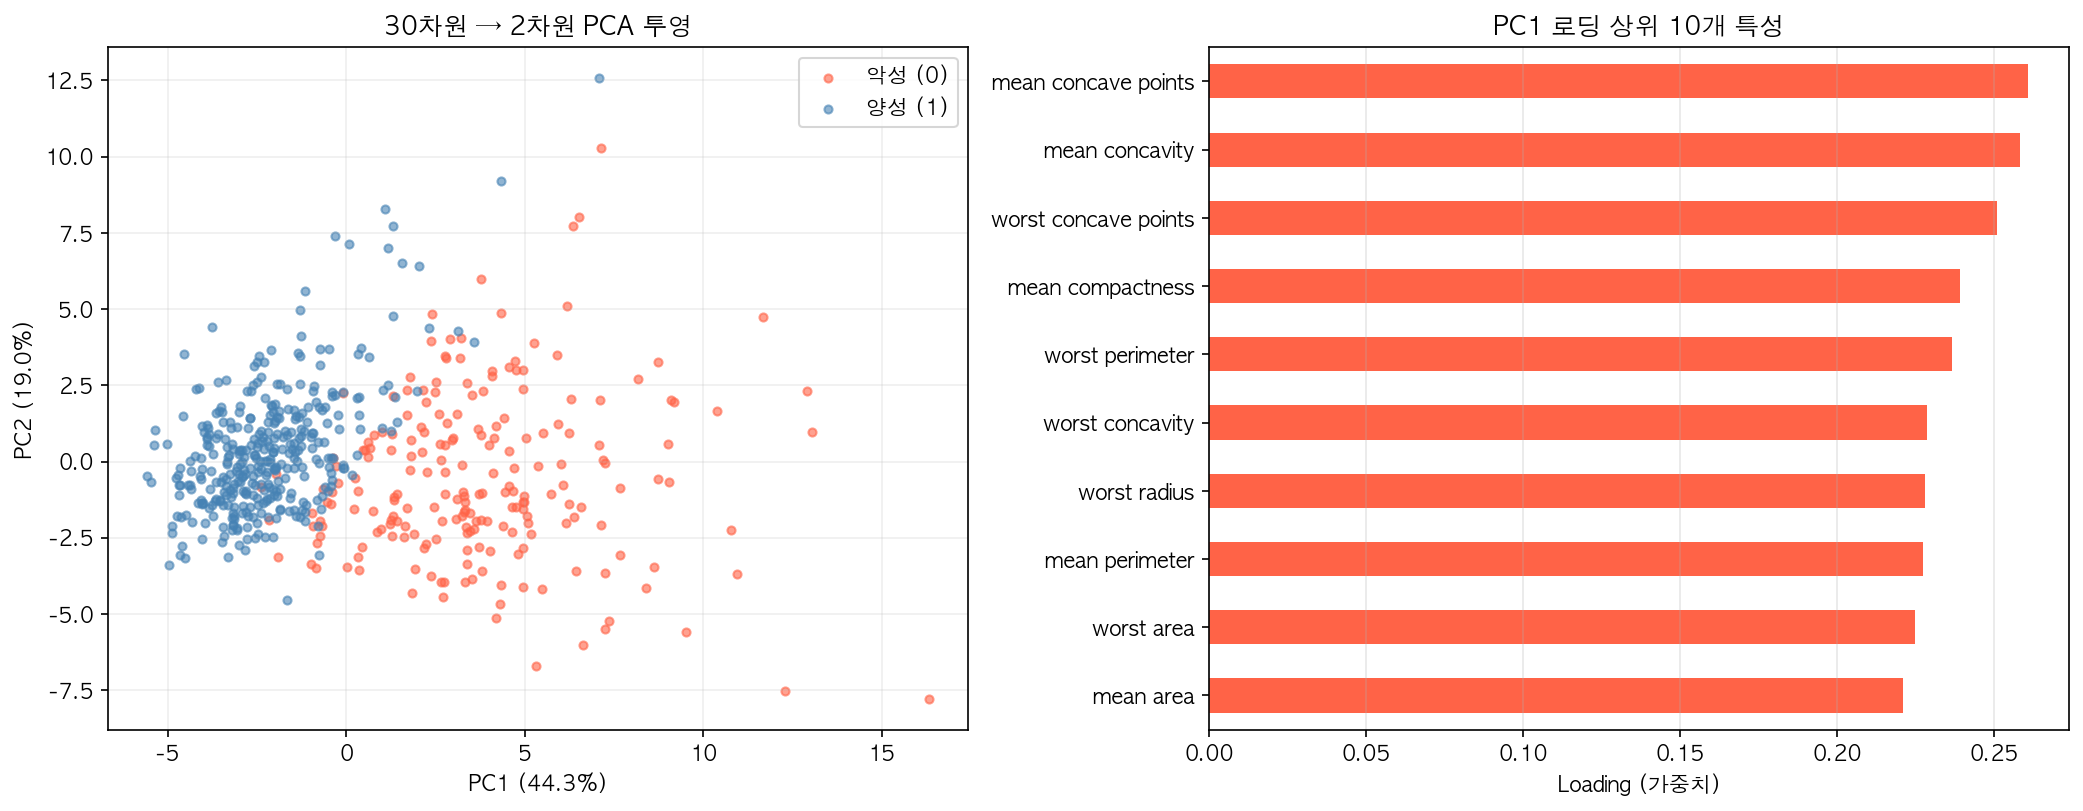
왼쪽 — 레이블을 전혀 사용하지 않았는데도 PC1 축을 따라 악성(빨강)과 양성(파랑)이 뚜렷하게 갈라집니다. 이 데이터에서는 “분산이 가장 큰 방향”이 마침 “진단에 중요한 방향”과 겹친 것입니다.
오른쪽 — PC1을 구성하는 가중치 상위 10개 특성입니다. 오목한 점(concave points), 둘레, 반지름, 면적 등 종양의 크기·모양 관련 특성이 고르게 섞여 있어, PC1은 “종양의 크기와 불규칙성 종합 점수”로 해석할 수 있습니다.
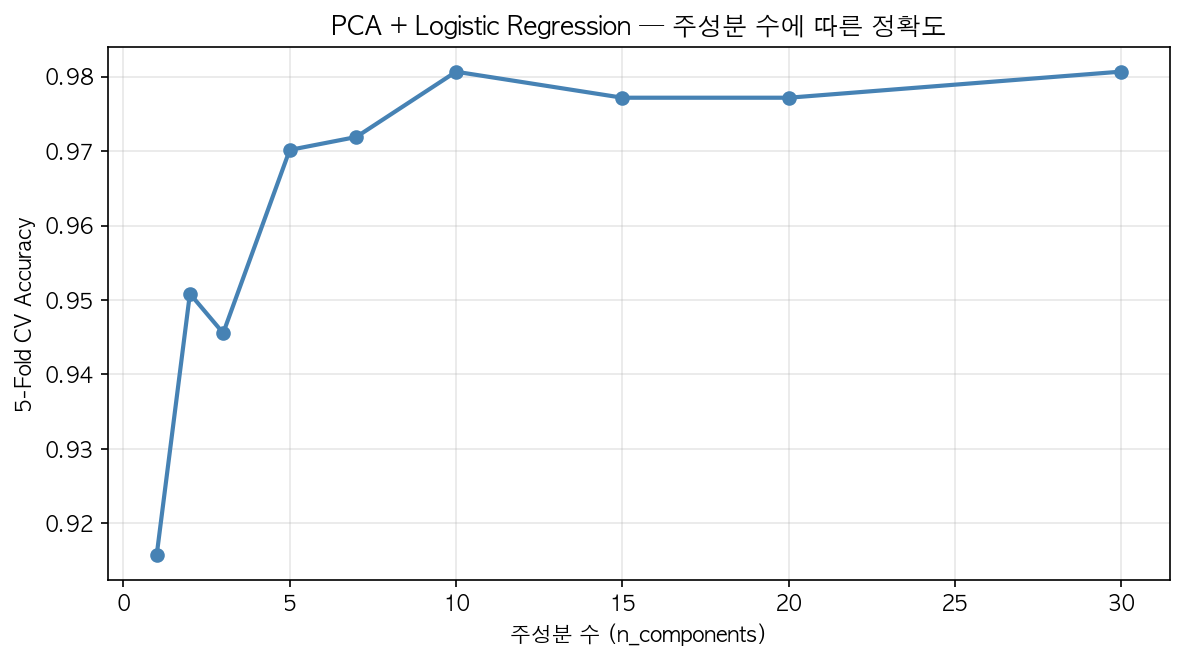
9-5. PCA + 분류 모델 (주성분 수에 따른 성능)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
k_list = [1, 2, 3, 5, 7, 10, 15, 20, 30]
scores = []
for k in k_list:
pipe = make_pipeline(StandardScaler(), PCA(n_components=k), LogisticRegression(max_iter=1000))
scores.append(cross_val_score(pipe, X, y, cv=5, scoring='accuracy').mean())
plt.figure(figsize=(8, 4.5))
plt.plot(k_list, scores, 'o-', color='steelblue', lw=2)
plt.xlabel('주성분 수 (n_components)')
plt.ylabel('5-Fold CV Accuracy')
plt.title('PCA + Logistic Regression — 주성분 수에 따른 정확도')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
for k, s in zip(k_list, scores):
print(f"k = {k:>2} : {s:.4f}")
|
Note: 스케일링과 PCA를 반드시 Pipeline 안에 넣어야 합니다. 교차 검증 바깥에서 전체 데이터로 PCA를 먼저 학습하면 검증 fold의 정보가 주성분에 섞이는 데이터 누수가 생깁니다.
읽는 법:
주성분 1개만 써도 정확도가 91.6%이고, 5개면 97.0%, 10개면 98.1%로 30개 전체를 쓸 때(98.1%)와 같아집니다.
즉, 이 데이터의 30개 특성 중 대부분은 중복 정보였고, 소수의 주성분으로 충분히 진단할 수 있다는 뜻입니다.
실무에서는 이 그래프에서 성능이 거의 떨어지지 않는 가장 작은 k를 골라 모델을 가볍고 빠르게 만듭니다.