1. 왜 등장했는가
Random Forest나 XGBoost는 같은 종류의 모델(트리) 을 여러 개 묶은 앙상블입니다.
하지만 Logistic Regression, KNN, SVM, 트리 모델은 각자 데이터를 보는 방식이 완전히 달라서 틀리는 지점도 서로 다릅니다.
Voting과 Stacking은 이렇게 서로 다른 종류의 모델을 묶어, 한 모델의 약점을 다른 모델이 메우도록 하는 이종(Heterogeneous) 앙상블입니다.
(Stacked Generalization: Wolpert, 1992 / Breiman, 1996)
Bagging·Boosting이 “같은 전공자 여러 명의 회의”라면,
Voting·Stacking은 “전공이 다른 전문가들의 협진” 에 가깝습니다.
2. 핵심 아이디어 — “서로 다르게 틀리는 모델을 모은다”
Voting은 여러 모델의 예측을 투표·평균하고, Stacking은 한 걸음 더 나아가 “어떤 모델을 얼마나 믿을지”를 또 다른 모델이 학습합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
| 승객 A에 대한 각 모델의 생존 확률:
Logistic Regression : 0.72
KNN : 0.40
Random Forest : 0.81
SVM : 0.65
Hard Voting : 생존 / 사망 / 생존 / 생존 → 3:1 → 생존
Soft Voting : (0.72 + 0.40 + 0.81 + 0.65) / 4 = 0.645 → 생존
Stacking : 메타 모델이 학습한 가중치로 결합
σ(1.8×0.72 + 0.3×0.40 + 2.5×0.81 + 1.1×0.65 − 3.0) = 0.76 → 생존
→ "이 데이터에서는 RF와 LR을 더 믿어라"를 스스로 학습
|
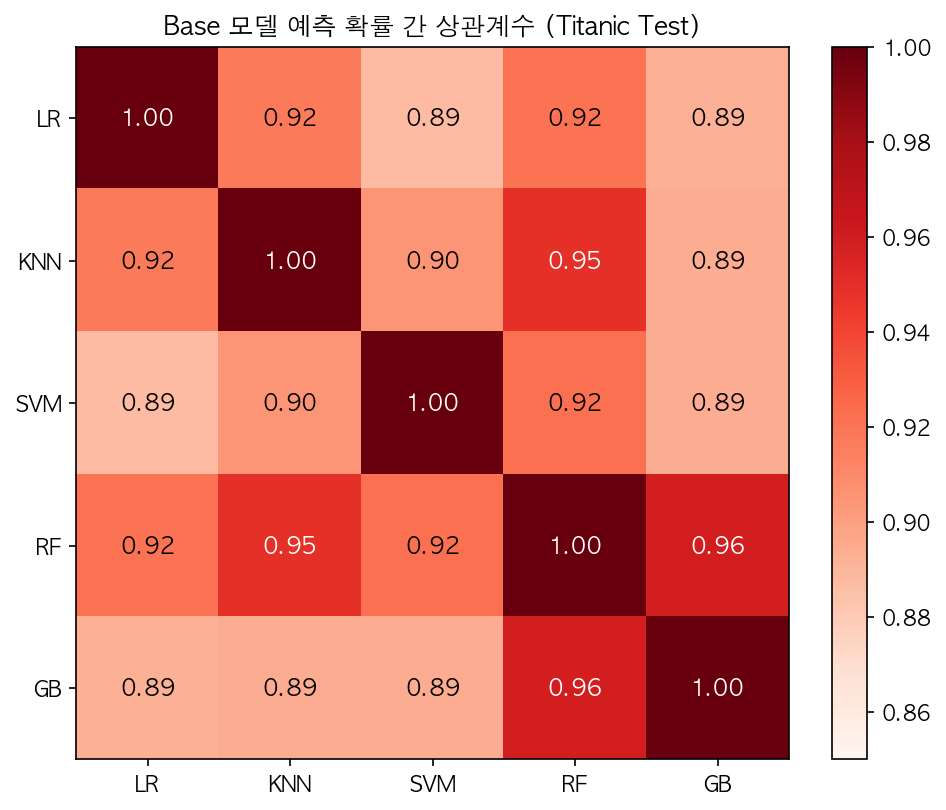
앙상블이 효과를 보려면 각 모델이 어느 정도 정확하면서, 서로 다른 곳에서 틀려야 합니다.
모두 같은 곳에서 틀린다면 아무리 많이 모아도 같은 답만 반복할 뿐입니다.
읽는 법:
타이타닉 테스트 데이터에서 각 모델이 예측한 생존 확률끼리의 상관계수입니다. 1에 가까울수록 두 모델이 “비슷하게 생각한다”는 뜻입니다.
RF–GB(0.96)처럼 같은 트리 계열끼리 상관이 가장 높고, LR·SVM은 트리 모델과의 상관이 0.89~0.92로 상대적으로 낮습니다.
모든 값이 0.89 이상인 것은 다섯 모델 모두 “여성·1등석은 생존”이라는 큰 패턴을 똑같이 잡아내기 때문입니다. 차이는 애매한 승객들에서 생깁니다.
상관이 낮은 모델끼리 묶을수록 서로의 실수를 보완해 앙상블 효과가 커집니다.
3. 실제 예시로 보기 (분류)
예시 1 — 타이타닉 생존 예측 (분류)
1
2
3
4
5
6
7
8
9
10
11
12
| 각 모델이 잘하는 영역:
Logistic Regression : 성별·등급 같은 단순 선형 효과를 안정적으로 포착
KNN : 비슷한 승객(가족 단위 탑승객)끼리의 국소 패턴
Random Forest : "3등석 + 남성 + 성인" 같은 조건 조합(상호작용)
SVM : 경계 근처 애매한 승객 분리
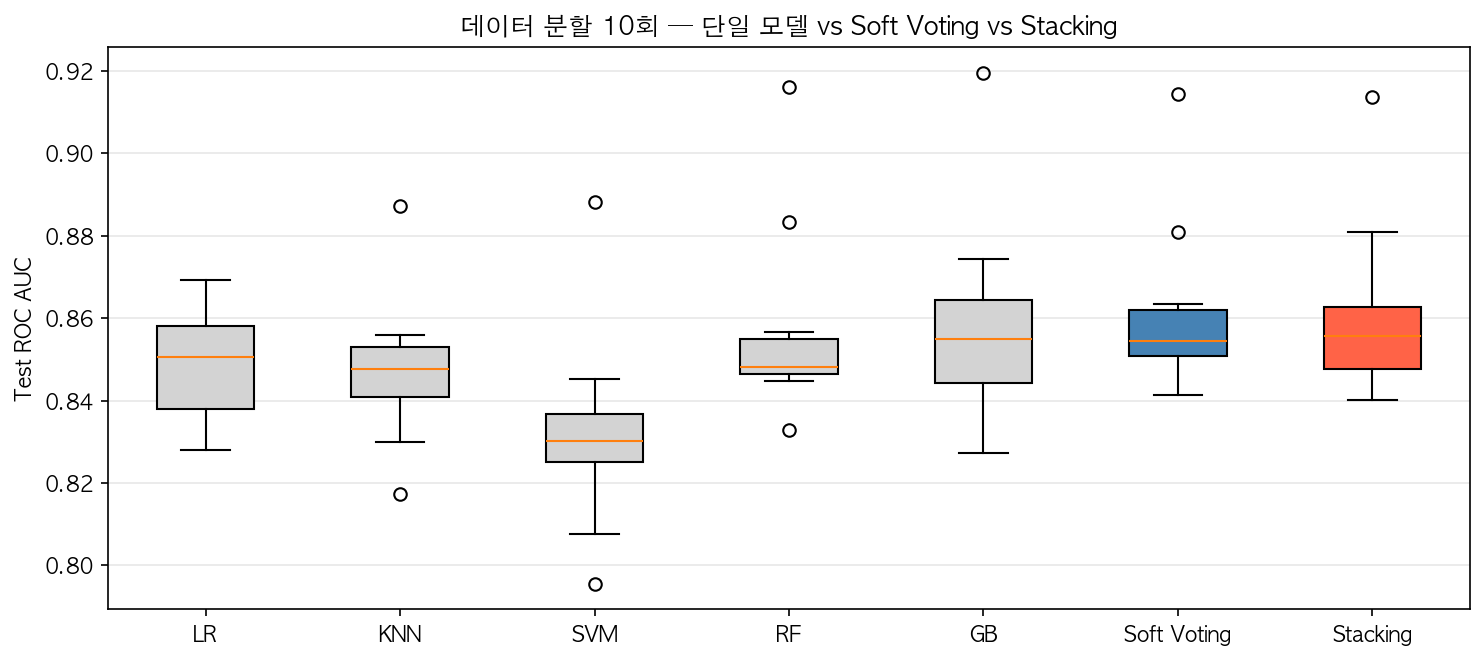
데이터 분할 10번 평균 AUC (9-6 참고):
단일 모델 : 0.832 (SVM) ~ 0.858 (GB)
Soft Voting : 0.862
Stacking : 0.861
→ 분할마다 1등 단일 모델은 바뀌지만, 앙상블은 꾸준히 상위권
|
예시 2 — Kaggle 대회 (분류 / 회귀)
1
2
3
4
5
6
7
8
9
10
| Kaggle 상위권 솔루션의 전형적인 구조:
Level 0 (Base): LightGBM, XGBoost, CatBoost, NN, Ridge ... (수십 개)
↓ Out-of-Fold 예측값
Level 1 (Meta): Logistic Regression 또는 얕은 LightGBM
↓
최종 제출
→ 리더보드 0.001 차이를 다투는 대회에서 Stacking은 거의 필수
→ 실무에서는 운영 복잡도 때문에 Voting 또는 단일 모델을 선호하는 경우가 많음
|
4. 알고리즘 구성 요소
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| ┌───────────────────────────────────────────────────────┐
│ 훈련 데이터 │
└───────┬──────────────┬──────────────┬────────────────┘
▼ ▼ ▼
[Logistic] [KNN] [RF] ... ← Base 모델 (Level 0)
│ │ │
▼ ▼ ▼
┌───────────────────────────────────────────────────────┐
│ Voting : 예측을 투표(Hard) 또는 확률 평균(Soft) │
│ Stacking: K-Fold Out-of-Fold 예측 → 새로운 특성으로 │
└──────────────────────────┬────────────────────────────┘
│ (Stacking만)
▼
┌───────────────────────────────────────────────────────┐
│ 메타 모델 (Level 1) — 보통 Logistic Regression │
│ "각 Base 모델 예측을 어떻게 섞을지" 학습 │
└──────────────────────────┬────────────────────────────┘
▼
최종 예측
|
읽는 법:
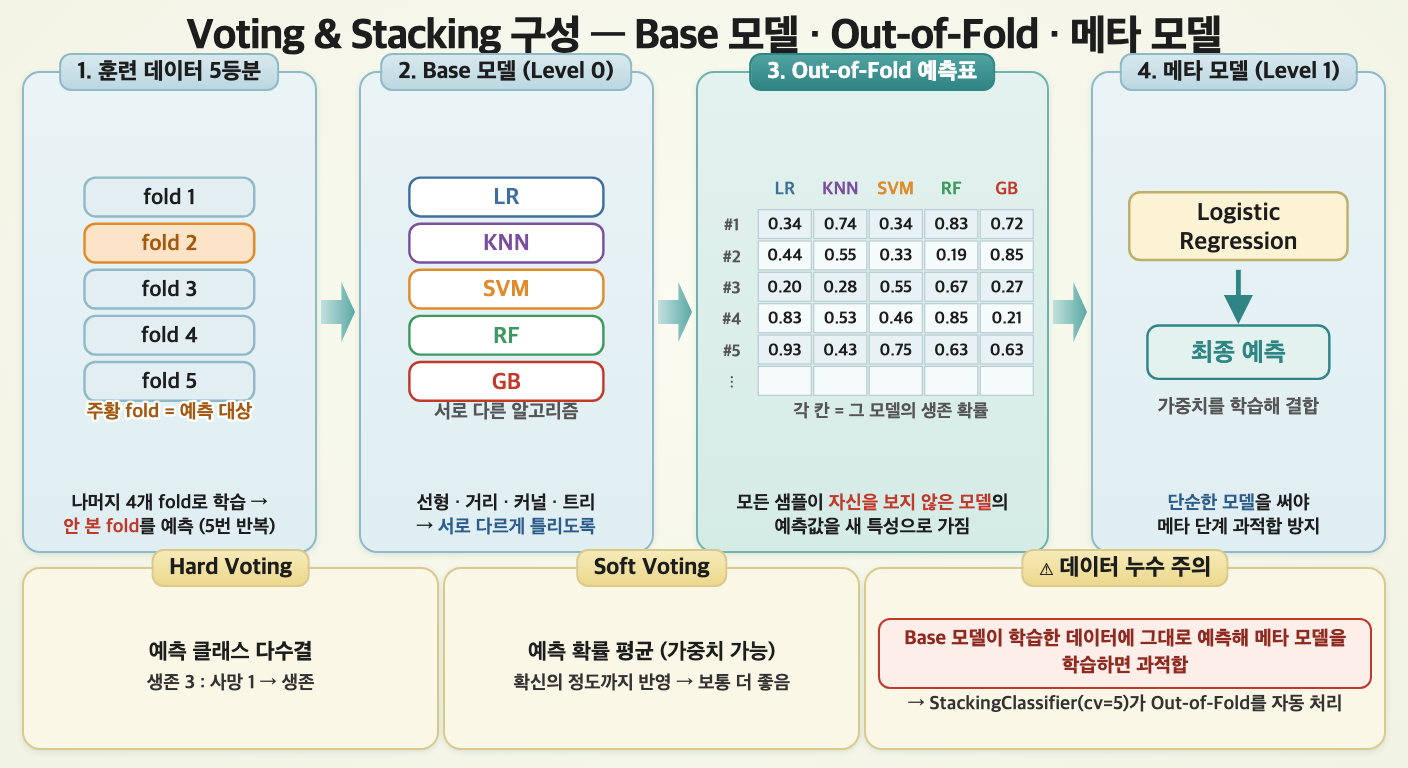
Stacking이 Out-of-Fold 예측으로 메타 모델을 학습하는 과정을 왼쪽부터 순서대로 그린 그림입니다.
1 — 훈련 데이터를 5개 fold로 나누고, 4개로 학습한 모델이 나머지 1개(주황)를 예측합니다. 이를 5번 반복합니다.
2 — 이 과정을 선형·거리·커널·트리 등 서로 다른 Base 모델 5개에 모두 적용합니다.
3 — 그 결과 모든 샘플이 ‘자신을 보지 않은 모델’의 예측 확률 5개를 갖게 되고, 이 표가 메타 모델의 입력 특성이 됩니다.
4 — 메타 모델(Logistic Regression)이 이 표로 각 모델을 얼마나 믿을지 학습해 최종 예측을 냅니다.
아래 칸은 Hard·Soft Voting의 결합 방식과, Stacking에서 가장 조심해야 할 데이터 누수 문제입니다.
| 구성 요소 | 설명 | 비유 |
|---|
| Base 모델 | 서로 다른 알고리즘의 1차 모델 | 각 분야 전문의 |
| Hard Voting | 예측 클래스의 다수결 | 전문의 다수결 |
| Soft Voting | 예측 확률의 평균 | 각자의 확신도까지 반영한 평균 |
| 메타 모델 | Base 예측을 입력받아 최종 예측 | 협진 결과를 종합하는 주치의 |
| Out-of-Fold 예측 | 학습에 쓰지 않은 fold에 대한 예측 | 처음 보는 환자에 대한 진단 기록 |
5. 어떻게 결합하는가
5-1. Hard Voting vs Soft Voting
\[\hat{y}_{hard} = \text{mode}\{h_1(x), h_2(x), ..., h_M(x)\}\] \[\hat{p}_{soft} = \frac{1}{M}\sum_{m=1}^{M} w_m \, p_m(y=1 \mid x)\]
1
2
3
4
5
6
7
8
| 승객 B: LR = 0.51, KNN = 0.52, RF = 0.05
Hard Voting : 생존 / 생존 / 사망 → 2:1 → 생존
Soft Voting : (0.51 + 0.52 + 0.05) / 3 = 0.36 → 사망
→ Hard는 "겨우 넘긴 0.51"과 "확신하는 0.95"를 똑같이 한 표로 계산
→ Soft는 확신의 정도를 반영 → 보통 Soft Voting이 더 좋음
(단, 모든 모델이 predict_proba를 지원하고 확률이 어느 정도 보정되어 있어야 함)
|
5-2. Stacking과 Out-of-Fold 예측
1
2
3
4
5
6
7
8
9
10
11
12
13
14
| ⚠️ 잘못된 방법: Base 모델을 전체 훈련 데이터로 학습 → 같은 데이터에 예측 → 메타 모델 학습
→ Base 모델이 이미 "답을 본" 데이터의 예측이라 지나치게 정확
→ 메타 모델이 과적합된 Base 모델(예: 깊은 트리)을 과하게 신뢰 → 테스트에서 성능 하락
✅ 올바른 방법 (K-Fold Out-of-Fold):
훈련 데이터를 5개 fold로 분할
fold 1 예측 ← fold 2~5로 학습한 모델
fold 2 예측 ← fold 1,3~5로 학습한 모델
...
→ 모든 훈련 샘플이 "자신을 보지 않은 모델"의 예측값을 갖게 됨
→ 이 예측값들로 메타 모델 학습
Base 모델은 마지막에 전체 훈련 데이터로 다시 학습해 테스트 예측에 사용
(sklearn StackingClassifier가 cv 파라미터로 자동 처리)
|
5-3. 메타 모델은 단순하게
1
2
3
4
5
| 메타 모델 입력: Base 모델 수만큼의 특성 (예: 5개)
→ 특성 수가 적고, 서로 강하게 상관됨
복잡한 메타 모델(깊은 트리 등) → 과적합 위험
단순한 메타 모델(Logistic Regression, Ridge) → 가중 평균에 가까운 안정적 결합 ✅
|
6. Voting & Stacking 장・단점
6-1. ✅ Voting & Stacking 장점
1
2
3
4
5
6
7
8
9
10
11
| 1. 단일 모델보다 안정적인 성능
→ 한 모델이 크게 틀려도 다른 모델이 보완 → 분산 감소
2. 서로 다른 알고리즘의 강점 결합
→ 선형 모델 + 거리 기반 + 트리 모델의 시각을 모두 활용
3. 구현이 간단 (sklearn)
→ VotingClassifier, StackingClassifier로 몇 줄이면 완성
4. Stacking은 결합 가중치를 자동 학습
→ 어떤 모델을 얼마나 믿을지 사람이 정하지 않아도 됨
|
6-2. ❌ Voting & Stacking이 약한 상황
1
2
3
4
5
6
7
8
9
10
11
| 1. 학습·예측 비용 증가
→ 모델 M개 × (Stacking이면 K-Fold로 K+1번 학습) → 시간·메모리 ↑
2. 해석력 상실
→ "왜 이 승객이 생존으로 예측되었는가?" 설명이 어려움
3. Base 모델끼리 너무 비슷할 때
→ RF + ExtraTrees + GB처럼 트리만 묶으면 효과 미미
4. 성능이 크게 떨어지는 모델이 섞일 때
→ Voting은 나쁜 모델도 같은 무게로 반영 → 전체 성능 하락
|
6-2-1. 약한 모델이 섞이는 문제
Voting의 가장 큰 약점입니다.
1
2
3
4
| LR AUC 0.86, RF AUC 0.86, GB AUC 0.85, 아무렇게나 학습된 모델 AUC 0.60
Soft Voting (동일 가중치) : 0.60 모델이 평균을 끌어내림
Stacking : 메타 모델이 0.60 모델의 가중치를 작게 학습 → 영향 최소화
|
해결책 :
1
2
3
4
5
6
7
8
9
10
| from sklearn.ensemble import VotingClassifier, StackingClassifier
from sklearn.linear_model import LogisticRegression
# 방법 1: Voting에 가중치 부여 (성능 좋은 모델에 더 큰 가중치)
# voting = VotingClassifier(estimators, voting='soft', weights=[2, 1, 2, 2, 1])
# 방법 2: Stacking으로 가중치를 자동 학습
# stacking = StackingClassifier(estimators, final_estimator=LogisticRegression(), cv=5)
# 방법 3: 각 모델을 교차 검증으로 먼저 평가하고 성능이 낮은 모델은 제외
|
7. 한눈에 요약
| 항목 | 내용 |
|---|
| 알고리즘 유형 | 지도학습 / 분류 · 회귀 (이종 앙상블) |
| 핵심 아이디어 | 서로 다른 모델의 예측을 투표(Voting) 또는 메타 모델(Stacking)로 결합 |
| Voting | Hard(다수결) / Soft(확률 평균), 가중치 지정 가능 |
| Stacking | Out-of-Fold 예측 → 메타 모델이 결합 방식 학습 |
| 스케일링 필요? | Base 모델에 따라 다름 (LR·KNN·SVM은 Pipeline으로 스케일링) |
| 핵심 파라미터 | estimators, voting, weights, final_estimator, cv |
| 실전 사용 | Kaggle 대회, 성능을 마지막까지 끌어올려야 할 때 |
8. 다른 알고리즘과 무엇이 다른가
Bagging vs Boosting vs Voting vs Stacking
1
2
3
4
| Bagging (RF) : 같은 모델 × 다른 데이터 샘플 → 병렬 학습 → 평균 (분산 ↓)
Boosting (GB, XGB) : 같은 모델 × 이전 오차에 집중 → 순차 학습 → 가중 합 (편향 ↓)
Voting : 다른 모델 × 같은 데이터 → 병렬 학습 → 투표/평균 (분산 ↓)
Stacking : 다른 모델 × 같은 데이터 → 병렬 학습 → 메타 모델 (분산 ↓, 편향 ↓)
|
| 항목 | Bagging | Boosting | Voting | Stacking |
|---|
| Base 모델 | 같은 종류 | 같은 종류 | 다른 종류 | 다른 종류 |
| 학습 방식 | 병렬 | 순차 | 병렬 | 병렬 + 메타 |
| 결합 방식 | 평균/투표 | 가중 합 | 평균/투표 | 학습된 모델 |
| 대표 구현 | RandomForestClassifier | XGBClassifier | VotingClassifier | StackingClassifier |
9. 코드로 보기 — 타이타닉 생존 예측
1
2
3
4
5
6
7
8
9
10
11
| from sklearn.ensemble import VotingClassifier, StackingClassifier
from sklearn.linear_model import LogisticRegression
stacking = StackingClassifier(
estimators = [...], # (이름, 모델) 리스트
final_estimator = LogisticRegression(), # 메타 모델
cv = 5, # Out-of-Fold 예측용 fold 수
stack_method = 'predict_proba', # Base 모델이 넘겨줄 값
passthrough = False, # 원본 특성도 메타 모델에 넘길지
n_jobs = -1
)
|
| Parameter | Default | 역할 | 과적합 방향 |
|---|
estimators | (필수) | Base 모델 목록 [(이름, 모델), ...] | - |
voting (Voting) | 'hard' | 'hard' 다수결 / 'soft' 확률 평균 | - |
weights (Voting) | None | 모델별 가중치 | - |
final_estimator (Stacking) | LogisticRegression() | 메타 모델 | 복잡할수록 과적합 ↑ |
cv (Stacking) | 5 | Out-of-Fold fold 수 | 작을수록 과적합 ↑ |
stack_method (Stacking) | 'auto' | Base 모델 출력 형태 | - |
passthrough (Stacking) | False | 원본 특성을 메타 모델에 추가 | True면 과적합 ↑ |
voting : Voting 방식'hard' : 예측 클래스 다수결'soft' : 예측 확률 평균 → 대부분 더 좋음 (모든 모델이 predict_proba 필요)
final_estimator : 메타 모델- 기본값
LogisticRegression 권장 → 단순한 가중 결합 - 트리 계열 메타 모델은 Base 모델이 많고 데이터가 클 때만 고려
stack_method : Base 모델이 메타 모델에 넘기는 값'auto' : predict_proba → decision_function → predict 순으로 사용 가능한 것'predict_proba' : 확률값 (분류에서 가장 일반적)
passthrough : 원본 특성 전달 여부True면 메타 모델이 “어떤 상황에서 어떤 모델을 믿을지”까지 학습 가능하지만 과적합 위험 ↑
9-1. 전처리
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| import pandas as pd
from sklearn.model_selection import train_test_split
titanic = pd.read_csv('./Data/Titanic.csv')
titanic['FamSize'] = titanic['SibSp'] + titanic['Parch']
use_cols = ['Survived', 'Pclass', 'Sex', 'Age', 'FamSize', 'Fare', 'Embarked']
titanic = titanic[use_cols].dropna(subset=['Age'])
titanic['Age'] = titanic['Age'].astype(int)
titanic = pd.get_dummies(titanic, columns=['Pclass', 'Sex', 'Embarked'], drop_first=True)
y = titanic['Survived']
X = titanic.drop('Survived', axis=1)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=0)
# ⚠️ LR·KNN·SVM은 스케일링 필요, 트리는 불필요
# → 스케일링을 각 모델의 Pipeline 안에 넣어 모델별로 처리
|
Note: 이종 앙상블에서는 모델마다 전처리 요구가 다릅니다.
make_pipeline(StandardScaler(), 모델)로 스케일링을 모델 안에 포함시키면, Stacking의 K-Fold 과정에서도 fold마다 스케일링이 따로 적용되어 데이터 누수가 생기지 않습니다.
9-2. Base 모델 정의
1
2
3
4
5
6
7
8
9
10
11
12
13
| from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
estimators = [
('lr', make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))),
('knn', make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=15))),
('svm', make_pipeline(StandardScaler(), SVC(C=1.0, probability=True, random_state=0))),
('rf', RandomForestClassifier(n_estimators=300, max_depth=6, random_state=0, n_jobs=-1)),
('gb', GradientBoostingClassifier(n_estimators=200, learning_rate=0.05, max_depth=3, random_state=0)),
]
|
9-2-1. Voting & Stacking 모델 학습
1
2
3
4
5
6
7
8
9
10
11
12
13
| voting_hard = VotingClassifier(estimators, voting='hard', n_jobs=-1)
voting_soft = VotingClassifier(estimators, voting='soft', n_jobs=-1)
stacking = StackingClassifier(
estimators,
final_estimator = LogisticRegression(),
cv = 5,
stack_method = 'predict_proba',
n_jobs = -1
)
voting_hard.fit(X_train, y_train)
voting_soft.fit(X_train, y_train)
stacking.fit(X_train, y_train)
|
9-3. 평가
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| from sklearn.metrics import (
accuracy_score, confusion_matrix,
classification_report, roc_auc_score
)
pred = stacking.predict(X_test)
pred_prob = stacking.predict_proba(X_test)[:, 1]
cfx = confusion_matrix(y_test, pred)
sensitivity = cfx[1, 1] / (cfx[1, 0] + cfx[1, 1])
specificity = cfx[0, 0] / (cfx[0, 0] + cfx[0, 1])
roc_auc = roc_auc_score(y_test, pred_prob)
print(f"Accuracy : {accuracy_score(y_test, pred) * 100:.2f}%")
print(f"Sensitivity : {sensitivity * 100:.2f}%")
print(f"Specificity : {specificity * 100:.2f}%")
print(f"ROC AUC : {roc_auc:.4f}")
print()
print(classification_report(y_test, pred, target_names=['Died (0)', 'Survived (1)']))
|
9-4. 단일 모델 vs 앙상블 비교
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
| import numpy as np
import matplotlib.pyplot as plt
scores = {}
for name, model in estimators:
model.fit(X_train, y_train)
scores[name.upper()] = (accuracy_score(y_test, model.predict(X_test)),
roc_auc_score(y_test, model.predict_proba(X_test)[:, 1]))
scores['Hard Voting'] = (accuracy_score(y_test, voting_hard.predict(X_test)), np.nan) # 확률 없음
scores['Soft Voting'] = (accuracy_score(y_test, voting_soft.predict(X_test)),
roc_auc_score(y_test, voting_soft.predict_proba(X_test)[:, 1]))
scores['Stacking'] = (accuracy_score(y_test, stacking.predict(X_test)),
roc_auc_score(y_test, stacking.predict_proba(X_test)[:, 1]))
result = pd.DataFrame(scores, index=['Accuracy', 'ROC AUC']).T
print(result.round(4))
colors = ['lightgray'] * len(estimators) + ['steelblue', 'steelblue', 'tomato']
fig, axes = plt.subplots(1, 2, figsize=(13, 4.5))
for ax, col in zip(axes, result.columns):
ax.bar(result.index, result[col], color=colors)
ax.set_ylim(result[col].min() - 0.03, result[col].max() + 0.02)
ax.set_title(f'Test {col}')
ax.tick_params(axis='x', rotation=30)
ax.grid(True, axis='y', alpha=0.3)
plt.suptitle('단일 모델(회색) vs Voting(파랑) vs Stacking(빨강)', fontweight='bold')
plt.tight_layout()
plt.show()
|
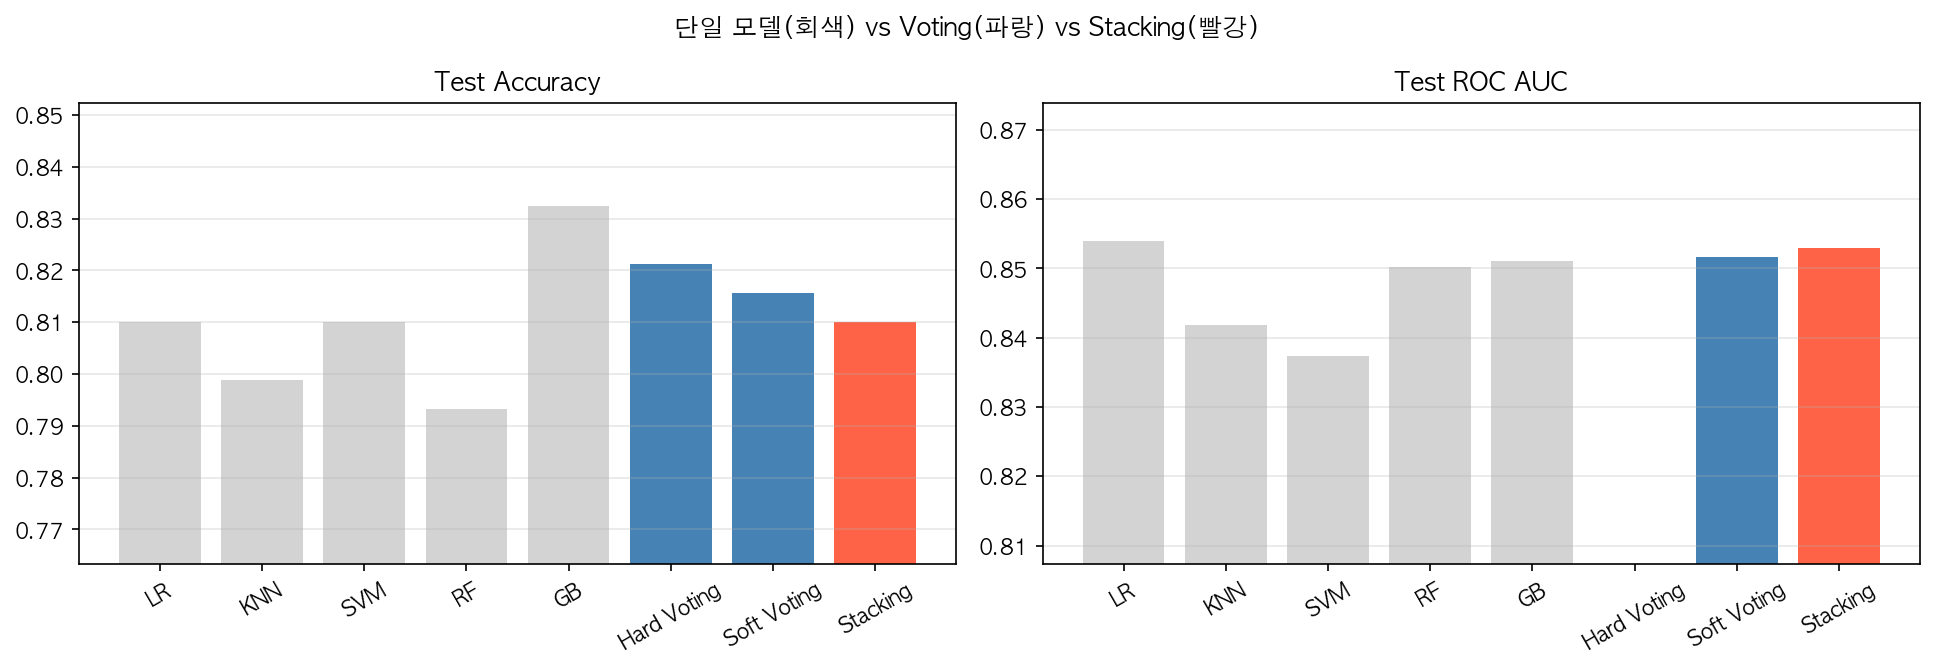
읽는 법:
회색은 단일 모델, 파란색은 Voting, 빨간색은 Stacking입니다. Hard Voting은 확률을 내지 않아 AUC가 없습니다.
이번 분할에서는 정확도는 GB(0.832), AUC는 LR(0.854)이 가장 높았고, 앙상블은 그와 비슷한 수준(AUC 0.852~0.853)입니다.
테스트 데이터가 179명뿐이라 0.01 안팎의 차이는 분할에 따라 쉽게 뒤집힙니다. 한 번의 분할만으로는 앙상블의 장점을 판단하기 어려우므로, 아래 9-6에서 분할을 바꿔가며 다시 비교합니다.
9-5. 메타 모델이 학습한 가중치
1
2
3
4
5
6
7
8
9
10
11
| meta_coef = pd.Series(stacking.final_estimator_.coef_[0],
index=[name.upper() for name, _ in estimators])
plt.figure(figsize=(7, 4))
meta_coef.sort_values().plot(kind='barh', color='tomato')
plt.axvline(0, color='black', lw=0.8)
plt.xlabel('메타 모델(Logistic Regression) 계수')
plt.title('Stacking — 메타 모델이 각 Base 모델을 얼마나 믿는가')
plt.grid(True, axis='x', alpha=0.3)
plt.tight_layout()
plt.show()
|
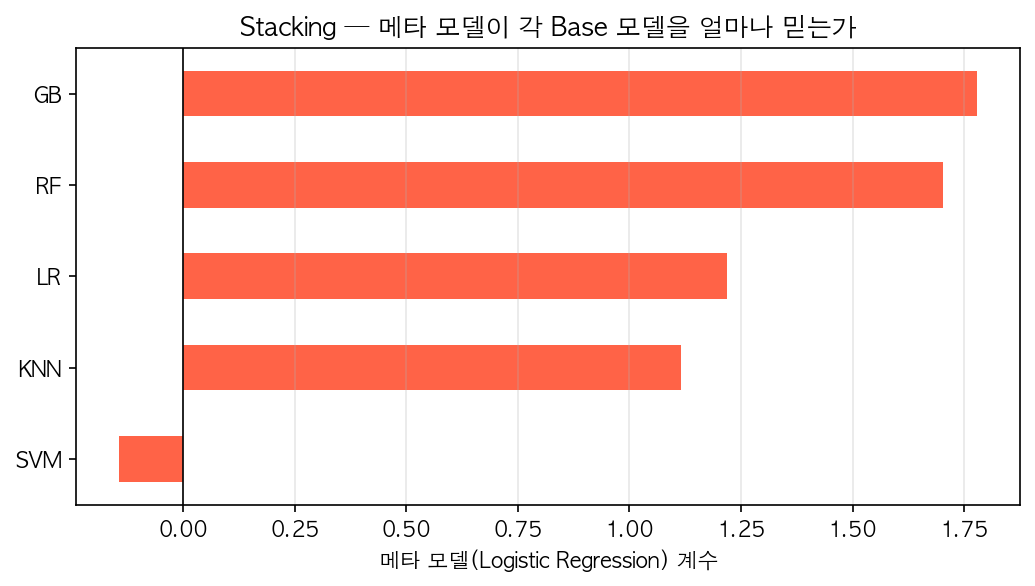
읽는 법:
메타 모델 입력은 각 Base 모델의 생존 확률이므로, 계수가 클수록 해당 모델의 의견을 더 크게 반영한다는 뜻입니다.
이번 결과에서 메타 모델은 GB·RF를 가장 크게, LR·KNN을 그다음으로 반영했고, SVM은 오히려 약간 음수입니다.
단독 AUC가 가장 낮은 SVM은 다른 모델과 정보가 겹치면서 새로 보태는 것이 거의 없어, 메타 모델이 사실상 제외한 것입니다.
이 가중치는 사람이 정한 것이 아니라 Out-of-Fold 예측으로부터 학습된 것이라는 점이 Voting과의 핵심 차이입니다.
9-6. 데이터 분할을 바꿔가며 안정성 비교
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| from sklearn.base import clone
models = {name.upper(): model for name, model in estimators}
models['Soft Voting'] = voting_soft
models['Stacking'] = stacking
auc_runs = {name: [] for name in models}
for seed in range(10):
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=seed)
for name, model in models.items():
m = clone(model).fit(X_tr, y_tr) # 같은 설정, 새로 학습
auc_runs[name].append(roc_auc_score(y_te, m.predict_proba(X_te)[:, 1]))
auc_runs = pd.DataFrame(auc_runs)
print(auc_runs.agg(['mean', 'std', 'min']).T.round(4))
plt.figure(figsize=(10, 4.5))
box = plt.boxplot(auc_runs.values, labels=auc_runs.columns, patch_artist=True)
for patch, c in zip(box['boxes'], colors[:3] + colors[3:5] + ['steelblue', 'tomato']):
patch.set_facecolor(c)
plt.ylabel('Test ROC AUC')
plt.title('데이터 분할 10회 — 단일 모델 vs Soft Voting vs Stacking')
plt.grid(True, axis='y', alpha=0.3)
plt.tight_layout()
plt.show()
|
1
2
3
4
5
6
7
8
| mean std min
LR 0.8483 0.0145 0.8279
KNN 0.8473 0.0182 0.8174
SVM 0.8321 0.0245 0.7955
RF 0.8573 0.0243 0.8329
GB 0.8581 0.0258 0.8273
Soft Voting 0.8618 0.0213 0.8414
Stacking 0.8614 0.0217 0.8401
|
읽는 법:
상자는 10번의 분할에서 얻은 AUC의 분포(가운데 선 = 중앙값)입니다.
Soft Voting과 Stacking은 평균 AUC(0.862, 0.861)와 최저 AUC(0.841, 0.840)가 모두 단일 모델보다 높습니다.
어떤 단일 모델이 1등일지는 분할마다 바뀌지만, 앙상블은 “운 나쁜 분할”에서도 크게 무너지지 않습니다. 이것이 Voting·Stacking을 쓰는 이유입니다.